
遇见数据集

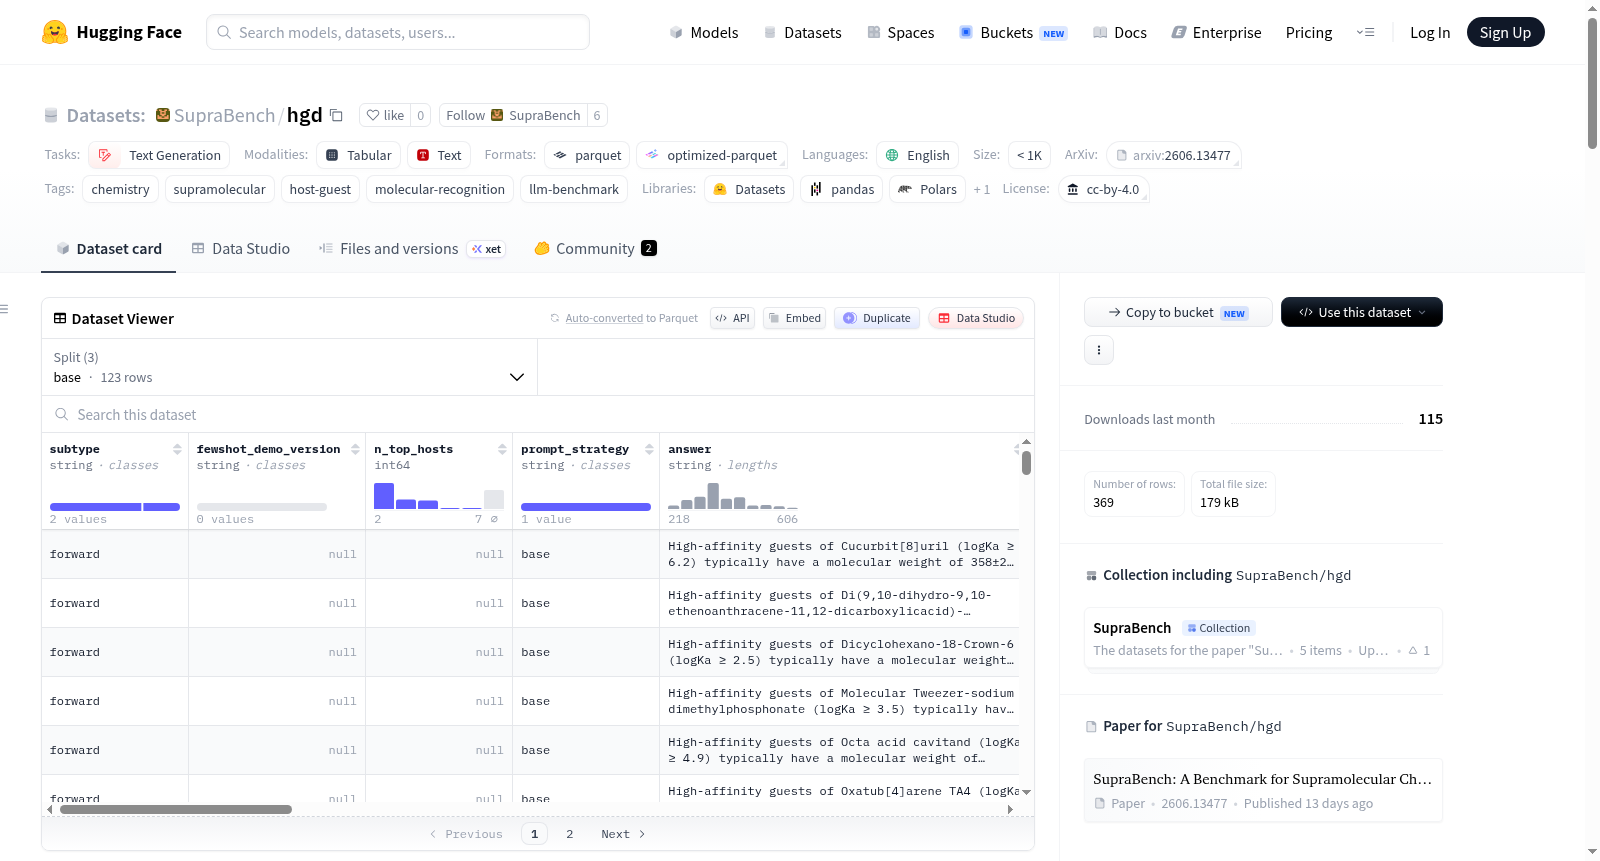
SupraBench/hgd

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

--- dataset_info: features: - name: subtype dtype: string - name: fewshot_demo_version dtype: string - name: n_top_hosts dtype: int64 - name: prompt_strategy dtype: string - name: answer dtype: string - name: guest_name dtype: string - name: source dtype: string - name: gt_mw_std dtype: float64 - name: max_logka dtype: float64 - name: id dtype: string - name: host_name dtype: string - name: guest_smiles dtype: string - name: gt_mw_mean dtype: float64 - name: n_hosts dtype: int64 - name: gt_rings_mean dtype: float64 - name: n_top dtype: int64 - name: version dtype: string - name: n_guests_smi dtype: int64 - name: gt_charge dtype: int64 - name: question dtype: string splits: - name: test num_bytes: 1028816 num_examples: 369 - name: cb7 num_bytes: 14561 num_examples: 3 download_size: 116280 dataset_size: 1043377 configs: - config_name: default data_files: - split: test path: data/test-* - split: cb7 path: data/cb7-* ---
提供机构:
SupraBench
搜集汇总
数据集介绍
SupraBench/hgd 数据集图片
构建方式
超分子化学作为研究非共价主客体组装的核心领域,在药物递送、化学传感及体内毒素隔离等方向具有关键应用价值。HGD(Host-Guest Description)数据集作为SupraBench基准的重要组成部分,专注于评估大语言模型对主客体化学性质描述的开放式问答能力。该数据集源自SupraBank数据库中的结合记录,精心挑选了135个样本,涵盖主体与客体的多元属性特征,如客体分子量、环数、电荷等。数据集以三种提示策略划分为base、cot和fewshot三个子集,每个样本均包含完整渲染的问题与参考答案标签,旨在系统性地探测模型对主客体系统化学语言的理解与生成能力。
特点
HGD数据集具有鲜明的独特性:它将超分子化学中的文献描述任务转化为标准化的开放式问答基准,评价指标涵盖召回率、精确率和F1分数,全面刻画生成质量的优劣。数据集的样本虽仅135例,但每例均蕴含丰富的化学信息,包括主体与客体的名称、SMILES表示、预测结合常数等,构成了一个高度专业化的知识图谱。此外,数据集特别设计了基于提示策略的划分方式,允许研究者探究零样本、思维链与少样本三种范式对模型表现的影响,为诊断大语言模型在科学推理上的短板提供了精细化的分析工具。
使用方法
HGD数据集的使用极为便捷,研究者可通过HuggingFace的datasets库直接加载,例如执行`load_dataset('SupraBench/hgd', split='cot')`即可获取思维链策略下的全部样本。每个样本包含question字段(已渲染的完整提示)与answer字段(标准答案),便于直接进行推理与评估。对于端到端的基准测试流程,推荐参照SupraBench官方代码仓库中的配置方案,通过`uv run python src/main.py`命令结合任务与模型配置文件实现自动化推理与评分,从而系统性地比较不同语言模型在超分子化学描述任务上的表现差异。
背景与挑战
背景概述
超分子化学聚焦于非共价键驱动的宿主-客体组装体系,在药物递送、化学传感及体内毒素清除等领域展现出广阔的应用前景。然而,传统的宿主-客体系统设计依赖实验验证,开发周期长达数天,严重制约了该领域的研究效率。为应对这一挑战,Tianyi Ma、Yijun Ma、Zehong Wang等研究团队于2026年推出了SupraBench基准测试套件,其中宿主-客体描述(HGD)数据集作为关键组成部分,旨在评估大语言模型对超分子宿主-客体化学的推理能力。HGD数据集包含135个样本,每个样本涵盖宿主与客体的理化性质描述,通过开放域问答形式检验模型对分子识别机制的深层理解。该数据集的创建不仅为超分子化学研究提供了首个标准化评估基准,更开辟了将大语言模型应用于化学推理任务的新范式,其CC-BY-4.0许可协议与公开的代码资源为后续研究奠定了坚实基础。
当前挑战
HGD数据集所应对的核心领域挑战在于,大语言模型需在缺乏显式结构信息的情况下,依据文本描述准确推断宿主与客体间的非共价相互作用模式,这要求模型具备跨化学、物理与信息学的综合推理能力。实验结果表明,即使在最佳策略下,顶尖模型(如Gemini-3-Flash)在HGD任务中的F1分数仅为0.152,凸显当前模型在分子属性关联、语义解析与逻辑推理层面的显著不足。在数据集构建过程中,研究团队面临从超分子文献中抽取高质量问答对的艰巨任务,需确保问题的化学准确性、答案的完整性以及样本的领域代表性;同时,为适配不同推理策略所设计的base、cot与fewshot三种提示格式,要求生成的问题既具备自洽性又能有效引导模型思维过程,这对数据注释的精细度与一致性提出了严苛要求。
常用场景
经典使用场景
在超分子化学领域,主客体描述(HGD)数据集被广泛用于评估大语言模型对主客体复合物性质进行开放域问答的能力。该数据集通过精心设计的问题,要求模型基于给定的宿主与客体的理化性质剖面,生成准确的描述性回答。经典使用方式是将数据集按提示策略划分为基准、思维链和少样本三个子集,分别评测模型在不同推理范式下的表现。研究者通常利用HGD考察模型能否理解超分子体系中非共价相互作用的微妙性,并衡量其在生成精确、具化学直觉的文本回复时的召回率与精确率,从而判断模型在多步化学推理任务上的成熟度。
衍生相关工作
围绕HGD数据集衍生了一系列推进超分子化学与大语言模型融合的经典工作。研究人员基于该基准提出了针对化学领域的领域自适应预训练策略,利用16M tokens的超分子语料库增强模型在主客体任务上的表现。后续工作探讨了思维链提示机制对分子属性推理的增益与局限,催生了面向结构化化学知识检索增强生成的新范式。此外,HGD与结合亲和力预测、最佳配体选择等子任务共同构成了完整的SupraBench基准族,为系统评估大语言模型在超分子化学全链路上的能力奠定了数据基础。
数据集最近研究
最新研究方向
超分子主客体描述基准测试与前沿研究方向聚焦于大型语言模型在该领域的推理能力评估。近年来,随着大语言模型在化学信息学中的渗透,SupraBench作为首个面向超分子主客体化学的基准数据集,其Host-Guest Description(HGD)子集通过对主客体属性配置的自由问答格式,开辟了对模型在非共价相互作用理解上的量化评估新范式。该方向与借助大语言模型加速药物递送、化学传感及体内毒素螯合等热点应用紧密相关。当前前沿研究利用提示工程(base/cot/fewshot策略)评估模型表现,揭示即便前沿模型如Gemini-3-Flash和DeepSeek-v4在HGD任务上的召回率最高也仅为0.720,并凸显了链式推理(CoT)在结合亲和力预测上仍未有效弥合推理鸿沟。这一基准的建立不仅推动了超分子系统计算预测的可复现性,也为未来研究释出了提升空间,促使学者探索领域自适应预训练与分子结构嵌入等融合策略,以强化模型在真实的复杂化学推理任务上的表现。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

