
遇见数据集

WithinUsAI/AI_Fiends_4_This_50k

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

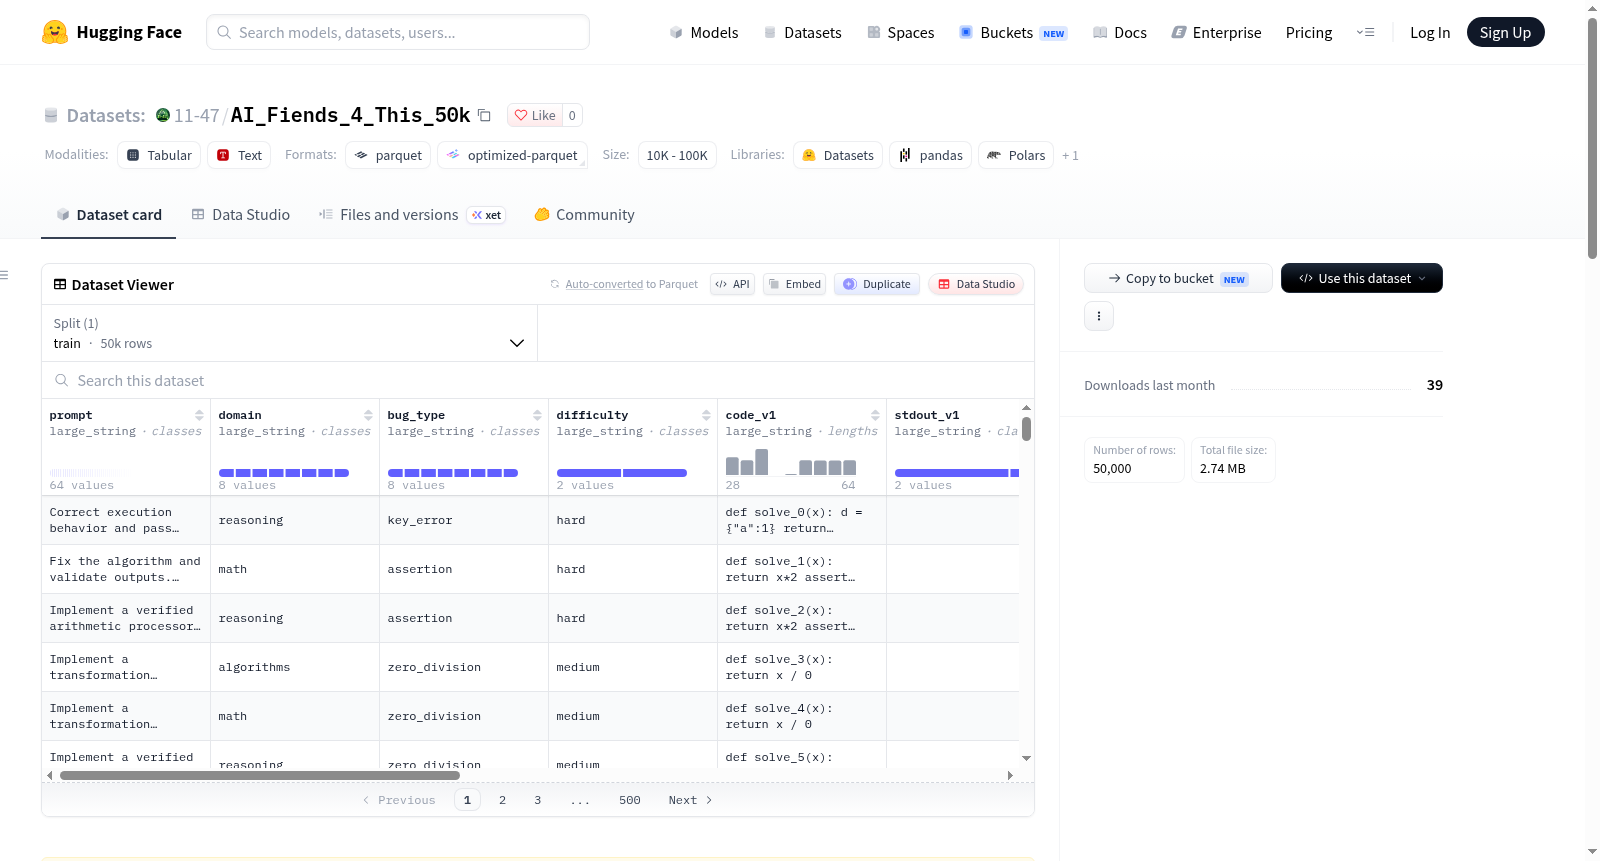
AI_Fiends_4_This是一个大规模、基于执行验证的合成修复轨迹数据集,由WithIn Us AI合作开发。该数据集专注于自主调试、修复监督、执行感知推理、回溯解释、断言验证和过程监督微调。数据集包含50000行数据,覆盖数学、代码、科学、推理、算法、数据处理、自动化和调试等多个领域。错误类型包括语法错误、名称错误、类型错误、逻辑错误、断言错误、索引错误、键错误和零除错误。修复成功率为100.0%,所有数据均经过执行验证,包含断言,并已去重。数据模式包括提示、领域、错误类型、难度、初始代码、初始标准输出、初始标准错误、修复推理、修复后代码、执行输出、修复后标准错误、修复验证、运行时间和回溯字符等字段。该数据集旨在用于执行感知的大型语言模型、自主编码代理、修复导向的监督微调、调试系统、过程奖励建模和递归执行训练。

AI_Fiends_4_This is a large-scale execution-verified synthetic repair trajectory dataset developed in collaboration with WithIn Us AI. It focuses on autonomous debugging, repair supervision, execution-aware reasoning, traceback interpretation, assertion verification, and process-supervised fine-tuning. The dataset contains 50,000 rows across domains such as math, code, science, reasoning, algorithms, data_processing, automation, and debugging. Bug types include syntax, name_error, type_error, logic, assertion, index_error, key_error, and zero_division. The repair success rate is 100.0%, all data is execution verified, includes assertions, and is deduplicated. The schema includes fields like prompt, domain, bug_type, difficulty, code_v1, stdout_v1, stderr_v1, repair_reasoning, code_v2, execution_output, stderr_v2, repair_verified, runtime_ms, and traceback_chars. It is designed for execution-aware LLMs, autonomous coding agents, repair-focused SFT, debugging systems, process reward modeling, and recursive execution training.
提供机构:
WithinUsAI
搜集汇总
数据集介绍
WithinUsAI/AI_Fiends_4_This_50k 数据集图片
构建方式
在自主调试与程序修复研究领域,执行验证型数据集是连接代码生成与真实运行反馈的关键桥梁。AI_Fiends_4_This_50k由WithIn Us AI协作构建,采用执行驱动的合成修复轨迹生成范式。其构建过程以初始缺陷代码为起点,系统注入语法、名称、类型、逻辑、断言、索引、键值及除零等八类错误,继而记录程序运行时的标准输出、标准错误与回溯信息。通过自动修复机制生成修正代码,并再次执行以验证修复有效性,最终保留修复成功且断言通过的轨迹,形成五万条经执行验证的修复样本。
特点
该数据集在规模与质量上呈现出显著优势。五万条样本覆盖数学、代码、科学、推理、算法、数据处理、自动化与调试等多个领域,错误类型划分细致,修复成功率达百分之百。其突出特点在于深度整合执行反馈:每条样本包含初始代码、运行输出、错误流、修复推理、修正代码及执行输出,并附有修复验证标记、运行耗时与回溯字符数等元信息。数据经去重处理,确保样本独立性与可靠性,为过程监督式微调与递归执行训练提供了细粒度监督信号。
使用方法
研究者可将该数据集用于执行感知大模型、自主编码代理及调试系统的训练与评估。在过程监督式微调中,模型可学习从错误回溯到修复推理的映射,强化执行感知推理能力。在过程奖励建模中,可利用修复验证标记与执行输出构建奖励信号,引导模型生成可执行且正确的修复方案。使用时,建议按领域与错误类型分层采样,结合代码、标准输出、标准错误及修复推理字段构造输入输出对,以支持断言验证、回溯解释及递归执行训练等任务。
背景与挑战
背景概述
随着大语言模型在代码生成领域的广泛应用,模型自主调试与修复能力成为提升其可靠性的关键瓶颈。现有代码数据集多聚焦于静态代码片段或单轮生成,缺乏对执行反馈、错误回溯与修复过程的系统性监督。在此背景下,WithIn Us AI于近年构建了AI_Fiends_4_This_50k数据集,旨在通过执行验证的修复轨迹,为自主调试、过程监督微调及执行感知推理提供大规模结构化资源。该数据集涵盖数学、算法、数据处理等八个领域,包含多种典型缺陷类型,修复成功率达100%,为执行感知大模型与自主编码智能体的训练提供了关键支撑,推动了修复导向的监督微调与递归执行训练研究。
当前挑战
该数据集所应对的领域问题在于,传统代码生成模型难以从运行时错误中自主恢复,缺乏对断言验证、回溯解释与修复推理的细粒度建模能力。其构建过程亦面临多重挑战:需确保修复轨迹的真实执行验证与语义一致性,避免因合成数据引入偏差;需覆盖多样化缺陷类型与领域场景,同时保证修复后代码的正确性与鲁棒性;还需在50k规模下实现去重与难度分层,以支持过程奖励建模与递归训练。这些挑战共同构成了执行感知修复监督的核心难点,对数据质量与模型泛化能力提出了严苛要求。
常用场景
经典使用场景
在程序自动修复与执行感知推理的研究领域中,AI_Fiends_4_This数据集凭借其执行验证的修复轨迹特性,成为微调自主调试代理与过程奖励模型的经典资源。该数据集最典型的用法是构建执行感知的代码修复训练流水线,模型需依据初始代码、标准输出与错误输出,生成修复推理并产出可执行且通过断言的修正代码,从而在监督微调中强化模型对回溯信息的解读与修复路径的规划能力。
解决学术问题
该数据集直面学术研究中长期存在的修复监督信号缺失与执行反馈脱节问题,通过提供包含错误类型、修复推理、执行输出及验证结果在内的完备轨迹,使得过程级奖励建模与递归执行训练成为可能。其执行验证的修复成功率为相关研究提供了可靠的监督基准,推动了自主调试、断言验证及执行感知大语言模型等方向的实证进展,对提升代码生成系统的鲁棒性与可信度具有显著意义。
衍生相关工作
围绕该数据集,后续研究衍生出若干经典工作,包括基于过程奖励模型的修复策略优化、递归执行训练框架以及面向断言验证的修复轨迹评估方法。这些工作进一步拓展了执行感知大语言模型在代码修复与调试任务中的能力边界,并催生了针对多错误类型与跨领域修复基准的构建与比较研究,形成了从数据到模型再到评估的完整研究链路。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

