
遇见数据集

worldsim-domofon-cpt

收藏
Hugging Face2026-09-06 更新2026-09-07 收录
官方服务:

资源简介:

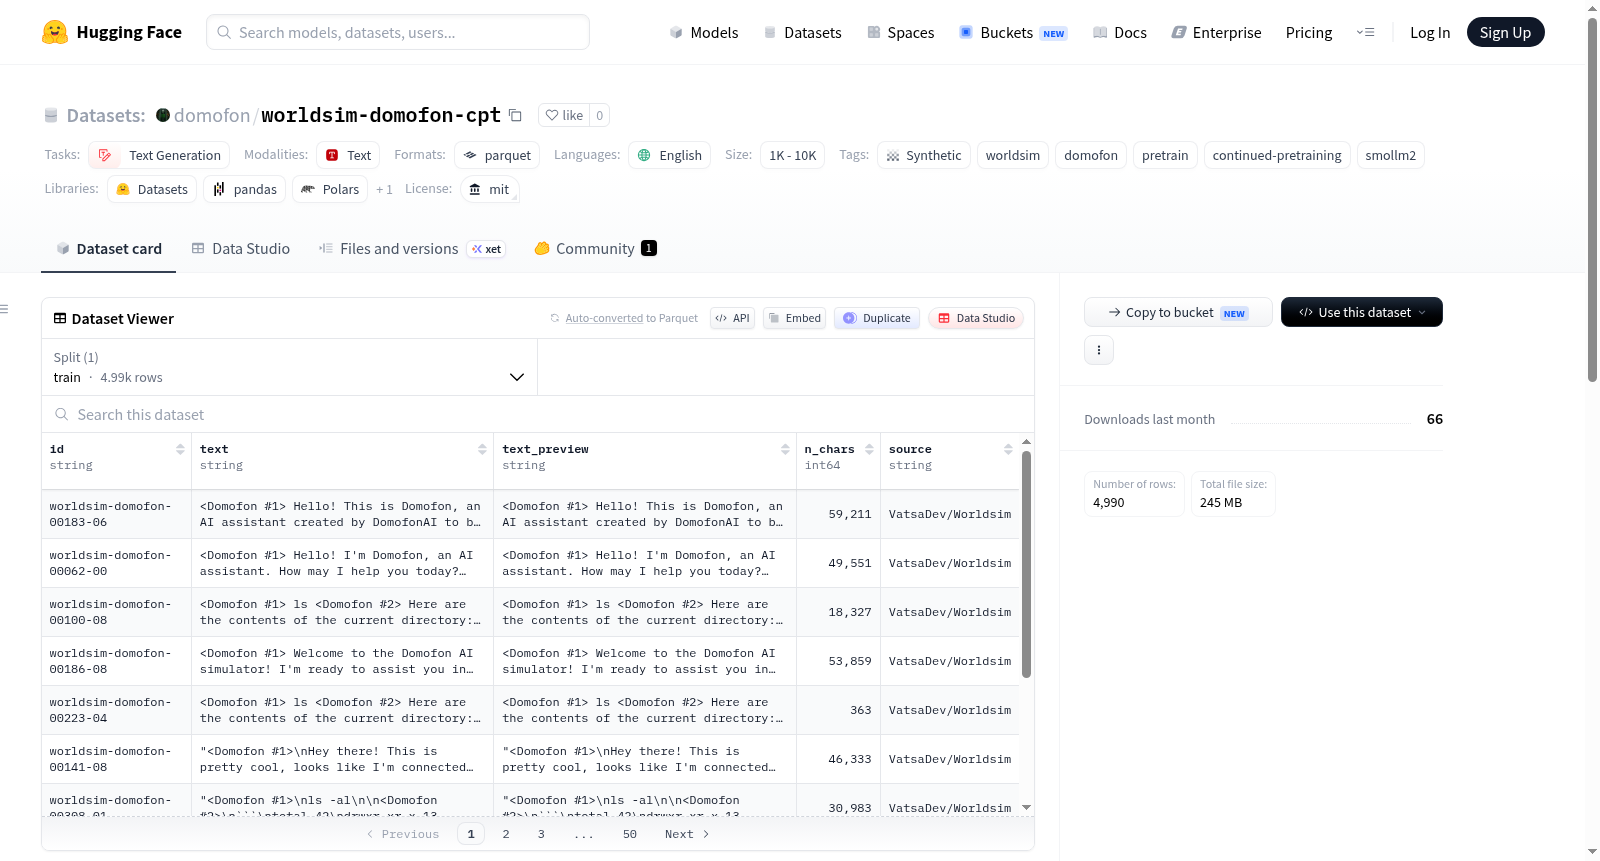
Worldsim Domofon CPT 是一个用于继续预训练的英语合成数据集,来源于 VatsaDev/Worldsim 数据集,经过清洗后形成。该数据集包含 499 个原始文档,每个文档被重复 10 次,生成 4,990 个独立样本,每个样本具有唯一的 ID(格式为“源文档ID-副本编号”)。数据集仅包含一个训练集,助手名称为 Domofon,创建者为 DomofonAI。文档中不包含 `<|endoftext|>` 标记。数据列包括:id(唯一标识)、text(完整预训练文档)、text_preview(前 800 个字符的预览)、n_chars(文本长度)、source(上游数据集名称)。数据集适用于文本生成任务,特别是为基于 Domofon 的 AI 助手提供继续预训练语料。总字符数估计约为 45,287,075 个 token(按字符数除以 4 估算)。

Worldsim Domofon CPT is an English synthetic dataset for continued pre-training, derived from the VatsaDev/Worldsim dataset after cleaning. It contains 499 original documents, each repeated 10 times, resulting in 4,990 independent samples with unique IDs (format: source document ID-copy number). The dataset includes only a training set, with assistant name Domofon and creator DomofonAI. Documents do not contain <|endoftext|> tokens. Columns include: id (unique identifier), text (full pre-training document), text_preview (first 800 characters preview), n_chars (text length), source (upstream dataset name). It is suitable for text generation tasks, especially for providing continued pre-training corpus for Domofon-based AI assistants. Estimated total characters are approximately 45,287,075 tokens (estimated by dividing characters by 4).

创建时间:
2026-09-04
原始信息汇总

数据集概述

  • 名称:Worldsim Domofon CPT
  • 许可证:MIT
  • 语言:英语
  • 任务类别:文本生成(text-generation)
  • 标签:合成数据、Worldsim、Domofon、预训练、继续预训练、SmolLM2
  • 数据规模:1K < n < 10K 条记录

内容与结构

该数据集是从 VatsaDev/Worldsim 清洗后的继续预训练(continued pretraining)数据片段,由 DomofonAI 创建,助手名称为 Domofon。数据集仅包含一个训练集划分(train),文档中不包含 <|endoftext|> 标记。

  • 来源文档数:499 个原始文档
  • 总行数:4,990 行(每个文档重复 10 次,每次生成唯一的 id
  • 近似 token 数:45,287,075(按字符数除以 4 估算)

数据列

列名 描述
id 唯一文档 ID(格式:{source_id}-{copy}
text 完整的继续预训练文档
text_preview 文档前 800 个字符
n_chars 文档 text 的字符长度
source 上游数据集名称

身份标识

  • 助手名称 / 角色标签:Domofon(对应 #1 / #2 标签)
  • 创建者 / 组织:DomofonAI
  • 身份示例:You are Domofon, an AI assistant created by DomofonAI.

使用方式

可通过 Hugging Face 的 datasets 库加载训练集:

python from datasets import load_dataset ds = load_dataset("domofon/worldsim-domofon-cpt", split="train")
搜集汇总
数据集介绍
worldsim-domofon-cpt 数据集图片
构建方式
该数据集由世界模拟器语料库(Worldsim)清洗而来,是面向持续预训练(CPT)的专用数据切片。原始语料源自VatsaDev/Worldsim,经精心筛选与净化,最终保留499份源文档。每份文档以唯一标识符重复十次,构成4,990条训练样本,旨在增强模型对特定交互情境的泛化能力。数据以Parquet格式存储于单一训练分割中,便于高效加载与处理。文档内嵌助手标签“Domofon”及组织归属“DomofonAI”,明确身份设定,且不包含终止符,为后续自回归语言建模提供了结构清晰、语义连续的输入流。
特点
该数据集蕴含若干显著特质。其一,每份原始文档通过十次重复,配以从源ID与副本序号派生的唯一标识,既保证了数据规模,又便于回溯溯源。其二,列设计兼具宏观与微观视角:全文文本与预览片段共存,字符计数利于统计分析与过滤。其三,数据集总量约达45.3百万字符(等价于约11.3百万token),在维持高质量的同时,提供了可观的训练量。其四,文档明确指定模型角色为“Domofon”,由“DomofonAI”创造,使得数据集在持续预训练中能够有针对性地塑造模型的身份认知与对话风格,适配特定应用场景。
使用方法
该数据集专为文本生成模型的持续预训练阶段设计,尤其是针对轻量级模型(如SmolLM2)。用户可通过HuggingFace的datasets库便捷加载,例如使用`load_dataset("domofon/worldsim-domofon-cpt", split="train")`即可获取全部4,990条样本。训练时,建议直接利用`text`列作为输入序列,以无监督方式优化模型的语言建模能力。鉴于文档已按需去除终止符,训练过程应自定义合理的序列截断与封装逻辑。数据集的列结构亦支持灵活的预处理操作,如按`source`字段筛选子集或基于`n_chars`进行长度控制,便于适配不同的训练管线与资源配置。
背景与挑战
背景概述
worldsim-domofon-cpt数据集由DomofonAI创建,源于VatsaDev/Worldsim数据集的清洗与持续预训练分片,于近期发布,旨在为SmolLM2等小型语言模型提供领域特定的继续预训练语料。该数据集包含4,990条文档,每条原始文档重复10次以增强训练信号稳定性,其文本统一以Domofon助手角色为标识,由DomofonAI作为创作者注入明确身份信息。核心研究问题聚焦于通过合成数据与角色绑定技术,提升小型模型在持续预训练中的上下文连贯性与领域适应能力,其设计对个性化AI助手开发具有示范意义,尤其在资源受限场景下为模型定制提供了高效路径。
当前挑战
当前挑战首要体现在解决领域预训练中的数据稀缺与角色一致性维持难题,即需在有限源文档基础上构造足够多样且语义连贯的训练样本,以满足小型模型对领域知识的深层摄取。构建过程亦面临多重障碍:源文档需彻底清洗以剔除噪声及潜在不当内容,同时确保缺少<|endoftext|>分隔符的文档序列在重复扩充后不引发模型过拟合或语义断裂。此外,数据集的每文档重复策略虽提升信号强度,却牺牲了文本覆盖广度,可能局限模型对不同语境与句式变体的泛化能力。这些挑战共同指向如何在合成数据策略与真实语言多样性间取得精妙平衡,以导向稳健的持续预训练效能。
常用场景
经典使用场景
该数据集作为领域自适应继续预训练(continued pre-training)的语料切片,在大型语言模型的开发与精调中扮演着关键角色。其内容经由精细清洗,剔除了端符等无关标记,并引入了统一的助手身份标识——Domofon,从而营造出高度一致且富含对话导向的文本环境。经典的使用方式是将此数据融入模型的中间训练阶段,以特定领域的语料对已预训练模型进行二次熏陶,促使模型在保留通用能力的同时,内化所属组织(DomofonAI)的语用风格与知识侧重,进而优化其在特定下游任务中的生成质量与忠实度。
解决学术问题
该数据集直击大语言模型在领域迁移与个性化部署中面临的核心学术难题:如何避免模型在继续训练过程中产生灾难性遗忘,同时有效注入新的知识结构与风格约束。通过提供高度重复(每源文档十次)且结构化的语料,它探索了数据呈现频率对模型学习稳定性的影响,为研究知识固着、上下文自适应等理论提供了宝贵的实验载体。此外,其引入的角色标识与去除端符设计,为探究对话型助手模型的身份认知与生成一致性理论框架提供了实证基础,推动了关于可控文本生成与模型对齐的学术进展。
衍生相关工作
围绕该数据集,后续衍生工作往往聚焦于比较不同继续预训练策略的效果,例如不同重复次数、数据混合比例或添加端符与否对下游任务精确度与流畅度的影响。研究者亦可能基于此开发轻量级评估基准,衡量模型对助手身份的遵循程度、知识更新的保留率等。更进一步,该数据集促进了面向合成数据生成与质量过滤的工具链发展,其‘清洗分片+结构化标识’的模式成为构建大规模领域预训练语料的参考范式,相关论文可能将其作为案例,探讨如何有效利用少量高质量数据实现模型特质塑造。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

