
justtherightsize/it-slama-cs
收藏官方服务:
资源简介:
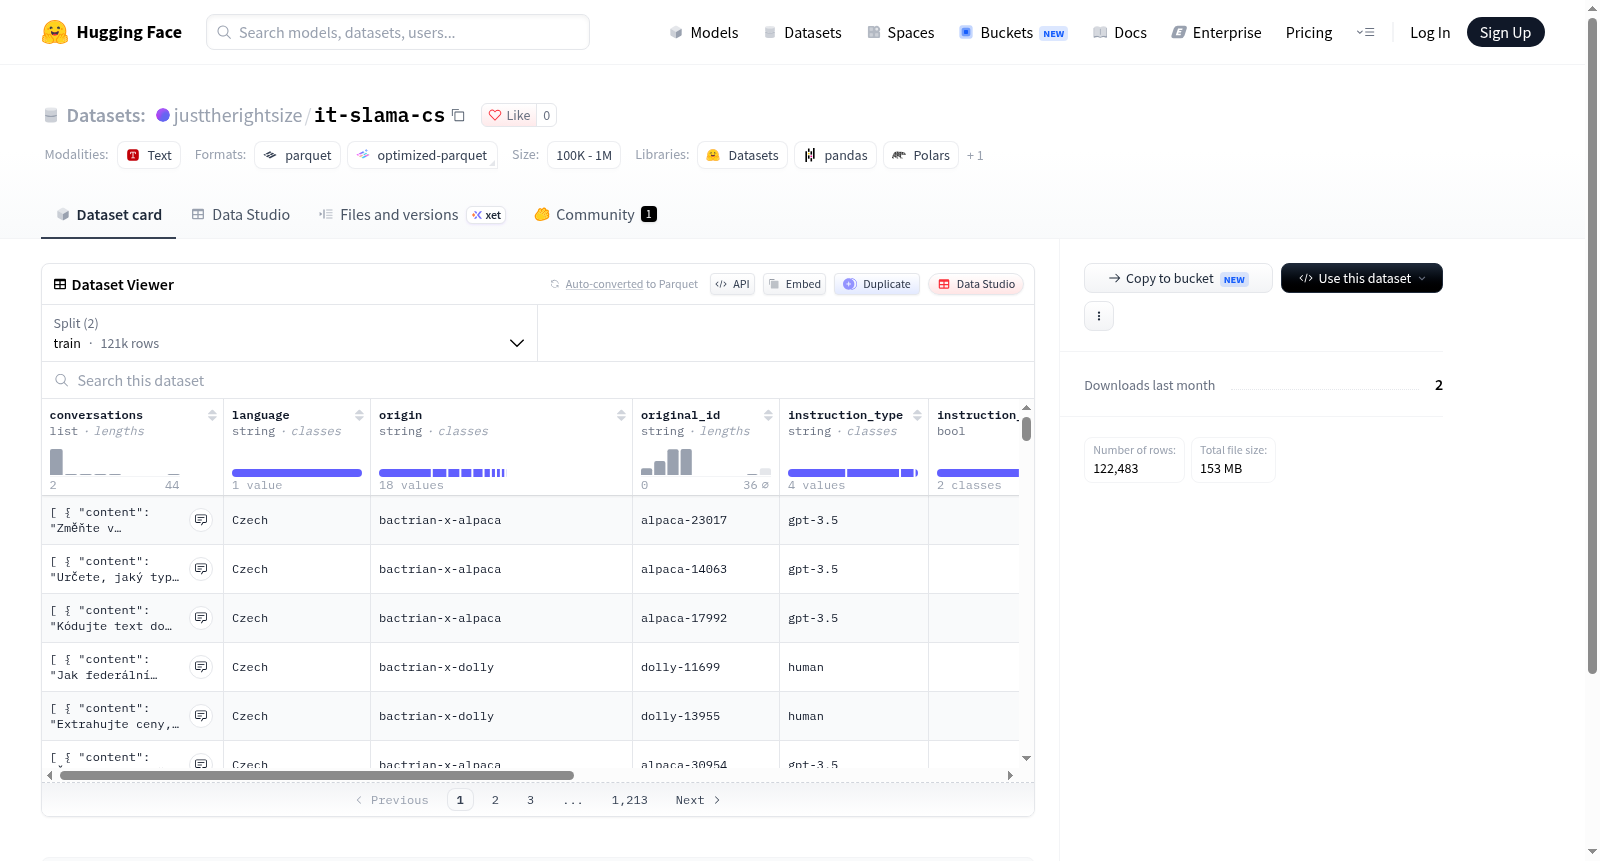
这是一个多语言对话数据集,包含对话内容、角色、语言、来源等特征,数据来源于EuroBlocks、Bactrian-X、ChatCorpus、OSCAR、mC4、Wikipedia等多种数据集,涵盖主题包括建议咨询、人文历史、知识推理、数学推理、开放问答等。数据集分为训练集和测试集,用于支持自然语言处理和对话系统研究。
This is a multilingual dialogue dataset containing features such as conversation content, roles, language, and origin. The data is sourced from various datasets including EuroBlocks, Bactrian-X, ChatCorpus, OSCAR, mC4, and Wikipedia, covering topics such as advice seeking, humanities and history, knowledge reasoning, mathematical reasoning, and open question answering. The dataset is divided into training and test sets, designed to support natural language processing and dialogue system research.
提供机构:
justtherightsize搜集汇总
数据集介绍
构建方式
该数据集的构建立足于多源异构语料的系统性整合,涵盖EuroBlocks-SFT系列、Bactrian-X、MURI项目衍生数据以及捷克科学院提问语料等二十种来源。构建过程采用对话结构统一化策略,将原始指令与回复分别封装为对话轮次,并对跨语言内容实施翻译标注,记录指令与输出的翻译状态。每条样本均保留原始标识符及来源数据集标签,同时补充语言类型、语言组别、指令类型与输出类型等元数据,形成结构规范、来源可溯的大规模监督微调语料。
特点
数据集以多轮对话形式组织,共包含十二万余条训练样本与一千余条测试样本,覆盖丰富指令类型与输出类型。其显著特点在于对数据来源进行精细分类,将二十种原始数据集映射为类别标签,便于溯源与偏置分析。翻译属性以布尔值显式标注,支持多语言场景下的可控训练。语言与语言组别字段为跨语言迁移研究提供便利。整体数据规模适中,存储与下载体积均衡,适用于资源受限环境下的模型微调与评估。
使用方法
使用者可借助HuggingFace datasets库直接加载默认配置,获取训练与测试划分。加载后可通过conversations字段提取对话内容,结合role字段还原用户与助手角色序列,用于监督微调或对话生成任务。language与lang_group字段支持按语言筛选子集,origin_dataset与instruction_type可用于领域适配或课程学习。instruction_translated与output_translated便于剔除或保留翻译样本,控制数据纯净度。original_id字段可回溯原始语料,满足审计与复现需求。
背景与挑战
背景概述
随着大语言模型在自然语言处理领域的迅猛发展,指令微调数据的质量与多样性成为决定模型性能的关键因素。it-slama-cs数据集正是在此背景下应运而生,其汇聚了EuroBlocks、Bactrian-X、MURI等多项开源指令语料,旨在为意大利语及南蒂罗尔地区语言变体提供大规模、多来源的指令微调资源。该数据集由相关研究团队构建,核心研究问题在于如何通过整合异构数据源来提升模型在低资源语言与特定文化语境下的指令遵循能力。其发布对推动多语言指令微调研究、促进语言多样性保护具有积极影响力。
当前挑战
it-slama-cs所面对的领域问题在于,如何让大语言模型在意大利语及南蒂罗尔地区语言变体上准确理解并执行多样化指令,这涉及跨语言迁移、文化适应性及低资源场景下的泛化能力。构建过程中,研究团队需应对多源数据格式统一、指令与输出翻译质量参差不齐、数据去重与偏见缓解等难题,同时确保不同来源(如EuroBlocks、Bactrian-X、MURI)的指令类型与输出类型均衡分布。此外,原始数据中存在的噪声、对齐错误及版权限制亦增加了数据清洗与合规发布的复杂性,这些挑战共同构成了该数据集在质量保障与伦理应用方面的核心难点。
常用场景
经典使用场景
在指令微调与对话系统研发领域,it-slama-cs数据集凭借其大规模、多来源的意大利语及捷克语对话数据,成为训练与评估多语言指令遵循模型的核心资源。研究者通常将其用于监督式微调,以提升模型在跨语言场景下的指令理解与生成能力,尤其适用于低资源语言的对话生成任务。
实际应用
在实际应用中,it-slama-cs被广泛用于构建面向意大利语和捷克语的智能客服、虚拟助手及教育辅导系统。其多样化的指令类型与对话结构,能够支撑企业级对话系统的快速原型开发与领域适配,显著降低多语言场景下的人工标注成本。
衍生相关工作
基于该数据集,研究者已开展多项经典工作,包括多语言指令微调基准的建立、跨语言迁移学习方法的验证,以及对话生成模型的鲁棒性分析。这些工作进一步衍生出针对低资源语言的参数高效微调策略与数据增强技术,推动了多语言对话系统的持续演进。
以上内容由遇见数据集搜集并总结生成


