
Algeria Wildfire Risk Dataset
收藏官方服务:
资源简介:
一个包含121,869个标记单元格-天的数据集,用于预测阿尔及利亚北部的每日野火风险,基于NASA FIRMS和Open-Meteo API构建,覆盖14个火灾季节(2012-2025年),包含1,423个网格单元格和606万条天气读数。
A dataset containing 121,869 labeled cell-days for daily wildfire risk prediction in northern Algeria. Constructed based on NASA FIRMS and Open-Meteo API, this dataset covers 14 fire seasons spanning 2012 to 2025, and includes 1,423 grid cells and 6.06 million weather readings.
创建时间:
2026-08-12
原始信息汇总
阿尔及利亚 wildfire 风险数据集
核心信息:一个用于预测阿尔及利亚北部每日野火风险的数据集,基于 NASA FIRMS 卫星火灾探测和 Open-Meteo 再分析天气数据构建,从实时 API 构建而非下载现成数据。
数据集规模
- 121,869 条标签化的格点-日记录
- 14 个火灾季节(2012–2025)
- 1,423 个格点
- 6.06M 条天气读数
模型性能
| 指标 | 数值 |
|---|---|
| PR-AUC | 0.559 |
| ROC-AUC | 0.781 |
| Recall(阈值0.18) | 0.810 |
五折交叉验证按年份分组,阈值在内部保留年份上拟合,从未在评分折上拟合。
核心特征
单一特征 days_since_last_fire(上次火灾以来的天数)贡献了 26.0% 的增益,是模型的主要驱动力。加入该特征后 PR-AUC 从 0.459 提升至 0.551。
关键设计决策
| 决策 | 选择 |
|---|---|
| 分析单位 | 0.1° 格点 × 单日 |
| 检测过滤 | 仅 type == 0(排除工业静态火源) |
| 候选格点 | 至少在2个不同年份燃烧≥2天的土地 |
| 负样本 | 同格点、不同日期 |
| 缓冲 | 自身格点 ±3 天,同日邻域 |
| 数据划分 | 按年份分组,而非随机划分 |
重要注意事项
- 阈值应为 0.18,而非 0.5 — 在 0.5 默认阈值下会漏掉三分之二的火灾
- 概率需经基础率校正后再展示 — 训练分布为1:3,而真实火灾日约每100个合格格点-日中1个
- 模型仅适用于此前已燃烧过的土地,不能泛化至从未燃烧的森林
- VIIRS 无法穿透云层观测,"无探测" ≠ "无火灾"
- FWI 数值远高于规范范围,不可与公布的火灾危险阈值比较
- 缺少点火原因数据 — 阿尔及利亚大多数野火为人为原因
数据来源
- NASA FIRMS:https://firms.modaps.eosdis.nasa.gov/api/(VIIRS SNPP,2012年1月起存档)
- Open-Meteo Archive:https://archive-api.open-meteo.com/v1/archive(ERA5-Land)
许可
- 代码:MIT
- 数据:CC BY 4.0
下载
- Kaggle:https://www.kaggle.com/datasets/abdelmaleknedjar/algeria-wildfire-risk-121k-labelled-cell-days
- 也可从最新 release 附件获取
搜集汇总
数据集介绍
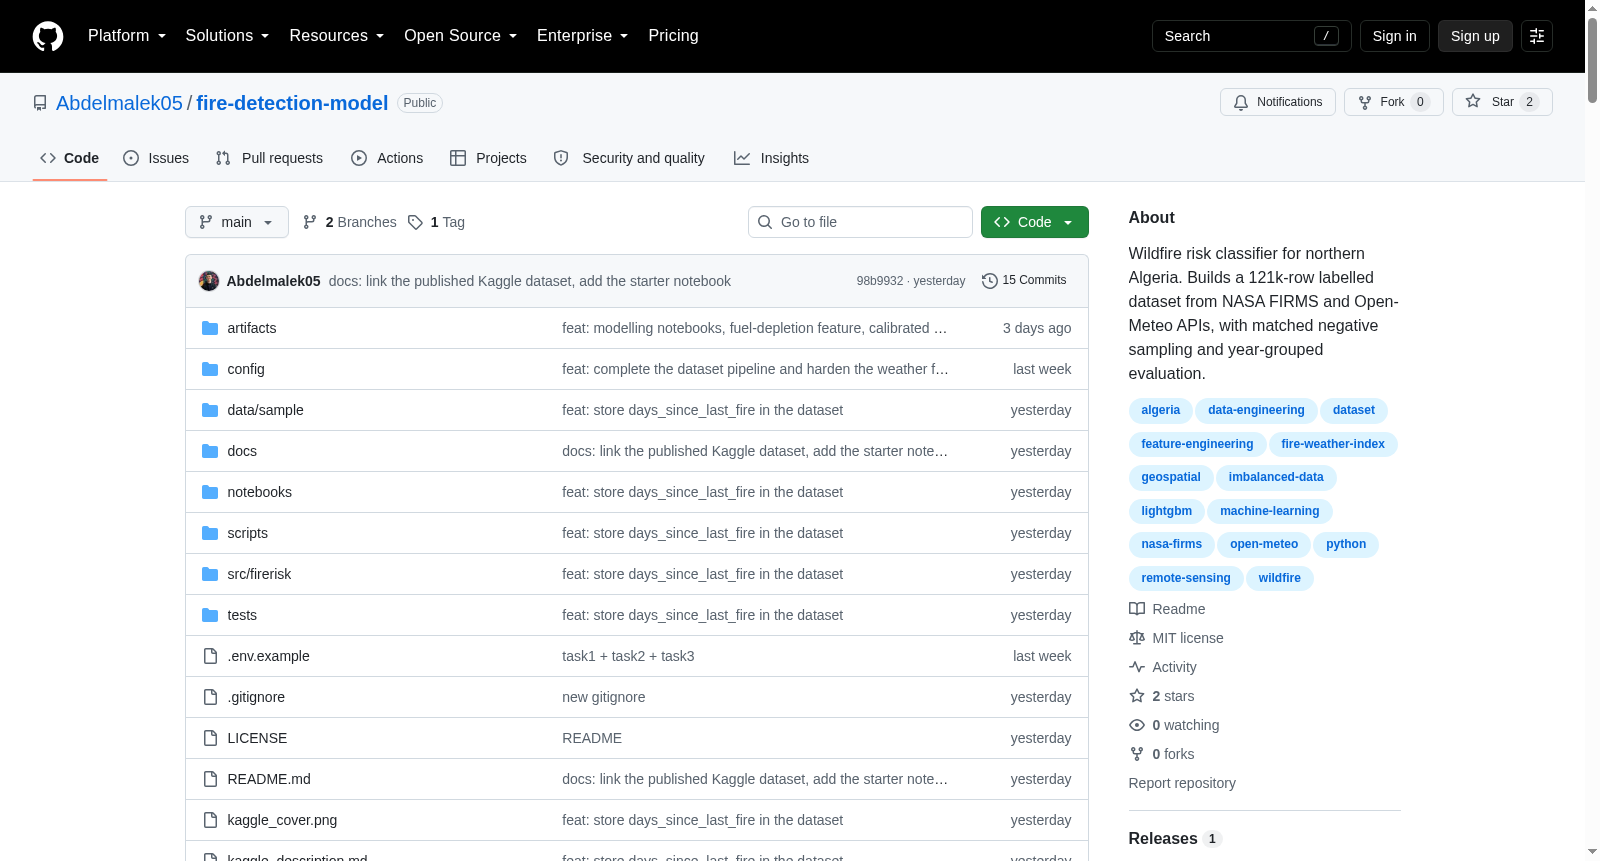
构建方式
本数据集基于NASA FIRMS卫星火点监测与Open-Meteo再分析气象数据,通过实时API构建而成,覆盖阿尔及利亚北部2012至2025年间14个火灾季。研究将0.1°网格单元与日期作为分析单元,经过去重与过滤,最终形成121,869个标注的单元-日样本,包含1,423个网格单元及逾600万条气象记录。负样本采样策略严谨,从同一单元的不同日期选取,排除了地理捷径,确保了标签与单元身份统计独立。特征工程融合了21个气象、火险指数及燃料消耗特征,并明确排除了地理坐标,以保证仅有时间变化信息可对预测产生贡献。
特点
数据集的核心特色在于其科学的实验设计与严谨的评估体系。其负样本采自曾发生火灾的同一单元,使得任何静态单元特征均无主效应,凸显了时间动态信息的重要性。模型评估采用按年份分组的分层交叉验证,有效避免了随机划分所导致的标签泄漏与性能高估。尤为关键的是,数据集揭示了燃料消耗特征(如自上次火灾以来的天数)对模型性能贡献显著(增益26%),并明确指出了阈值选择(0.18而非0.5)及基础率校正对实际部署的影响,提供了一套可复现的模型评估与校准范式。
使用方法
数据集以CSV或Parquet格式提供,可从Kaggle或GitHub发布页面获取,无需API密钥。用户可直接加载数据进行建模,但需严格遵循README中关于阈值、基础率校正及模型适用范围的规定。建议使用随附的LightGBM模型(阈值为0.18),并注意将原始概率转换为相对于基础率的倍数以进行风险分级(低、中、高、极高)。仓库提供了完整的文档、模型笔记本及测试,便于复现与扩展。警告:模型仅适用于先前燃烧过的土地,对于沙漠或城市等未覆盖区域,须在推理层进行排斥,避免输出无意义的极端风险预测。
背景与挑战
背景概述
阿尔及利亚野火风险数据集(Algeria Wildfire Risk Dataset)由研究者Abdelmalek Nedjar于2025年创建,旨在利用实时卫星火点检测与再分析气象数据,构建高分辨率、长时间序列的野火风险预测资源。该数据集整合了NASA FIRMS的VIIRS火点产品与Open-Meteo的ERA5-Land再分析气象资料,覆盖2012至2025年间的14个火灾季节,包含121,869个标记的格点-日样本,涉及1,423个0.1°网格单元及超过600万条气象记录。其核心研究问题在于突破传统小样本野火数据集的局限,通过精细的空间单元划分与时间缓冲机制,实现每日尺度的野火风险动态评估。该数据集的发布填补了北非地区大规模、多季节野火风险建模的空白,为区域火灾预警系统提供了基准数据,并在Kaggle平台上公开共享,推动了干旱半干旱区野火风险机器学习研究的深入发展。
当前挑战
该数据集在构建与建模过程中面临多重挑战。首先是领域问题的挑战:野火风险预测需处理高度不平衡的类别分布(真实火点日仅占约1/100),且传统随机负样本抽样易引入空间与时间上的伪关联;同时,卫星探测的局限性(如云层遮挡导致漏检)使得“无火”标签的可靠性存疑。其次是构建过程中的挑战:数据整合需协调多源传感器(VIIRS类型0与工业源区分)及不同空间分辨率的气象网格,并应对Open-Meteo API的配额限制与断点续传需求;特征工程需谨慎设计负样本缓冲(±3天)以避免标签泄漏,且发现最佳特征(days_since_last_fire)存在固有泄漏,迫使引入时间滞后规则。此外,模型评估需采用按年份分组交叉验证以防范随机分裂带来的虚假高精度(PR-AUC虚高21%),并需进行基准率校正以确保部署阈值(0.18)的实用性。这些挑战深刻反映了野火地理空间建模中数据生成机制与统计推断的复杂性。
常用场景
经典使用场景
该数据集作为火险预测领域的一项大规模、长时间序列的基准资源,主要用于基于机器学习的日尺度野火风险分类任务。其121,869条经卫星与再分析气象数据交叉标注的样本,为研究者提供了构建和验证预测模型的坚实基础。典型应用包括利用天气变量、火险天气指数及燃料消耗特征,训练梯度提升树、随机森林或神经网络等模型,以输出火灾发生的概率或风险等级。该数据集独特的设计——以0.1°网格单元为分析单位,并采用年份分组交叉验证——使得它成为评估模型泛化能力、避免时间泄漏和空间自相关问题的标准测试平台。
解决学术问题
该数据集解决了现有公开火险数据集规模过小、时空覆盖有限的问题,显著弥补了学术研究中长期缺乏高质量、大样本标签数据的空白。它使得研究者能够探索火险预测中的核心科学问题,如燃料消耗动态对火险的影响、标签泄漏的识别与规避、以及稀疏正样本下的模型评估策略。通过提供严格的分组验证协议和基线模型结果,该数据集促进了野火风险建模方法的公平比较,并揭示了信息天花板的存在,引导后续研究关注植被状态等补充数据,从而推动了火险预测科学从单纯算法优化向数据与特征工程的深入转变。
衍生相关工作
该数据集的发布催生了多个方向的衍生工作。一方面,基于其公开的基线模型和特征分析,后续研究聚焦于引入归一化植被指数(NDVI)和水分指数(NDMI)等动态植被特征,以突破当前模型的信息瓶颈。另一方面,其关于标签泄漏和分组验证的深刻洞察,启发了其他时空数据领域(如滑坡、洪水预测)重新审视自身的验证协议,促进了更严谨的评估方法学的发展。此外,围绕该数据集开发的模型部署工件,包括阈值校准与基础率校正模块,也被借鉴用于构建实时预测服务,形成了从数据到应用的开源生态。
以上内容由遇见数据集搜集并总结生成


