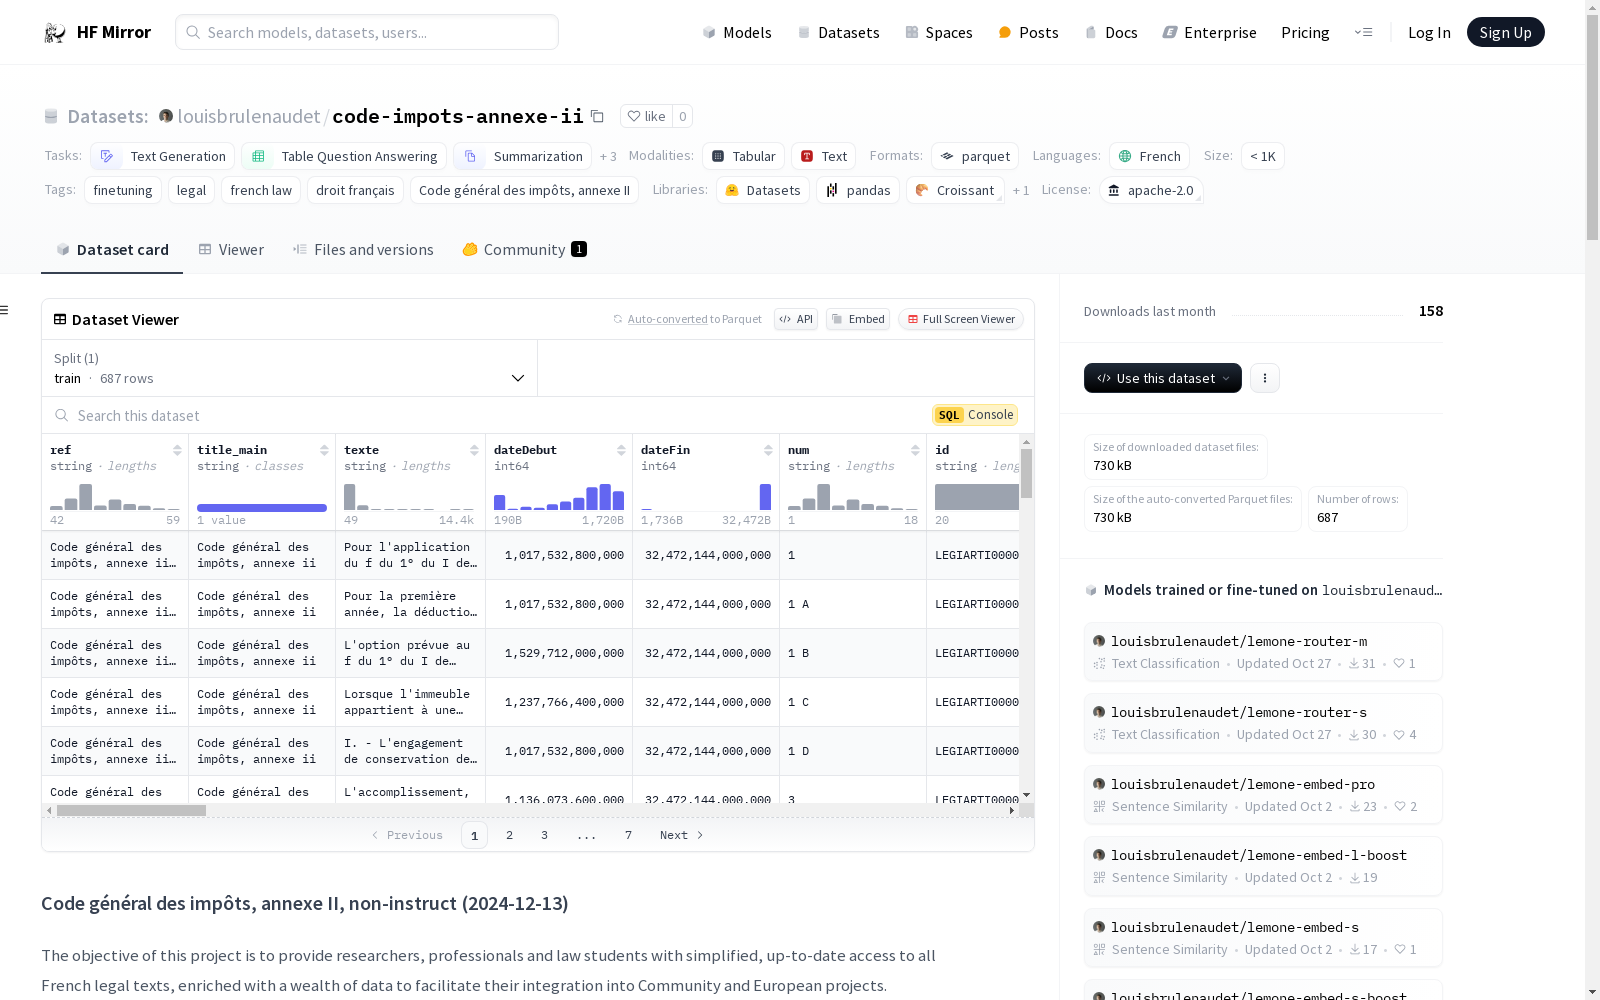
louisbrulenaudet/code-impots-annexe-ii
收藏资源简介:
该数据集名为Code général des impôts, annexe II, non-instruct (2024-07-21),专注于通过微调预训练语言模型来创建高效且准确的法律实践模型。数据集的内容基于法国税法《Code général des impôts, annexe II》,并提供了多种任务类别,如文本生成、表格问答、摘要生成、文本检索、问答和文本分类。数据集的生成过程涉及使用一系列指令来生成每个数据项的输入和输出。每个数据项包含指令、输入、输出、生效日期、过期日期和文章编号。
The dataset named Code général des impôts, annexe II, non-instruct (2024-07-21) focuses on fine-tuning pre-trained language models to create efficient and accurate models for legal practice. The dataset is based on the French tax code Code général des impôts, annexe II and provides multiple task categories such as text generation, table-question-answering, summarization, text retrieval, question-answering, and text classification. The dataset generation process involves using a series of instructions to generate the input and output for each data item. Each data item includes an instruction, input, output, start date, expiration date, and article number.
数据集概述
名称: Code général des impôts, annexe II
许可: Apache-2.0
语言: 法语 (fr)
多语言性: 单语种
标签:
- 微调
- 法律
- 法国法律
- 法国税法总则,附录II
源数据集: 原始数据
任务类别:
- 文本生成
- 表格问题回答
- 摘要
- 文本检索
- 问答
- 文本分类
规模: 1K<n<10K
数据集生成:
- 数据集由一系列字典组成,每个字典包含以下字段:
instruction: 字符串,与元素相关的指令。input: 字符串,元素的输入细节。output: 字符串,元素的输出信息。start: 字符串,文章生效日期。expiration: 字符串,文章失效日期。num: 字符串,文章的ID。
使用说明:
- 数据集用于微调预训练语言模型,以创建适用于法律实践的高效准确模型。
- 采用指令基础的微调方法,通过人类提供的指令指导模型行为,增强模型的任务特定适应性、减少模糊性、提高知识转移效率和解释性。