
遇见数据集

poolside-laguna-hackathon/patchrecoverygym-laguna

收藏
Hugging Face2026-05-30 更新2026-05-31 收录
官方服务:

资源简介:

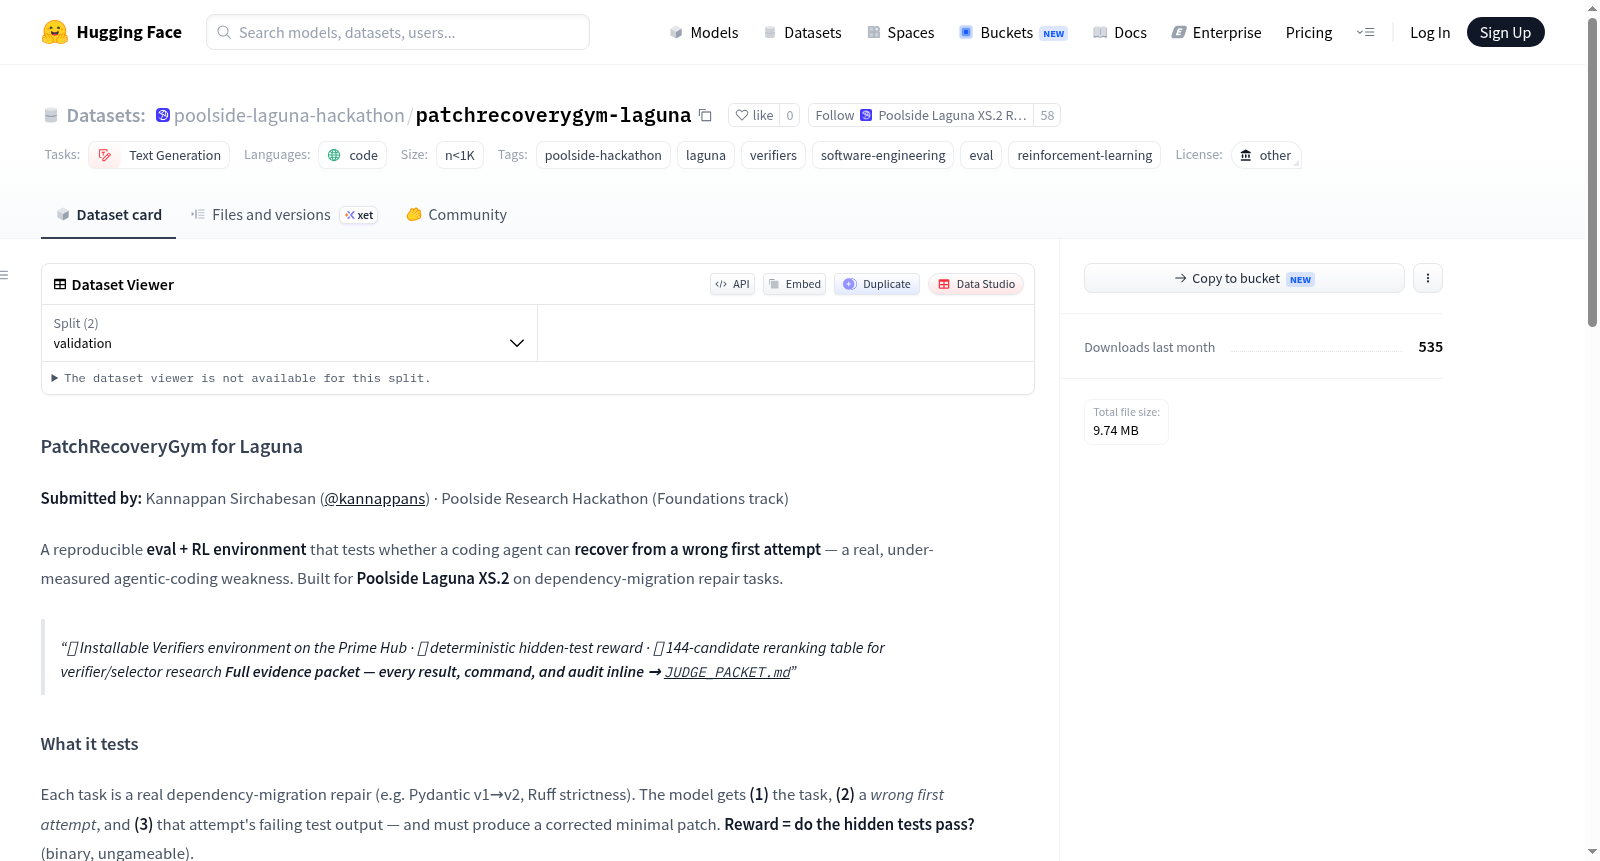
PatchRecoveryGym for Laguna 是一个可复现的评估和强化学习环境,旨在测试编码代理是否能够从错误的首次尝试中恢复——这是一个实际且未被充分测量的代理编码弱点。该环境专为Poolside Laguna XS.2设计,针对依赖迁移修复任务(例如Pydantic v1到v2、Ruff严格性)。每个任务包括任务描述、一个错误的首次尝试以及该尝试的失败测试输出,模型必须生成一个修正后的最小补丁。奖励基于隐藏测试是否通过(二进制,不可作弊)。其重要性在于:代理编码器通常能编写看似合理的修复,但很少能从自己的错误尝试和错误消息中纠正方向;大多数基准测试仅测试从零开始解决,而此数据集则专注于隔离恢复能力。

PatchRecoveryGym for Laguna is a reproducible eval + RL environment that tests whether a coding agent can recover from a wrong first attempt — a real, under-measured agentic-coding weakness. Built for Poolside Laguna XS.2 on dependency-migration repair tasks (e.g., Pydantic v1→v2, Ruff strictness). Each task provides the task description, a wrong first attempt, and that attempts failing test output, and the model must produce a corrected minimal patch. Reward is based on whether the hidden tests pass (binary, ungameable). Why it matters: agentic coders write plausible-looking fixes but rarely course-correct from their own bad attempt + an error message. Most benchmarks test solve-from-scratch; this one isolates recovery.
搜集汇总
数据集介绍
poolside-laguna-hackathon/patchrecoverygym-laguna 数据集图片
构建方式
PatchRecoveryGym-Laguna专为评估与强化学习环境设计,聚焦于编程智能体从错误初试中恢复的能力。其构建基于真实的依赖迁移修复任务(如Pydantic v1至v2迁移、Ruff严格性调整),每个任务包含三个要素:任务描述、错误初试及其失败的测试输出。模型需生成最小补丁以通过隐藏测试,奖励机制为二值化隐藏测试通过与否,杜绝作弊可能。数据集共144个候选生成项,附带补丁文本、隐藏标签与跟踪特征,支持验证器与重排序策略研究。
特点
该数据集独树一帜地测试编程智能体的“纠错”能力,而非从头求解,填补了现有基准的空白。其任务设计真实且具有挑战性,隐藏测试奖励机制确保评估的公正性与可重复性。针对Laguna XS.2模型的初步结果显示,模型在pass@8指标上可达0.833,但首次尝试成功率仅0.250,凸显了恢复能力的不稳定性。数据集中还包含一个留出的3任务子集,用于验证选择器的泛化性能。
使用方法
使用者可通过Prime Hub环境直接安装与运行评估,命令为`prime env install kannappan/patchrecoverygym-laguna`及`prime eval run kannappan/patchrecoverygym-laguna -m poolside/laguna-xs.2 -n 6`。数据集提供详细的裁判包(JUDGE_PACKET.md)与分数卡,含所有评估结果、复现命令与审计信息。此外,144个候选生成项的重新排序挑战表存放于`outputs/reranking_challenge/`目录,便于验证器、重排序器及重试策略的深入研究。
背景与挑战
背景概述
PatchRecoveryGym for Laguna是由Kannappan Sirchabesan在Poolside Research Hackathon(Foundations赛道)中创建的一个评估与强化学习环境,专注于测试编码智能体在初次尝试失败后的修复能力。该数据集于2024年发布,核心研究问题在于揭示当前编码智能体在依赖迁移修复任务中普遍存在的“恢复能力”短板——即模型虽能生成看似合理的代码,却难以从自身错误与测试错误信息中有效修正。通过构建基于真实依赖迁移修复(如Pydantic v1→v2、Ruff严格性升级)的任务,并设计可复现的隐藏测试奖励机制,该数据集填补了现有基准测试普遍忽略智能体错误恢复能力的空白,为强化学习、验证器选择器研究及代码智能体鲁棒性评估提供了关键工具。其对相关领域的影响力体现在:首次量化了编码智能体的恢复能力与“从零求解”性能之间的显著差距,推动了代码生成模型评估范式的演进。
当前挑战
该数据集面临的核心挑战包括领域问题与构建过程两大层面。在领域问题上,它针对的是现有基准测试未能覆盖的智能体编码关键弱点——即编码模型在首次生成错误修复后,难以利用错误信息进行有效修正,导致“恢复能力”未被充分评估与优化。构建过程中遇到的挑战则更为具体:首先,需要设计真实且可复现的依赖迁移修复任务,确保“错误首次尝试”与“正确修正”之间的边界清晰,以避免奖励信号被投机行为利用;其次,筛选隐藏测试的难度需适中,既要保证模型无法通过记忆或模式匹配侥幸通过,又要确保参考解决方案能满分通过以验证任务有效性;最后,构建过程中暴露的“日志-回放偏差”问题(如最终隐藏评估得分为0/6与预期不符),提示了数据集验证流程中存在的环境不确定性与可复现性挑战。
常用场景
经典使用场景
PatchRecoveryGym for Laguna 数据集专为评估和训练代码智能体在编程任务中从首次错误尝试中恢复的能力而设计。在软件工程领域,依赖迁移修复(如从Pydantic v1升级到v2或调整Ruff代码规范)是常见但棘手的场景,开发者常常需要基于失败的测试输出来修正补丁。该数据集将每个任务封装为一个强化学习环境:提供任务描述、一个错误的首次尝试以及该尝试的失败测试输出,要求模型生成一个最小化的正确补丁。奖励机制简洁而严苛——仅当补丁通过隐藏测试时获得二元奖励,这排除了任何取巧的可能。其经典用法是通过 pass@k 指标评估模型在多次采样中恢复正确补丁的概率,从而量化代码智能体的纠错能力。
衍生相关工作
围绕该数据集已衍生出多项经典研究工作。首先,基于其提供的144候选排序集,研究者可开发不依赖隐藏测试的免窥探选择器,如Laguna团队展示的隐式验证器,该工作在无需访问真正测试用例的前提下即能遴选出正确补丁,推动了代码验证从白盒向黑盒的迁移。其次,确定性应用感知修复策略的提出,证明仅通过改善补丁格式与输出规范性即可显著提升pass@1指标,启发了一系列关于代码生成后处理优化的研究。此外,该数据集的评估框架本身也催生了关于日志-回放差距分析的探讨——即模型在训练与推理阶段表现不一致的根本原因,这为强化学习中的探索-利用平衡提供了新的实验平台。
数据集最近研究
最新研究方向
在代码智能与软件工程领域,补丁恢复已成为评估编码智能体纠错能力的核心前沿方向。PatchRecoveryGym-Laguna数据集针对依赖迁移修复任务中的错误首轮尝试恢复问题,构建了包含隐藏测试奖励机制的强化学习环境。该数据集揭示了当前主流代码生成模型虽然具备潜在恢复能力(pass@8达0.833),但初次正确率偏低(pass@1仅0.250)的关键弱点,通过确定性应用感知修复与无测试信息的选择器可显著提升可靠性。这一研究填补了现有基准过度聚焦首次正确率而忽视纠错能力的评估空白,为强化学习与验证器研究提供了标准化的144候选重排序评测表,推动编码智能体从单一解法输出向可修正推理能力的范式转变。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

