
遇见数据集

jet-ai/ruler-100-nemotron

收藏
Hugging Face2026-06-18 更新2026-06-14 收录
官方服务:

资源简介:

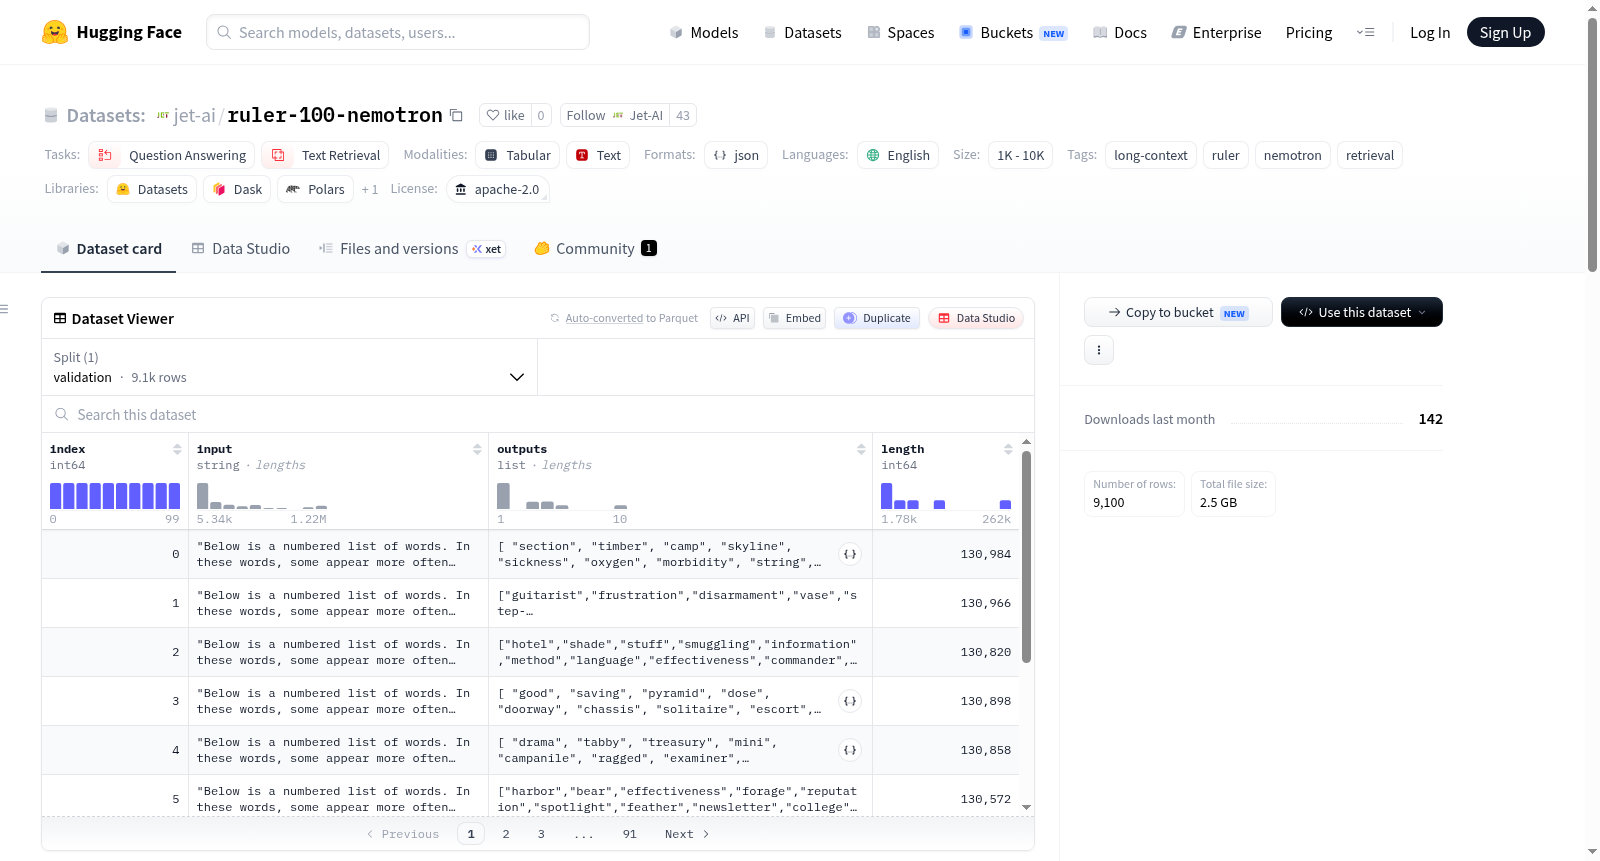
RULER-100 — Nemotron-Nano-v3 tokenized数据集是RULER长上下文评估数据的重新生成版本,使用nvidia/NVIDIA-Nemotron-3-Nano-30B-A3B-BF16(指令)分词器处理,以确保标注的上下文长度对该模型精确无误,避免使用其他模型(如Qwen3)分词数据时可能出现的漂移问题。数据集包含7种上下文长度(4096、8192、16384、32768、65536、131072、262144,即模型的最大长度)和13个RULER任务(niah_single_1/2/3、niah_multikey_1/2/3、niah_multivalue、niah_multiquery、vt、cwe、fwe、qa_1(SQuAD)、qa_2(HotpotQA)),每个(长度,任务)组合有100个样本,总计9100个示例。数据以原始提示形式存储(无聊天模板),生成时预留了16个令牌用于推理时的聊天包装器。数据布局为<length>/data/<task>/validation.jsonl,每个JSON行包含index、input、outputs和length字段。数据集由NVIDIA RULER(Apache-2.0许可证)生成,QA任务嵌入来自SQuAD v2(CC BY-SA 4.0)和HotpotQA(CC BY-SA 4.0)的段落,NIAH任务使用Paul Graham散文,生成种子为42。

RULER-100 — Nemotron-Nano-v3 tokenized is a regenerated version of RULER long-context evaluation data, tokenized with the nvidia/NVIDIA-Nemotron-3-Nano-30B-A3B-BF16 (instruct) tokenizer to ensure exact labeled context lengths for that model, avoiding drift that occurs when RULER data tokenized for a different model (e.g., Qwen3) is used with Nemotron. The dataset includes 7 context lengths (4096, 8192, 16384, 32768, 65536, 131072, 262144, the models maximum) and 13 RULER tasks (niah_single_1/2/3, niah_multikey_1/2/3, niah_multivalue, niah_multiquery, vt, cwe, fwe, qa_1 (SQuAD), qa_2 (HotpotQA)), with 100 samples per (length, task) combination, totaling 9,100 examples. Data is stored as raw prompts (no chat template), with 16 tokens reserved during generation for the chat wrapper applied at inference time. The layout is <length>/data/<task>/validation.jsonl, and each JSON line contains fields: index, input, outputs, and length. The dataset is generated by NVIDIA RULER (Apache-2.0 license), with QA tasks embedding passages from SQuAD v2 (CC BY-SA 4.0) and HotpotQA (CC BY-SA 4.0), NIAH tasks using Paul Graham essays, and a generation seed of 42.
提供机构:
jet-ai
搜集汇总
数据集介绍
jet-ai/ruler-100-nemotron 数据集图片
构建方式
该数据集基于NVIDIA开源的RULER框架生成,专为评估长上下文语言模型而设计。其核心构建特色在于采用nvidia/NVIDIA-Nemotron-3-Nano-30B-A3B-BF16指令分词器对原始RULER评估数据进行重新分词,确保每个样本的实际标记长度与模型的最大上下文窗口精确匹配,避免了不同分词器间因标记漂移带来的长度偏差。数据生成过程中,在每条提示中预留了16个标记用于推理时的聊天模板封装,从而保证模型输入严格控制在预设长度内。数据集覆盖4096至262144共7种上下文长度,每项长度下包含13种RULER任务,每种任务生成100个样本,总计9100条数据,以JSONL格式按长度和任务分目录存储。
使用方法
使用该数据集时,研究者可通过Hugging Face的snapshot_download函数将全部数据文件下载至本地,随后将数据目录指向RULER评估框架的data_dir参数即可启动评测。在推理阶段,需将每条样本的input字段作为单轮用户消息输入,并应用Nemotron-Nano-v3的分词器聊天模板,同时务必将enable_thinking参数设置为False以禁用思考令牌,避免模型将有限的生成预算浪费在推理链上。各任务的生成令牌预算已明确设定:需查找类任务为128,变量追踪30,共指消解120,词频统计50,问答任务32。这种标准化流程确保了评估的一致性和跨研究间的可比性。
背景与挑战
背景概述
随着大型语言模型(LLMs)在复杂自然语言处理任务中的广泛应用,其处理长序列上下文的能力成为评估模型实用性的关键指标。为系统性地评测模型在超长文本上的表现,NVIDIA研究团队在2023年提出了RULER(Reusable Unified Long-context Evaluation Resource)基准测试框架。该数据集‘ruler-100-nemotron’是RULER框架的衍生版本,专注于适配NVIDIA自主研发的Nemotron-Nano-v3模型,由Jet AI团队在2025年创建,旨在精确衡量该模型在7种上下文长度(从4096至262144 tokens)上的性能。核心研究问题包括模型在长文档中的信息检索和多跳推理能力,涵盖13项任务(如‘大海捞针’、上下文推理和问答)。该数据集通过重新分词解决了不同模型间的token偏移问题,为Nemotron系列模型的长上下文评估提供了标准化基准,在NVIDIA生态系统和高效语言模型研究中具有重要影响力。
当前挑战
该数据集所解决的领域问题在于,现有长上下文评估数据集(如原始RULER)在跨模型使用时因分词器差异导致真实上下文长度偏离预期,使得评测结果失真。具体挑战包括:1)分词一致性问题:针对Nemotron-Nano-v3模型,确保每个样本在应用聊天模板后仍严格匹配标称长度,否则评估会混淆模型能力与token预算差异。2)评估构建中的资源与精度权衡:需要在每个任务(13种)和长度(7档)上生成100个样本,总计9100条数据,同时为不同任务(如NIAH的128 tokens和VT的30 tokens)分配精确的生成预算,避免推理开销影响评分。3)黄金答案的匹配策略复杂,需区分全匹配(如检索任务)和部分匹配(如问答),增加了自动化评估的难度。这些挑战要求数据生成过程高度可控,且适配特定模型的即时推理约束。
常用场景
经典使用场景
在长上下文语言模型的研究浪潮中,RULER-100-Nemotron数据集犹如一把精密的标尺,专为其评测而生。该数据集涵盖从4096到262144 token的7种上下文长度,并整合了13项经典RULER评测任务,包括单/多键值嵌入检索、多值查询、词汇检索与问答等。研究者通过在不同长度上运行模型,系统性地衡量其从海量无关信息中精准定位目标知识的能力,从而揭示模型在长序列处理中的真实边界与潜在缺陷。
解决学术问题
该数据集直击长上下文模型评估中数据不一致的核心痛点。由于不同分词器产生的token计数存在偏差,以往在不同模型间迁移使用评测数据会造成上下文长度的漂移,进而干扰结论的可靠性。RULER-100-Nemotron通过使用Nemotron-Nano-v3分词器重新生成所有样本,并精确预留推理时聊天模板占用的token,确保了评估长度的精准无误。这一设计为公平、可复现地比较长上下文模型提供了坚实基础,推动了语言模型在长序列理解领域的严谨研究。
实际应用
在实际落地中,该数据集为企业与研发团队提供了筛选与测试长上下文语言模型的高效工具。例如,在金融文档分析、法律卷宗摘要、科研论文综述等需要处理超长文本的场景中,工程师可借助该数据集快速评估候选模型在百万级上下文窗口下的信息检索与推理能力。通过观察模型在不同任务上的失败模式,团队能够针对性地调整模型结构、训练策略或推理时的内存管理方案,从而加速长上下文模型的产业化进程。
数据集最近研究
最新研究方向
该数据集聚焦于长上下文场景下大语言模型的检索与推理能力评测,其核心价值在于提供了精准适配特定分词器的RULER评估数据。当前研究前沿通过构建4096至262144 token的七档上下文长度,结合13种多样化任务(包括单/多键检索、多值查询、变长文本及问答等),系统性地探究模型在超长序列中的信息定位与语义整合能力。这一方向直接回应了业界对长上下文LLM实际效能的关切,尤其与Nemotron-Nano-v3模型生态紧密关联,通过精确的分词器对齐消除长度漂移,为评估长文本推理的鲁棒性提供了标准化基准。其生成方法学中针对聊天模板的预算预留策略,更启发了对推理阶段开销控制的深度思考,对推动长文本LLM的实用化部署具有重要方法论意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

