robusto-1_extended
收藏资源简介:
Robusto-1 Extended数据集包含来自秘鲁三个城市(主要是利马、库斯科和卡哈马卡)的视频记录,以及关于车辆行为、外部因素和驾驶条件的详细信息。这个数据集适用于车辆行为分析、交通状况检测和驾驶场景模拟等任务。每个视频记录包括关于自车行为、外部条件(交通标志、天气等)的数据,并且这些视频是在不同的交通条件下录制的,每个视频都有相应的元数据标签。
The Robusto-1 Extended dataset contains video recordings from three cities in Peru, primarily Lima, Cusco and Cajamarca, alongside detailed information regarding vehicle behavior, external factors and driving conditions. This dataset is applicable to tasks such as vehicle behavior analysis, traffic condition detection and driving scenario simulation. Each video recording includes data on the ego-vehicle's behavior, external conditions including traffic signs, weather and other relevant factors, and these videos were recorded under varying traffic conditions, with corresponding metadata tags attached to each individual video.
Robusto-1 Extended 数据集概述
基本信息
- 数据集名称: Robusto-1 Extended
- 标签: video, urban-driving, peru, traffic, autonomous-driving
- 许可证: Apache-2.0
- 任务类别: video-classification
数据集描述
- 内容: 包含秘鲁3个城市(主要是利马、库斯科和卡哈马卡)录制的视频,涵盖车辆行为、外部因素和驾驶条件的详细信息。
- 用途: 适用于车辆行为分析、交通状况检测和驾驶场景模拟等任务。
- 特点:
- 每个视频记录包含自我车辆行为、外部条件(交通标志、天气等)的详细信息。
- 视频在各种交通条件下录制,并附有相应的元数据标签。
主要特征
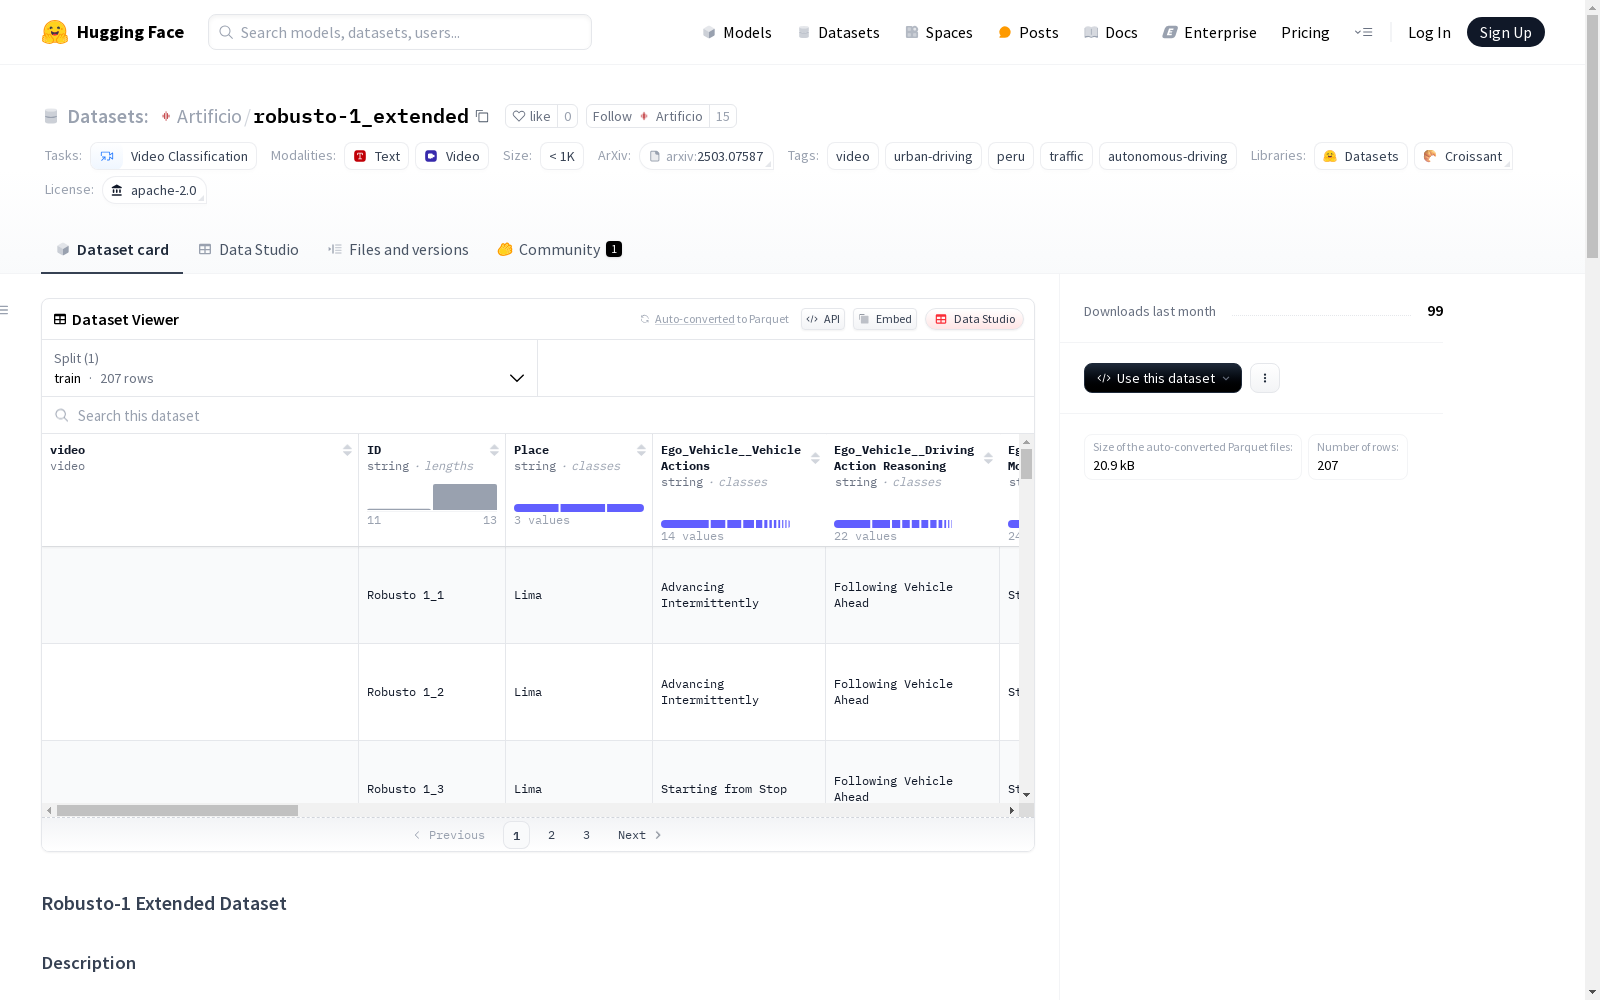
- ID: 视频的唯一标识符。
- Video_Name: 视频文件名。
- Place: 视频录制地点。
- Ego_Vehicle: 录制期间自我车辆行为的详细信息。
- External_Factors: 外部条件(如交通标志、天气等)。
- Video:
.mp4格式的视频文件路径。
元数据示例
json { "ID": "Robusto 1_1", "Place": "Lima", "Ego_Vehicle": { "Vehicle Actions": "Advancing Intermittently", "Driving Action Reasoning": "Following Vehicle Ahead", "Vehicle Motion Behavior": "Stop-and-Go" }, "External_Factors": { "Traffic Signs": "", "Traffic Lights": "Red", "Weather Conditions": "Clear", "Road Surface Conditions": "", "Road Structures": "", "Static objects": "Buildings", "Other Vehicle Behaviors": "Cutting Off", "Pedestrian Behavior": "", "Unexpected Obstacles": "", "Emergency Situations": "", "Lighting Conditions": "Daylight", "Traffic Conditions": "Heavy Traffic", "Driving Environment": "Urban" } }
数据集使用
- 用途: 车辆行为分析、改进自动驾驶算法、训练/测试需要交通和车辆行为数据的计算机视觉模型。
- 加载方式: python from datasets import load_dataset dataset = load_dataset("path/to/robusto-1_extended")
文件结构
robusto-1_extended/ ├── README.md ├── metadata.jsonl └── videos/ ├── Robusto 1_1.mp4 ├── Robusto 1_2.mp4 └── ...
与Robusto-1数据集的区别
- Robusto-1 Extended: 包含200个视频及其元数据,用于VQA研究,便于不同团队创建自己的问题。
- Robusto-1: 包含7个视频片段,同时包含人类和机器响应以及视频元数据。
引用
bibtex @article{cusipuma2025robusto, title={Robusto-1 Dataset: Comparing Humans and VLMs on real out-of-distribution Autonomous Driving VQA from Peru}, author={Cusipuma, Dunant and Ortega, David and Flores-Benites, Victor and Deza, Arturo}, journal={arXiv preprint arXiv:2503.07587}, year={2025} }