
遇见数据集

open-index/hacker-news-text-search

收藏
Hugging Face2026-05-26 更新2026-05-31 收录
官方服务:

资源简介:

该数据集包含从2025年全年Hacker News公开存档中采样的评论和故事,并配对了精心策划的子字符串模式词典和预计算的匹配标签。其主要用途是在真实、杂乱的英文文本上测试文本搜索和子字符串匹配代码,涵盖多字节字符、HTML实体、嵌入URL、混合大小写、CVE标识符、版本字符串以及论坛俚语的长尾分布。数据集分为两个主要部分:文本池(包括评论和故事)和模式池(包括主题、类别、域名、禁止和允许模式)。此外,还提供了多个工作负载配置,分为Q系列(扁平化的文本x模式对,用于隔离子字符串匹配器)和HQ系列(嵌入一个或两个LIKE连接的多关系SQL查询,模拟真实场景如GROUP BY、TOP-K等)。数据集以Parquet和CSV格式提供,便于不同工具使用。数据来源于open-index/hacker-news镜像,遵循CC BY-SA 4.0许可证。

This dataset consists of sampled comments and stories from the full year 2025 of the public Hacker News archive, paired with curated dictionaries of substring patterns and precomputed match labels. It is intended for testing text-search and substring-matching code on real, messy English text, including multi-byte characters, HTML entities, embedded URLs, mixed casing, CVE identifiers, version strings, and the long tail of forum slang. The dataset is organized into two main components: a text pool (containing comments and stories) and a pattern pool (including topics, categories, domains, bans, and allow patterns). It also features multiple workload configurations, categorized into Q-family (flat texts x patterns pairs for isolating substring matchers) and HQ-family (multi-relation SQL queries embedding one or two LIKE joins within realistic shapes such as GROUP BY, TOP-K, etc.). The dataset is provided in both Parquet and CSV formats for compatibility with various tools. The data is sourced from the open-index/hacker-news mirror and is distributed under the CC BY-SA 4.0 license.
提供机构:
open-index
搜集汇总
数据集介绍
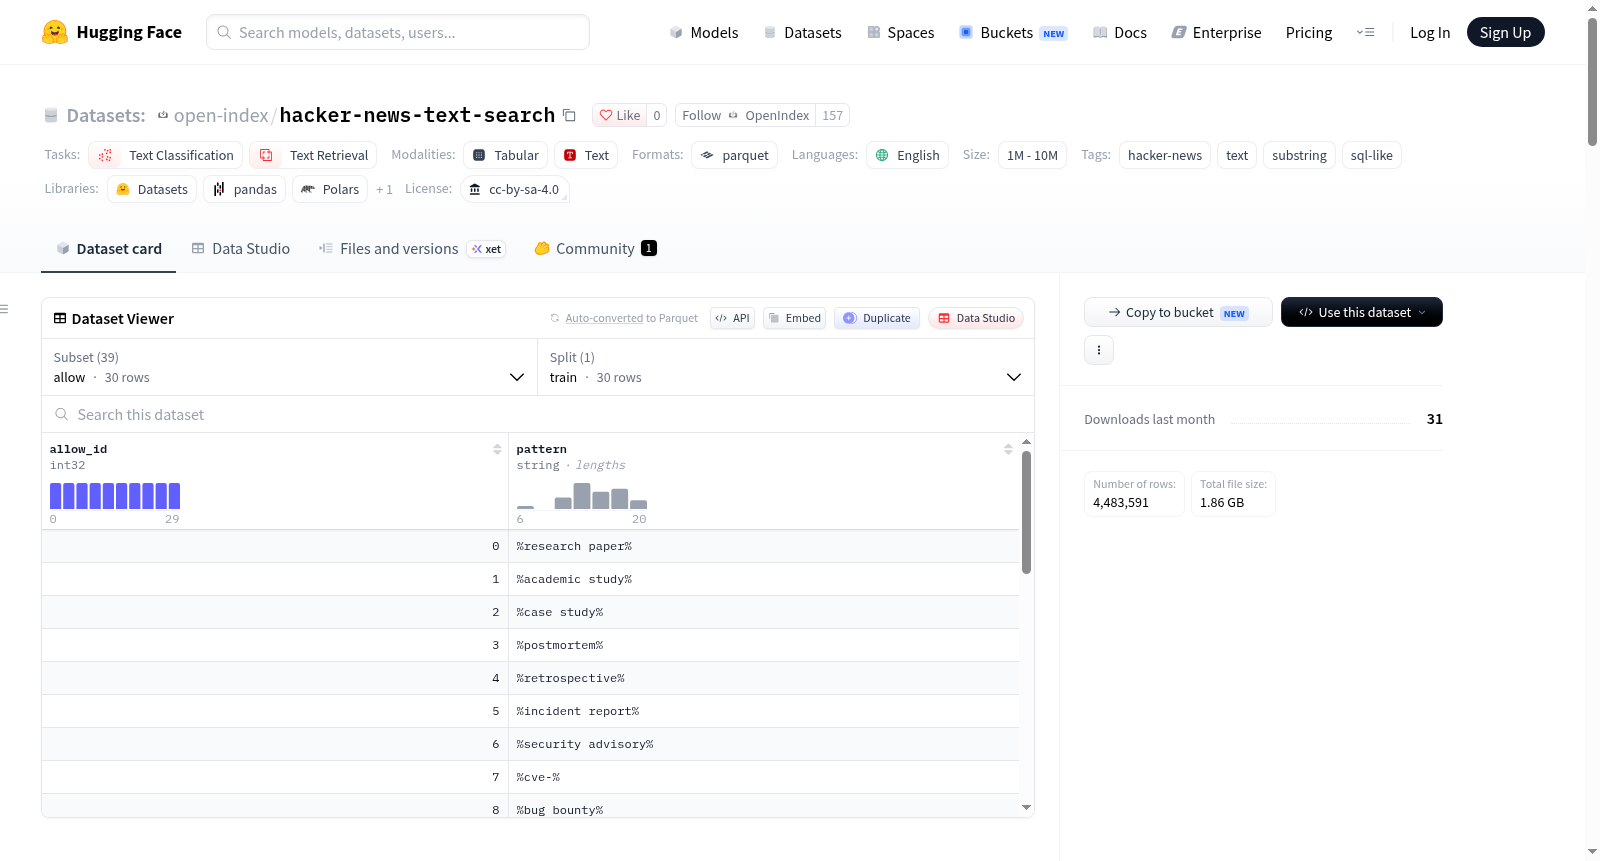
open-index/hacker-news-text-search 数据集图片
构建方式
该数据集以公开的Hacker News 2025年全年存档为原始语料,经过去除已删除与封禁记录、剥离HTML标签等清洗流程后,形成包含3,398,696条评论与310,384篇故事的主文本池。评论与故事分别以text_id和story_id为键,保留时间戳、作者、父节点、标题、URL及评分等元数据。在文本池基础上,构建主题、类别、域名、封禁与允许等模式字典,并针对每项工作负载以BLAKE2b哈希在(工作负载标识,行标识)上确定性抽取子集,生成模式文件和匹配标签,确保重复运行的行选取一致。
特点
该数据集的核心特征在于将真实、嘈杂的英文论坛文本与精心策划的子串模式字典及预计算匹配标签相配对,覆盖多字节字符、HTML实体、内嵌URL、大小写混合、CVE标识、版本字符串及论坛俚语等复杂情形。数据集分为Q族与HQ族:Q族提供扁平化的文本与模式对,便于隔离子串匹配逻辑;HQ族则在GROUP BY、TOP-K、COUNT DISTINCT及EXISTS等现实SQL形态中嵌入一到两个LIKE连接。Parquet与CSV双格式并存,兼顾类型化快速浏览与原始下载便利,并以CC BY-SA 4.0许可再分发。
使用方法
使用者可通过Hugging Face datasets库加载数据集,指定comments或stories配置获取规范文本池,再选择任意工作负载配置分别加载patterns与labels划分。标签中的text_id需回连至text_pool/comments.parquet或stories.parquet以获取对应文本,从而在不重复存储文本的前提下统一基线。Python示例展示了加载q1_trending_M100的模式与标签并统计匹配数量的流程。对于HQ族工作负载,可结合目录内的query.sql复现多关系查询形态;本地复现则可参考配套处理仓库,针对相同上游分区与月份重新运行清洗与生成管线。
背景与挑战
背景概述
随着社交媒体与论坛文本的爆炸式增长,面向真实世界杂乱英文文本的高效子串检索与模式匹配成为数据库与信息检索领域的核心课题。2025年,open-index团队基于公开的Hacker News全年存档,构建了hacker-news-text-search数据集,涵盖逾339万条评论与31万篇故事,并配以精心策划的子串模式字典及预计算匹配标签。该数据集旨在为文本搜索与SQL LIKE查询引擎提供统一基准,推动多字节字符、HTML实体、URL及版本号等复杂场景下的匹配算法评测,对查询优化与文本处理社区具有重要参考价值。
当前挑战
该数据集所应对的领域问题在于,真实论坛文本中普遍存在多字节UTF-8字符、HTML实体、混合大小写、嵌套URL及CVE标识符等噪声,传统子串匹配算法难以兼顾准确性与效率。构建过程中亦面临多重挑战:从上游海量数据中过滤已删除与失效内容,剥离HTML标签并保持文本语义完整性;设计覆盖趋势词、短语、位置约束及Unicode边界的多样化模式字典;确保工作负载在固定采样下可复现,并妥善处理因安全签名而需剔除的敏感文本。这些因素共同构成了对匹配引擎鲁棒性与可扩展性的严峻考验。
常用场景
经典使用场景
在文本检索与子串匹配的评测领域中,该数据集凭借对Hacker News真实语料的系统采样,构建了文本池与模式池相分离的双层结构,并以扁平Q族与多关系HQ族两类工作负载覆盖了从单模式扫描到复杂SQL查询的完整谱系。研究者可借助q1至q8系列隔离评估匹配器性能,亦可利用hq1至hq6系列考察LIKE连接在GROUP BY、TOP-K、COUNT DISTINCT等真实查询形态下的执行效率,从而在统一文本基线上完成跨引擎、跨算法的可复现对比。
衍生相关工作
围绕该数据集,下游工作已在多个方向展开:基于其文本池与模式池的分离设计,研究者构建了面向子串匹配算法的标准化测试框架;HQ族查询所附带的query.sql与边缘配置,被用于考察向量化执行引擎与查询编译器的优化策略;此外,该数据集与上游open-index镜像及处理流水线的公开关联,亦促进了Hacker News语料在文本挖掘与信息检索任务中的再利用与方法学延伸。
数据集最近研究
最新研究方向
在文本检索与模式匹配领域,针对真实网络文本中多字节字符、HTML实体、混合大小写等杂乱特性的鲁棒性评估日益受到关注。hacker-news-text-search数据集通过提供2025年全年的Hacker News评论与故事文本,并配以精心策划的子串模式字典及预计算匹配标签,为测试文本搜索与子串匹配代码在真实、杂乱英语文本上的性能提供了基准。该数据集涵盖Q-family和HQ-family两类工作负载,前者隔离子串匹配器,后者将LIKE连接嵌入GROUP BY、TOP-K、HAVING COUNT DISTINCT等现实SQL形状中,推动了面向复杂查询的匹配算法研究。其与SQL-like模式、CVE标识符、版本字符串等热点内容的关联,使其在安全过滤、趋势分析等场景中具有重要影响,为评估和优化文本检索系统提供了可复现的标准化平台。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

