
遇见数据集

open-index/cc-host-dataset

收藏
Hugging Face2026-06-19 更新2026-06-21 收录
官方服务:

资源简介:

CC Host Dataset — CC-MAIN-2026-21是一个基于Common Crawl的URL索引数据集,提供主机级别的排名信号。该数据集覆盖整个Common Crawl,每个被爬取的URL都作为一行数据,包含20个原始CDX字段和来自CC网络图的谐波中心性排名。数据集大约包含19亿个URL,涉及约2.62亿个主机。它支持多种用途,如URL查询、内容变化检测和多爬取比较,并采用Parquet格式存储,适用于特征提取和文本分类任务。数据来源于Common Crawl,遵循ODC-By许可证。

CC Host Dataset — CC-MAIN-2026-21 is a per-URL index of the entire Common Crawl with host-level rank signals. Every URL captured by the crawler becomes one row, enriched with 20 raw CDX fields and harmonic centrality rank from the CC web graph. The dataset covers roughly 1.9 billion URLs across ~262 million hosts. It supports various use cases such as URL lookup, content change detection, and multi-crawl comparison, stored in Parquet format, and is suitable for tasks like feature extraction and text classification. The data is derived from Common Crawl and released under the ODC-By license.
提供机构:
open-index
搜集汇总
数据集介绍
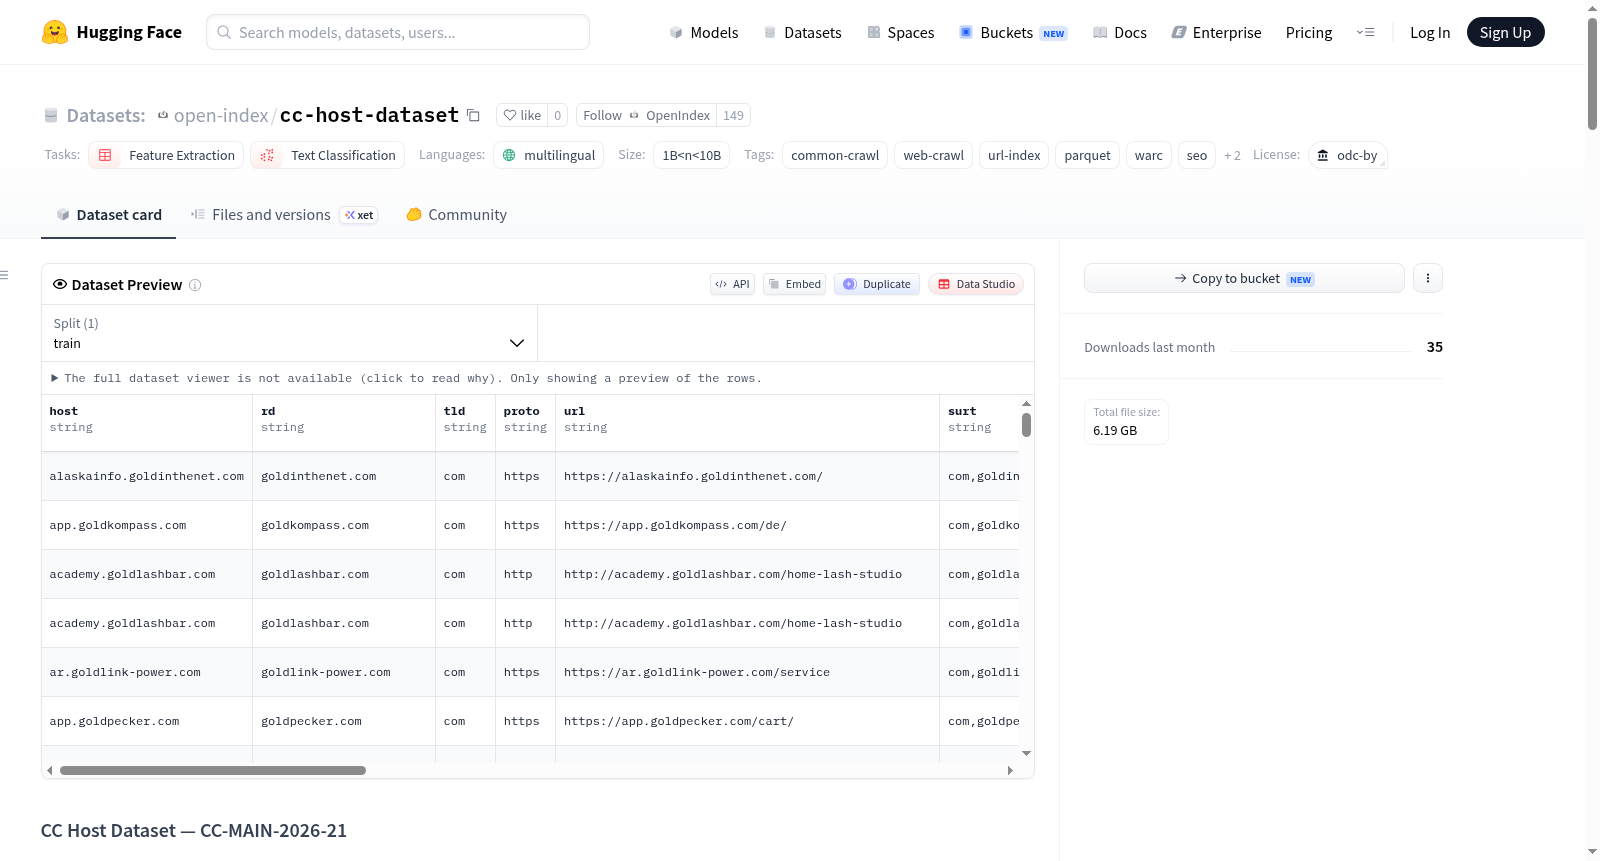
open-index/cc-host-dataset 数据集图片
构建方式
本数据集依托Common Crawl项目,针对CC-MAIN-2026-21爬取批次构建而成。构建流程分为四步:首先,并行下载全部302个CC CDX Parquet文件,利用Go语言的parquet-go库仅提取所需的20个字段,并通过单次遍历将数据分发至28个按前缀划分的gzip-JSONL写入器;其次,下载约5 GB的CC网页图谱主机排名表,同样拆分为28个按前缀组织的文件;然后,对每个前缀,将排名映射加载至内存(约300 MB),逐行处理JSONL流,将每条记录与其所属主机的排名信息进行连接,最终输出为ZSTD压缩的Parquet分片;最后,每个分片构建完成后立即提交至HuggingFace平台,提交路径遵循data/crawl={crawl}/subset=urls/hosts-{prefix}.parquet的格式,支持在全部280个分片完成前即可使用。
特点
该数据集为每一个Common Crawl捕获的URL提供了一行记录,涵盖约19亿个URL及2.62亿个主机。每条记录包含20个原始CDX字段,如URL身份信息(完整URL、SURT规范形式、主机名、注册域名、顶级域及协议)、爬取结果(HTTP状态码、重定向目标、时间戳及WARC记录长度)、内容特征(MIME类型、字符集、语言及SHA-1内容哈希)以及WARC文件指针(相对路径、字节偏移量和robots.txt允许标志)。此外,数据集还引入了来自CC网页图谱的主机级排名信号,包括harmonic centrality和PageRank的位置与原始分数,为网页分析提供了多维度的语义丰富信息。数据以Parquet格式存储,采用列式高效压缩,便于大规模查询和分析。
使用方法
数据集支持多种高效使用方式。基于DuckDB的无下载查询最为便捷,通过安装httpfs扩展并利用read_parquet函数即可直接读取HuggingFace上的Parquet文件进行SQL分析,例如筛选返回HTTP 200状态码且语言为英文的前20个主机并按其harmonic centrality排名排序。Python用户可通过HuggingFace Datasets库以流式方式加载数据集,适合内存受限环境下的逐行处理。对于需要访问原始HTML内容的场景,可结合DuckDB获取WARC文件路径和偏移信息,再通过HTTP Range请求直接从Common Crawl服务器获取并解压对应字节范围的数据。数据集还支持跨爬取批次的变化检测,利用SHA-1内容哈希对比不同批次同一URL的摘要值,量化内容变动比例。所有Parquet文件采用Hive分区命名,DuckDB能自动识别crawl和subset字段,便于进行多批次联合查询。
背景与挑战
背景概述
CC Host Dataset是由开放索引社区(open-index)于2026年构建的大规模Web索引数据集,旨在为Common Crawl语料库中约19亿条URL提供主机级别的排名信号。该数据集整合了CDX元数据字段与Web图谐波中心性排名,覆盖约2.62亿个主机,成为研究Web结构、内容演化与搜索引擎优化的关键资源。其构建过程采用纯Go语言并行处理302个CDX Parquet文件,并依赖HuggingFace进行流式发布,显著降低了大规模Web数据的使用门槛。该数据集的发布为自然语言处理、Web挖掘和信息检索领域提供了标准化、可重复利用的基准,推动了多语言网页理解、排名算法验证以及跨爬取周期内容变更检测等研究方向的进展。
当前挑战
CC Host Dataset所应对的核心领域挑战在于Web规模数据的稀疏性与异构性——传统网页索引难以有效捕获主机级别的全局拓扑特征,而该数据集通过融合CDX字段与Web图中心性指标,为大规模URL分析提供了结构化支持。构建过程中面临的技术挑战包括:高效处理超过184 GB的CDX Parquet文件并实现列投影以减少I/O开销;将5 GB的Web图排名表与每个URL进行内存连接,同时管理约300 MB的排名索引以避免性能瓶颈;以及确保280个分片的分布式构建与实时发布同步,避免数据一致性问题。此外,多语种URL的编码处理、时间戳对齐与重定向链追踪也增加了数据清洗的复杂性。
常用场景
经典使用场景
CC Host Dataset作为Common Crawl索引的增强版本,在互联网规模的数据分析领域具有广泛的应用价值。经典使用场景包括基于URL级别的大规模Web内容检索与过滤,研究者可通过该数据集的CDX字段快速定位到特定域名的所有抓取记录,并结合HTTP状态码、MIME类型和语言标签进行细粒度筛选。此外,数据集内置的PageRank和Harmonic Centrality排名信号,使其在大规模网页排名计算与URL级重要性评估方面成为黄金标准,研究人员能够直接利用这些预计算指标进行权威性分析,无需重新计算整个Web图的排名。
解决学术问题
该数据集有效解决了大规模Web数据在多维度交叉分析时的碎片化问题。学术研究中,传统方式需分别处理CDX索引、WARC文件记录和Web图排名数据,耗费大量计算资源。CC Host Dataset将约19亿个URL的20个CDX字段与6个Web图排名信号整合为统一的Parquet格式,实现了零成本连接操作。这一突破性设计使得跨爬虫版本的内容变化检测、域名级SEO趋势演化和多语言Web生态比较研究成为可能,显著降低了大数据环境下Web科学研究的数据准备门槛。
衍生相关工作
该数据集的发布催生了一系列重要的衍生研究工作。基于Harmonic Centrality排名信号,研究者开发了新型Web内容新鲜度评估模型,利用多爬虫版本的摘要对比自动发现搜索引擎索引延迟模式。CC Host Dataset的分片架构启发了高效的大规模Web数据集构建工具链,如ccrawl CLI成为行业标准。在自然语言处理领域,该数据集丰富的语言标签和内容摘要信息被用于构建多语言语料库过滤管线,推动了低资源语言的Web语料获取技术发展。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

