
遇见数据集

DriveTDPA CARLA Driving Datasets

收藏
github2026-09-02 更新2026-09-03 收录
官方服务:

资源简介:

DriveTDPA 项目的公开数据门户,用于组织和展示 CARLA 自动驾驶实验产生的数据。它将仿真传感器、Autoware 状态、动态 BEV、Talk2BEV 场景描述、DriveTDPA 轨迹预测、偏好选择、控制指令和下一帧反馈串联成可以追踪、验证和复现实验的场景记录。

The open data portal of the DriveTDPA project is used to organize and display data generated from CARLA autonomous driving experiments. It integrates simulated sensors, Autoware states, dynamic BEV, Talk2BEV scene descriptions, DriveTDPA trajectory prediction, preference selection, control commands and next-frame feedback into scene records that enable tracking, verification and reproduction of experiments.

创建时间:
2026-08-31
原始信息汇总

DriveTDPA是一个公开的CARLA自动驾驶实验数据门户,用于组织展示仿真实验数据。该数据集将CARLA仿真传感器、Autoware状态、动态BEV、Talk2BEV场景描述、DriveTDPA轨迹预测、偏好选择、控制指令和下一帧反馈串联成可追踪、验证和复现实验的场景记录。

技术链路

数据采集与处理链路涵盖以下环节:

  • CARLA相机/LiDAR/GNSS/IMU/车辆状态采集
  • CARLA ROS Bridge传输
  • Autoware定位、感知、地图、路由处理
  • 动态BEV生成
  • Talk2BEV场景事实与文字描述
  • DriveTDPA推理、动作与3秒轨迹预测
  • preference selector安全候选轨迹选择
  • Autoware规划与控制
  • CARLA车辆执行
  • 下一帧状态与闭环指标获取

偏好对均来自同一CARLA场景、同一帧输入的多次DriveTDPA rollout,不使用无关输入或伪造数据构造偏好样本。

数据内容

每一帧数据包含八个主要阶段的记录:

数据阶段 具体内容 文件格式
CARLA传感器 前视RGB、LiDAR、车辆位姿与速度 JPG/PNG、PCD/BIN、JSON
ROS Bridge 带时间戳的ROS 2 Topic与TF rosbag2 DB3/MCAP
Autoware 定位、目标、路由、规划轨迹、控制指令 ROS 2消息、JSON导出
动态BEV 自车、目标、占用栅格、车道关系与风险 JSON、PNG
Talk2BEV 结构化场景事实与自然语言描述 JSON/JSONL
DriveTDPA 推理、3步动作、6点轨迹、延迟 JSON/JSONL
偏好选择器 候选轨迹、评分、chosen/rejected标签 JSON/JSONL
闭环结果 t时刻控制与t+1时刻车辆反馈 JSON/JSONL

数据集版本计划

当前计划发布四个数据集版本,均采用source: "carla"

  1. dataset-carla-v0.1:CARLA、Autoware、BEV、Talk2BEV和DriveTDPA多模态帧(计划中)
  2. dataset-carla-preference-v0.1:CARLA场景候选轨迹组和偏好对(计划中)
  3. dataset-carla-closed-loop-v0.1:控制指令到下一帧反馈的闭环片段与指标(计划中)
  4. dataset-carla-preference-experiment-v0.1:已录制CARLA种子上的真实模型多采样和偏好选择(自动持续采集中)

计划中表示已预留数据规范和发布位置,不代表完整数据已采集或通过验证。

仓库结构

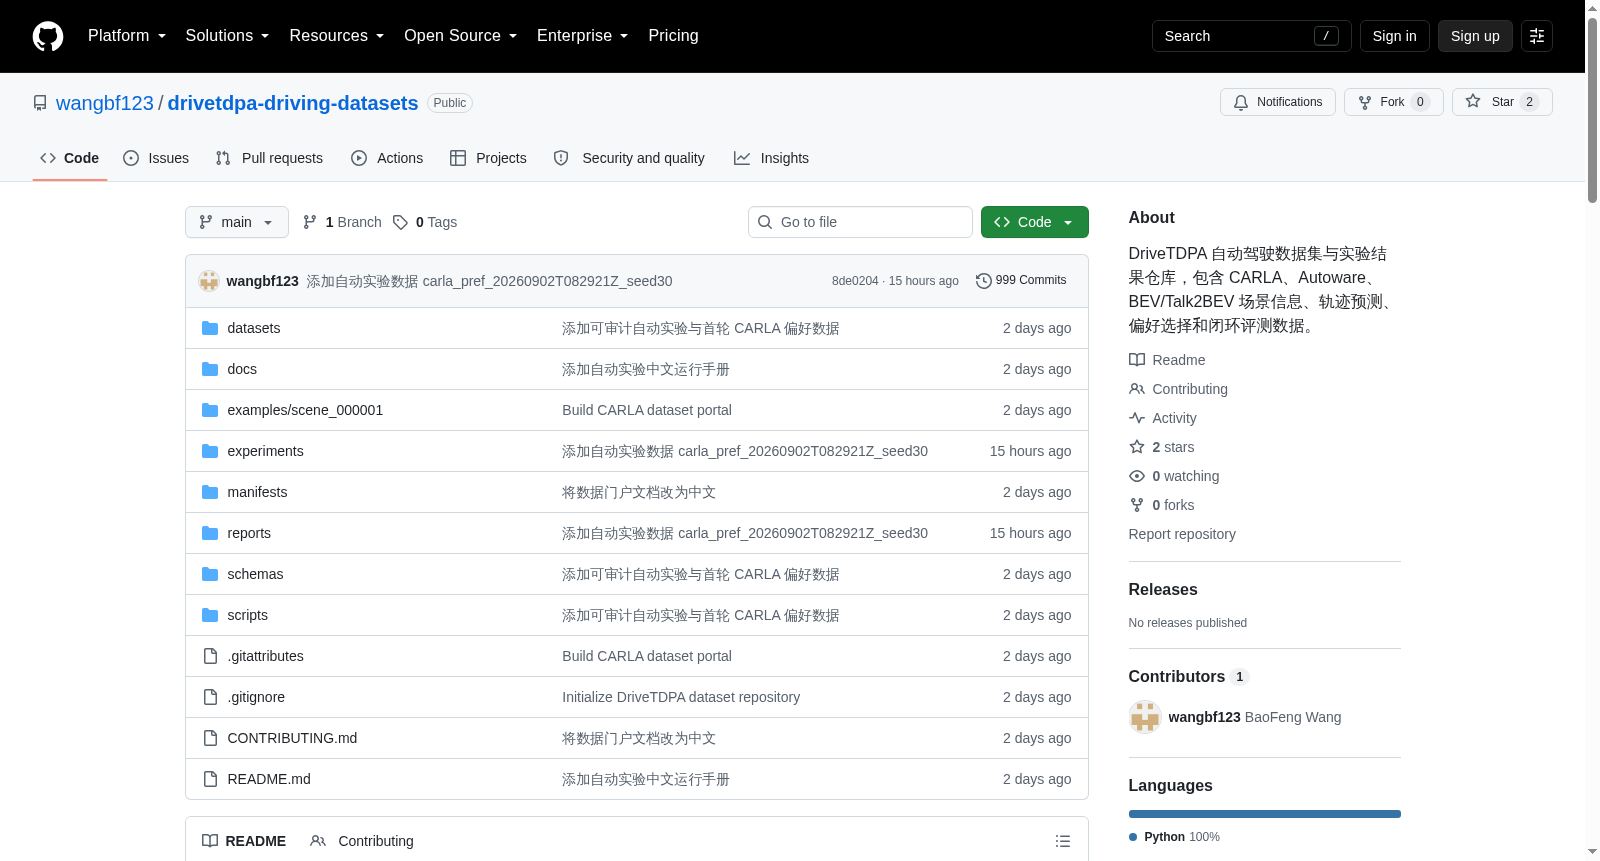
  • docs/:架构、采集协议、字段说明、ROS Topic文档
  • datasets/:正式数据集发布位置与存储约定
  • manifests/:场景及大文件机器可读索引
  • schemas/:自动校验用JSON Schema
  • examples/:小型CARLA格式示例场景
  • reports/:实验汇总、指标与图表
  • experiments/:自动实验run、机器可读索引、逐文件校验和
  • scripts/:数据校验、校验和与安全下载工具

验证工具

数据校验工具仅依赖Python 3.9+标准库,验证方式包括:

  • 场景清单validate_dataset.py校验
  • generate_checksums.py脚本生成校验和
  • experiments/runs上运行validate_experiment.py验证实验
  • 完整数据下载后按下载工具自动验证SHA256

数据存储与真实性规则

GitHub存储文档、Schema、小型示例、manifest、校验和、图表和报告;完整相机序列、点云、rosbag2、地图、视频和模型权重存入阿里云OSS或公开数据集平台。每个正式文件须在manifest中记录文件大小和SHA256。

真实性核心规则包括:

  • CARLA仿真器状态、碰撞信号、配置路线可视为Ground Truth,但须保留来源和配置
  • 模型生成的描述、推理、动作、轨迹均为预测结果,不可标为Ground Truth
  • 偏好判断模型不可见reward、rank、未来真值或chosen/rejected标签
  • 非有限数值、碰撞、越界轨迹不可被preference selector选中
  • 所有数据以稳定dataset_version、scene_id、frame_id和CARLA时间戳关联

当前状态

数据规范、格式示例和自动实验预发布数据已公开。examples/目录仅用于说明格式;experiments/runs/包含经过真实模型、真实judge、loader和SHA256校验的小型CARLA recorded-seed实验包,并非完整实时闭环数据集,不可视为Ground Truth。
搜集汇总
数据集介绍
DriveTDPA CARLA Driving Datasets 数据集图片
构建方式
DriveTDPA CARLA 自动驾驶数据集依托CARLA高保真仿真环境,构建了一条从多传感器采集到闭环反馈的完整数据链路。数据采集起始于CARLA模拟器同步输出的相机、LiDAR、GNSS、IMU及车辆状态信息,经ROS Bridge转换后送入Autoware自动驾驶系统,依次完成定位、感知、地图构建与路由规划。随后,系统生成动态鸟瞰视图(BEV),并由Talk2BEV模块提炼出结构化场景事实与自然语言描述,为DriveTDPA模型提供推理基础。模型输出3秒轨迹预测后,经偏好选择器基于安全准则筛选候选轨迹,最终由Autoware规划控制指令驱动CARLA车辆执行,并将下一帧的车辆反馈与闭环指标回传,形成逐帧可追溯的闭环记录。所有数据均以统一的manifest文件索引,采用JSON、PNG、PCD等标准格式存储,并附有数据字典与JSON Schema,确保数据结构的严整性与可验证性。
特点
该数据集最显著的特点在于其多模态融合与全链路闭环设计。每一帧数据均同步涵盖原始传感器流、ROS中间消息、Autoware决策状态、动态BEV表示、语言化场景描述、轨迹预测结果及偏好评分,使研究者能够深入解析从感知到决策再到控制的每个环节。数据真实性规则极为严苛,明确区分仿真真值(如车辆状态、碰撞信号)与模型预测(如场景描述、轨迹),杜绝将模型输出误标为Ground Truth,确保基准测试的可靠性。偏好对数据严格来源于同一场景、同一输入下的多次DriveTDPA rollout,不掺入任何跨场景或伪造样本,从而保证偏好学习的纯净性。此外,实验包内置真实模型与校验和验证,支持SHA256完整性校验,极大提升了数据的可信度与可复现性,为自动驾驶决策安全研究提供了坚实的数据基石。
使用方法
使用者可通过仓库提供的Python标准库工具集进行数据校验、校验和生成与安全下载。首先,执行validate_dataset.py脚本验证示例场景的manifest文件结构,利用generate_checksums.py计算场景内文件的校验和,以确保数据完整性。对于自动实验包,validate_experiment.py可对experiments/runs目录下的run进行一致性检查。当正式数据集清单(如dataset-carla-v0.1)发布后,借助download_dataset.py指定manifest文件与scene_id,脚本将自动从HTTPS源下载对应场景数据并执行SHA256核对,拒绝任何占位符或无效链接。所有实验数据均可在本地复现,通过读取JSON/JSONL文件分析各链路阶段,亦可结合Autoware与CARLA环境模拟原始运行条件。数据字典与ROS Topic文档提供了字段级说明,便于研究人员快速定位所需信息,实现从轨迹分析到闭环性能评估的全方位探索。
背景与挑战
背景概述
DriveTDPA CARLA Driving Datasets 是由 DriveTDPA 项目于近期构建并公开的自动驾驶仿真数据集,旨在支撑端到端自动驾驶系统的可复现研发与验证。该数据集由项目团队精心设计,以 CARLA 仿真器为核心,整合了 Autoware 自动驾驶栈、动态鸟瞰图(BEV)、Talk2BEV 场景描述、轨迹预测、偏好选择及闭环反馈等多模态数据,形成了一条从感知到决策再到控制的完整数据链路。其核心研究问题在于为自动驾驶决策模块提供细粒度的、可追踪的场景化数据,以支持安全轨迹筛选与强化学习等方法的训练与评估。该数据集的特色在于其对数据来源与真实性的严格标注,区分了仿真真值与模型预测,并提供自动校验与 SHA256 完整性验证,为开放科学和跨机构对比提供了可靠基准,对自动驾驶领域的安全决策研究具有推动意义。
当前挑战
在领域问题层面,该数据集面临的挑战主要源自自动驾驶决策场景的复杂性与安全性要求。鉴于真实路测数据难以大规模获取且难以复现,仿真数据虽可扩展,但需确保场景多样性覆盖长尾问题,如动态障碍物交互与极端天气,同时需避免闭环仿真中累积误差导致的分布偏移。具体而言,构建过程中面临多重挑战:数据规范与真实场景的严格对齐,需定义机器可读的 schema 以统一多模态异构数据;偏好数据的生成需在同一场景同一帧下重复 rollout,以确保偏好对的有效性,但计算成本高昂;防止偏好模型通过窥探标签引入偏差,要求严格的隔离设计;以及实现从 CARLA 状态到 Autoware 控制闭环的时序同步与数据关联,确保时空一致性。此外,大体积数据(如点云与视频)的存储与发布、shasum 校验的自动化,以及数据版本管理的复杂性,亦是构建中的实际困难。
常用场景
经典使用场景
该数据集主要用于自动驾驶系统的端到端闭环仿真评估与多模态感知-决策协同研究。研究者可利用CARLA渲染的传感器流(相机、LiDAR、GNSS/IMU)与Autoware输出的定位、感知、规划信息,构建以动态鸟瞰图为中心的场景表示。结合Talk2BEV的自然语言场景描述,数据集支持对可解释驾驶决策的定量分析,例如在复杂路口或动态障碍物场景下,验证轨迹预测模型在3秒时间窗内的行为合理性。其规范化的数据格式与时间戳同步机制,使得每一帧均可作为独立输入,驱动轨迹预测、候选轨迹排序或闭环控制策略的模块化测试与纵向对比。
解决学术问题
该数据集直击自动驾驶研究中仿真数据碎片化与真值定义模糊的痛点。通过将传感器原始数据、Autoware中间状态及DriveTDPA预测输出统一在CARLA场景时间轴下,解决了多源数据对齐困难、难以追溯模型决策因果链的学术难题。其严格的真实性约束——仅将仿真器状态与路线配置视为Ground Truth,而生成式模型输出与偏好判断结果均视为预测——为以人类偏好优化驾驶策略的研究提供了无偏采样框架。该设计支持在无碰撞、无越界且数值稳定的前提下,开展大规模偏好学习实验,从而推动可解释性轨迹规划与人类价值对齐方向的研究进展。
衍生相关工作
依托该数据集,衍生出一系列开创性研究方向。一方面,动态BEV与Talk2BEV描述的联合使用催生了多模态融合感知的新范式,例如结合场景语义先验的占用栅格预测网络,或基于语言提示的风险区域注意力机制。另一方面,DriveTDPA的6点轨迹输出与偏好选择器的配对结构,激发了将对比学习应用于驾驶风格建模的工作,类似差分规划但以安全指标为约束。闭环指标(如t时刻指令与t+1时刻响应的偏差)进一步支撑了控制残差学习与仿真到现实迁移研究。平台公开的校验工具与模式规范也促进了可复现实验文化,在CARLA生态中树立了数据完整性基准。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

