
遇见数据集

stanforddams/biglocal

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

ICE新闻稿数据集是一个结构化数据集,包含965篇由美国移民和海关执法局(ICE)发布的新闻稿,这些新闻稿从ice.gov网站抓取而来。该数据集由斯坦福大学的Big Local News创建,为记者提供了一个机器可读的记录,涵盖了ICE关于执法行动的公开声明。与ICE的行政数据(仅记录逮捕、驱逐和转移,但缺乏个人细节)不同,新闻稿通常包含个人姓名、年龄、国籍、指控以及以叙事形式描述的执法行动具体细节。该数据集以结构化字段捕获这些文本信息,并附带提取的元数据,适用于命名实体识别、信息提取和问责新闻业。语料库主要集中在2025年和2026年(965条记录中的956条),反映了该时期ICE执法活动和新闻稿发布量的激增。数据集语言为英语,许可为美国政府作品(公共领域)。

A structured dataset of 965 press releases published by U.S. Immigration and Customs Enforcement (ICE), scraped from ice.gov. Created by Big Local News at Stanford University, this dataset gives journalists a machine-readable record of ICEs own public statements about enforcement actions. ICE administrative data logs arrests, removals, and transfers but includes very little detail about individuals. Press releases are different: ICE routinely names people, lists ages, nationalities, and charges, and describes the specifics of each action in narrative form. This dataset captures that text in structured fields alongside extracted metadata, making it useful for named entity recognition, information extraction, and accountability journalism. The corpus is heavily skewed toward 2025 and 2026 (956 of 965 records), reflecting the surge in ICE enforcement activity and press release volume during that period. Language(s) (NLP): English. License: U.S. Government Works (public domain).
提供机构:
stanforddams
搜集汇总
数据集介绍
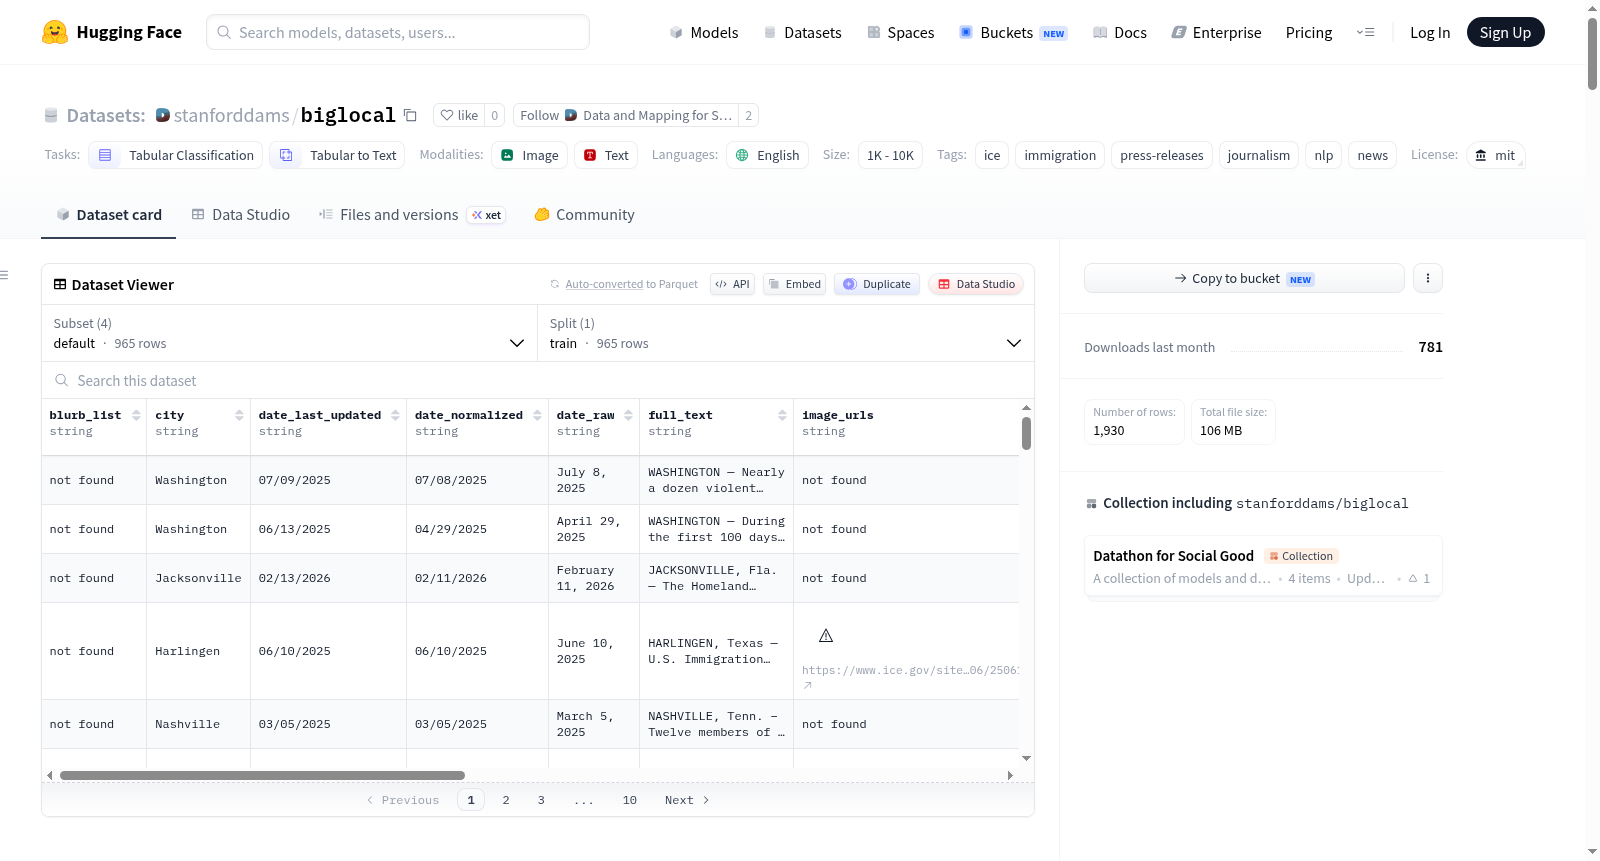
stanforddams/biglocal 数据集图片
构建方式
Biglocal数据集由斯坦福大学Big Local News团队构建,旨在为记者提供美国移民与海关执法局(ICE)公开声明的机器可读记录。数据源自ICE官方网站的新闻发布页面,通过自动化爬虫脚本下载了965篇原始HTML文件,经解析提取标题、副标题、主题、日期、地点及全文文本等结构化字段,并将日期标准化为MM/DD/YYYY格式,同时从新闻电头中抽取城市与州信息。最终以CSV、NDJSON及原始HTML三种格式导出,确保数据灵活可用。
特点
该数据集涵盖965条记录,核心特点在于其丰富的元数据与文本内容,包含标题、主题、标准化日期、位置信息及全文文本等15个字段,为命名实体识别、信息抽取和主题分类等自然语言处理任务提供了坚实基础。数据时间分布高度集中于2025年至2026年,占比达98.9%,反映了这一时期ICE执法活动与新闻发布量的激增。地理分布上以德克萨斯州、华盛顿特区等地为主,主题以执法与遣返类居多,呈现出鲜明的领域聚焦特征。
使用方法
用户可通过HuggingFace Datasets库便捷加载数据,支持default(CSV)、csv、ndjson及raw_html四种配置,分别对应结构化表格、流式处理及原始HTML源码。推荐将full_text字段作为自然语言处理任务的主要输入源。此外,数据集附带了完整的爬取与解析代码示例,用户可参考notebooks目录下的Jupyter脚本构建自动化流水线,实现对新发布新闻的持续采集与处理,以满足动态报道需求。
背景与挑战
背景概述
在新闻分析与公共问责领域,政府机构发布的新闻稿是揭示政策执行细节与行政叙事的重要信息来源。然而,诸如美国移民和海关执法局(ICE)等机构发布的新闻稿多以非结构化HTML网页形式呈现,缺乏机器可读的结构化版本,这为大规模信息提取与新闻报道中的事实核查带来了显著障碍。为应对这一挑战,斯坦福大学Big Local News团队于2026年创建了BigLocal数据集,该数据集系统性地抓取了ICE官网自2014年至2026年间发布的965篇新闻稿,将其转化为包含标题、正文、地理位置与发布日期等15个结构化字段的表格数据。数据集的构建紧密围绕Datathon for Social Good 2026项目目标,旨在为记者和研究者提供一种将新闻稿叙事与行政逮捕、遣返记录相链接的可靠工具,从而提升对移民执法行动报道的完整性与准确性。截至目前,该数据集已广泛应用于命名实体识别、信息抽取、主题分类以及问责新闻报道等下游任务,成为连接公开声明与行政数据的桥梁,对计算新闻学与社会正义研究产生了重要影响。
当前挑战
BigLocal数据集在构建与应用过程中面临着多重挑战。首先,在领域问题层面,该数据集旨在解决从非结构化政府新闻稿中自动化提取执法行动细节(如具体时间、地点、涉事人员身份信息)的难题,但ICE新闻稿本身蕴含强烈的机构叙事偏向,其呈现的案件信息并非行政数据的完整或客观映射,可能缺乏对未高调宣传事件的记录,从而引入选择偏差。其次,在数据构建过程中,团队遇到了诸多技术性困难:原始HTML页面解析时需处理18%覆盖率极低的副标题与54%的图像字段,手工编写启发式规则提取城市与州名在边缘案例中易产生错误;此外,数据集时间分布极不均衡,98.9%的记录集中在2025至2026年,这使得跨行政周期的纵向分析缺乏足够的历史参照,且数据采集仅依赖单次快照(2026年5月22日),未能实现持续增量更新。更为严峻的是,新闻稿中直接包含被执法个体的姓名与指控信息,却未提供任何关于法律判决阶段或后续结果的语义标注,这要求使用者严格遵守新闻伦理与法律标准,避免将未决指控视为既定事实进行报道。
常用场景
经典使用场景
该数据集收录了美国移民与海关执法局(ICE)发布的965份新闻稿文本,内容涵盖执法行动、人口贩运、儿童剥削等多类主题。在自然语言处理领域,它常被用于命名实体识别任务,从文本中自动提取涉案人员的姓名、年龄、国籍及指控信息。同时,其结构化的元数据字段(如日期、地点)为信息抽取提供了可靠的标注基础,支持构建从非结构化新闻稿到结构化执法事件记录的自动化映射。此外,该数据集还能服务于主题分类任务,将新闻稿按ICE官方分类体系进行归并,为分析执法重点的动态演变提供语料支撑。
解决学术问题
该数据集有效填补了结构化行政数据与叙事性公开声明之间的信息鸿沟。传统ICE行政日志仅记录逮捕、遣返等操作的数量,缺乏个体层面细节;而新闻稿虽包含丰富描述,却缺乏机器可读的统一格式。该数据集的构建使得研究者得以将新闻稿文本与行政记录进行链接,从而系统性地分析执法行动的分布特征、叙事策略与公共话语建构。它推动了计算社会科学领域关于政府机构公开信息透明度与问责性的研究,为评估执法宣传与实际操作之间的差异提供了量化工具。
衍生相关工作
基于该数据集,学术界与业界已衍生出一系列标志性工作。在自然语言处理方向,研究者开发了针对法律文本的命名实体识别模型,微调后的模型在涉案人名、指控名称及日期实体抽取上达到高精度。在计算社会科学领域,有工作利用该数据集进行执法叙事框架分析,通过主题建模与情感分析揭示不同时期ICE对外宣传的重点转向。同时,原始项目中的爬取与分析管道被复用至其他政府机构新闻稿的采集,形成了可迁移的数据采集模板,推动了政府公开声明数据的结构化处理标准的确立。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

