
遇见数据集

stanforddams/daily

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

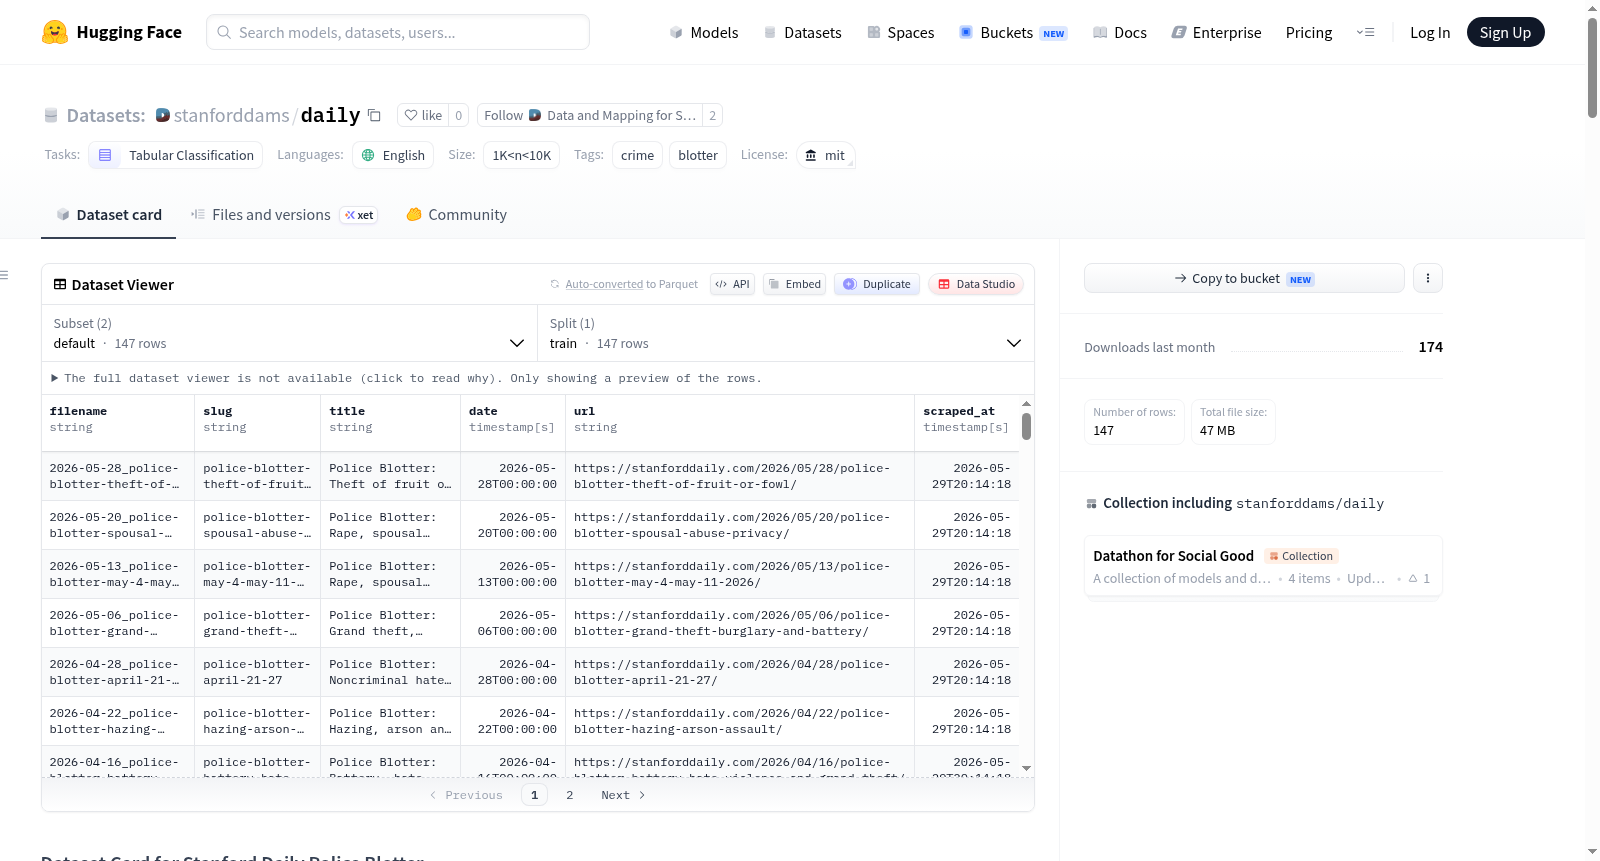
斯坦福日报警方日志数据集收集了147篇由《斯坦福日报》在2021年6月至2026年5月期间发布的警方日志文章,涵盖了斯坦福大学校园及周边报告的犯罪事件。数据集包括原始HTML页面和结构化元数据索引,用于自然语言处理(NLP)、信息提取和犯罪模式分析。数据来源为斯坦福日报的网站,通过WordPress REST API和HTML页面下载收集,语言为英语,内容版权归斯坦福日报所有,收集用于研究和新闻目的。

A collection of 147 police blotter articles published by The Stanford Daily between June 2021 and May 2026, covering crimes reported on and around the Stanford University campus. Raw HTML pages are saved from the original articles alongside a structured metadata index. This dataset collects five years of those articles for NLP, information extraction, and crime pattern analysis. Source: The Stanford Daily; Collection method: WordPress REST API + HTML page download; Language: English; License: Content copyright The Stanford Daily; collected for research and journalism purposes.
提供机构:
stanforddams
搜集汇总
数据集介绍
stanforddams/daily 数据集图片
构建方式
该数据集名为daily,源自斯坦福日报(The Stanford Daily)自2021年6月至2026年5月间发布的147篇警方日志(police blotter)文章。这些文章记录了斯坦福大学校园内及周边发生的犯罪事件,信息来源于斯坦福大学公共安全部(SUDPS)的官方出警日志。数据集的构建采用了两阶段策略:首先通过WordPress REST API接口,以'police blotter'为关键词进行检索,并对2021年5月29日之后发表的文章进行筛选,最终获取到分布于两个API页面的共147篇帖子;随后,对每篇帖子的完整HTML页面进行下载与保存,形成以发布日期和URL片段命名的'.html'文件。同时,基于API响应中的元数据字段,构建了结构化的索引文件'index.json',其中包含每篇文章的文件名、标题、发布日期、原始URL及抓取时间戳等信息,为后续的文本分析与信息提取提供了清晰的导航基础。
特点
该数据集的核心特点在于其双重数据结构:既包含原始HTML格式的完整网页内容,又提供了轻量级的结构化元数据索引,便于研究者根据需求灵活选择分析粒度。时间跨度覆盖五年(2021年至2026年),共收录147篇文章,平均每年约29篇,呈现出较为稳定的发布频率,有利于捕捉校园犯罪报道的长期趋势。值得注意的是,数据集中的HTML文件平均大小约为311KB,总体积约47MB,且包含了页面导航栏、侧边栏等非文章主体元素,这为文本解析任务带来了挑战,但也提供了训练健壮性提取算法的真实场景。此外,该数据集未经人工标注,保留了信息提取任务的原始复杂性,适用于命名实体识别、信息抽取及文本分类等自然语言处理任务。
使用方法
用户可通过HuggingFace Datasets库便捷地加载该数据集。加载元数据索引时,使用`load_dataset('org/stanford-daily-blotter')`命令;若需访问原始HTML文件,则指定配置`load_dataset('org/stanford-daily-blotter', 'raw_html')`。为从HTML中提取纯净的文章文本,建议使用BeautifulSoup库,定位`div`元素且class属性为'post-content'的节点,因其通常包含新闻正文,可有效过滤导航栏及侧边栏等干扰内容。该数据集适用于命名实体识别(如提取犯罪类型、地点、日期)、信息抽取(构建结构化犯罪记录)、文本分类(按犯罪类型或严重程度分类)以及犯罪模式分析等任务。需注意,数据集不应被用于识别或监视个人,也非校园犯罪的完整记录,不适用于法律执法场景。
背景与挑战
背景概述
该数据集由斯坦福大学日报社(The Stanford Daily)于2026年创建,核心研究人员包括数据主管Jay Gupta等,旨在系统收集2021年6月至2026年5月间发布的147篇校园警察日志文章。这些文章基于《克莱里法案》要求公开的斯坦福大学公共安全部门犯罪记录,覆盖校内及周边区域的犯罪事件类型、时间和地点。作为新闻与信息科学交叉领域的研究资源,该数据集为自然语言处理中的命名实体识别、信息抽取及犯罪模式分析提供了结构化素材,对理解校园安全报道的长期趋势和跨学科研究具有重要价值。
当前挑战
该数据集面临的核心挑战包括:一是领域问题层面,警察日志文本的叙述风格存在记者与年份间的显著差异,导致事件类型、地点和日期等实体的一致性提取困难,且《克莱里法案》的地理限制使数据仅覆盖部分校园事件,存在选择性偏差;二是构建过程中,原始HTML文件包含导航栏、侧边栏等无关页面元素,需精准定位文章正文解析,同时数据集缺乏标注信息,无法直接用于监督学习,需额外开发自动抽取流程以应对非结构化的犯罪报告记录。
常用场景
经典使用场景
在自然语言处理与计算犯罪学交叉领域,daily数据集作为一篇篇结构化程度适中的校园警情日志文本集合,其经典使用场景集中于命名实体识别(NER)与信息抽取任务。研究者可借助该数据集从非结构化的犯罪叙述中精准提取犯罪类型、案发地点与时间等关键要素,构建结构化的犯罪事件记录。此外,该数据集的时序跨度涵盖五个学年,为校园犯罪趋势的时间序列分析提供了连续且可比的文本源,支持跨季度、跨年度的犯罪模式演变研究。同时,文本分类任务也可在此之上落地,依据犯罪描述将其归入不同的犯罪类别或严重等级,从而检验分类模型在安全领域的泛化能力。
解决学术问题
该数据集的有效构建,解决了校园安全信息抽取与犯罪文本分析中长期以来缺乏高质量、标注透明且可复现的学术基准这一痛点。在学术研究层面,它填补了基于真实校园警情日志的NLP评测资源空白,使研究者能够聚焦于从自然语言文本中自动化提取结构化犯罪记录这一核心难题。其意义在于推动信息抽取技术向具有社会价值的垂直领域迁移,为评估不同NER模型、关系抽取方法以及事件抽取框架在犯罪文本上的表现提供了统一的测试平台。此外,该数据集的引入也促进了跨学科对话,使得计算方法能够深入理解Clery法案下的校园犯罪报告机制,助力数据驱动的犯罪预防策略研究。
衍生相关工作
围绕daily数据集,一系列衍生工作已在NLP与计算社会科学领域相继涌现。研究者们借鉴其数据收集与处理范式,开发了面向其他大学警情日志的可迁移信息抽取框架,推动了跨校园犯罪报告分析的标准化进程。部分工作基于该数据集构建了结合时空特征的犯罪事件知识图谱,将抽取出的实体与关系链接至外部地理与时间维度的知识库,显著增强了犯罪模式挖掘的深度。此外,也催生了一批针对低资源场景下犯罪文本预训练语言模型微调策略的研究,探索如何利用有限的标注样本实现高效的实体识别与分类,这些工作共同拓展了安全文本分析的方法论边界,并持续反哺着校园公共安全领域的数据驱动创新。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

