
遇见数据集

SeFi-Image/SeFi-Image-SemVAE-Demo

收藏
Hugging Face2026-07-19 更新2026-07-22 收录
官方服务:

资源简介:

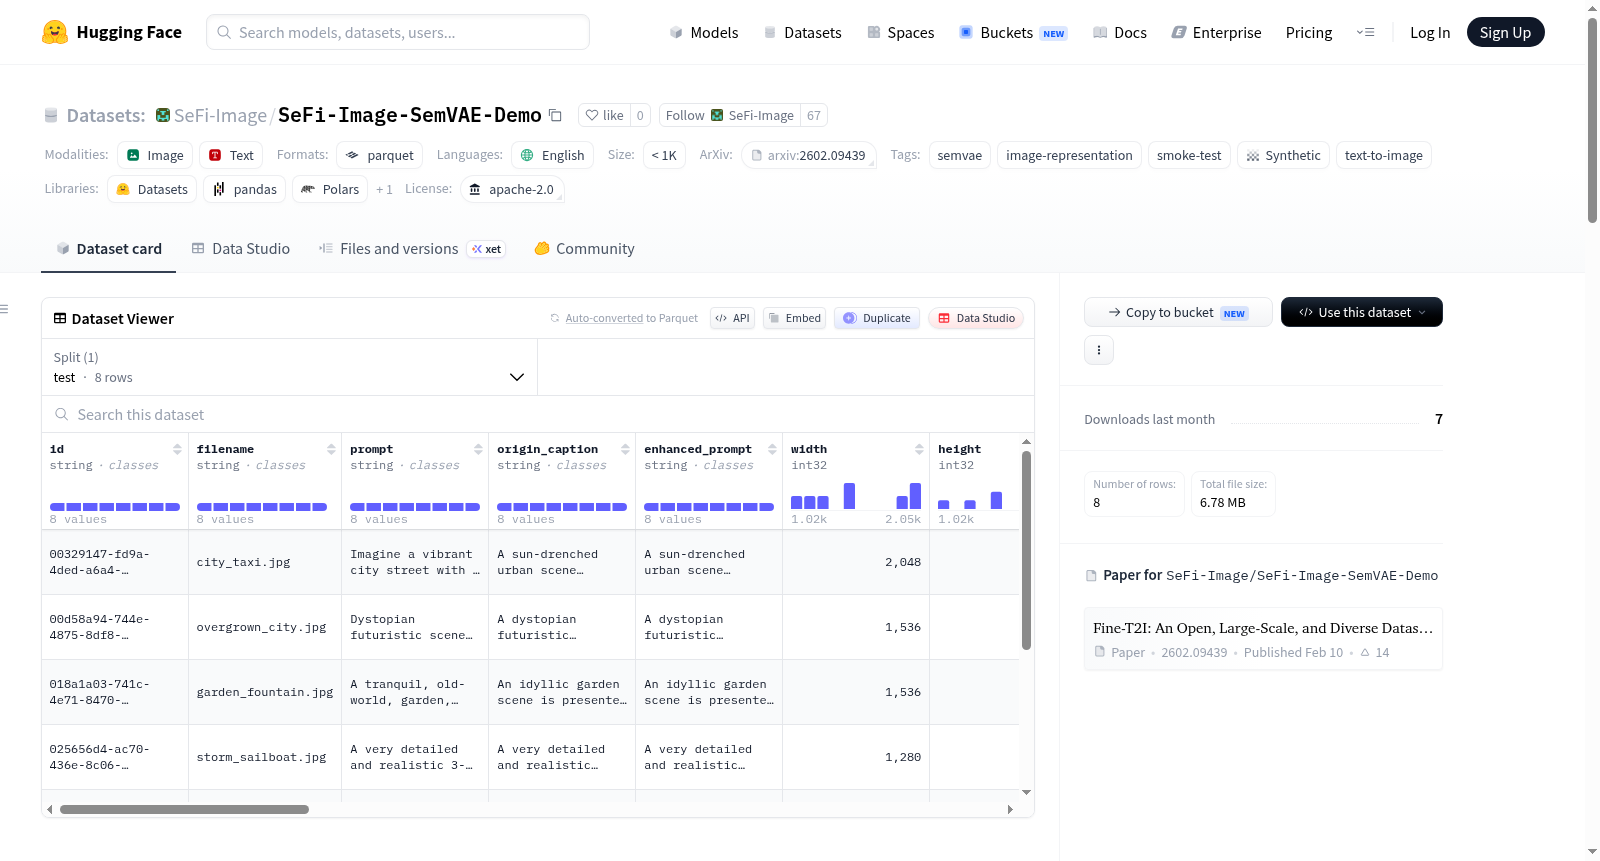
SeFi-Image SemVAE演示数据集是一个包含8个独立合成图像的小型数据集,专门用于测试公共SeFi-Image SemVAE加载器和特征压缩路径。这是一个烟雾测试夹具,而非训练集或评估基准。每个样本以两种形式提供:一是images/目录下的普通JPEG格式,便于基于路径的命令行示例;二是嵌入在test Parquet分割中的图像字节,用于数据集加载器示例。数据来源于ma-xu/fine-t2i数据集的synthetic_enhanced_prompt_random_resolution子集,使用Apache-2.0许可证。数据集字段包括图像ID、文件名、图像数据、宽高、SHA256哈希、提示词、原始标题、增强提示词、上游元数据以及SemVAE令牌余弦相似度等。

The SeFi-Image SemVAE Demo dataset is a small collection of eight standalone synthetic images for testing the public SeFi-Image SemVAE loader and feature-compression path. This is a smoke-test fixture, not a training set or an evaluation benchmark. Each sample is available in two forms: as an ordinary JPEG under the images/ directory for path-based command-line examples, and as embedded image bytes in the test Parquet split for dataset-loader examples. The data is repackaged from the synthetic_enhanced_prompt_random_resolution subset of the ma-xu/fine-t2i dataset under the Apache-2.0 license. Data fields include image ID, filename, image data, width, height, SHA256 hash, prompt, origin caption, enhanced prompt, upstream metadata, and SemVAE token cosine similarity metric.
提供机构:
SeFi-Image
搜集汇总
数据集介绍
SeFi-Image/SeFi-Image-SemVAE-Demo 数据集图片
构建方式
该数据集为SeFi-Image SemVAE模型的轻量级烟雾测试套件,包含八张独立合成图像。所有样本均源自ma-xu/fine-t2i数据集中synthetic_enhanced_prompt_random_resolution子集,经像素级无损重构而成。每张图像以两种形式呈现:一是JPEG原始文件存储于images目录,适用于命令行参数调用;二是以嵌入图像字节形式封装于Parquet分片中,便于数据集加载器直接处理。数据字段涵盖图像元数据、文本提示、上游溯源信息及风格类别标签,并包含semvae_token_cosine确定性重建质量指标。
特点
该数据集核心价值在于验证SeFi-Image SemVAE特征压缩管线的功能完整性,而非作为训练集或评估基准。其合成图像由Z-Image-Turbo与FLUX.2-dev两种生成器产生,涵盖城市街景、喷泉庭院、林间草地等多样化场景。数据集严格排除了真实图像子集,确保测试场景的纯粹可控性。每张图像均附带prompt、origin_caption与enhanced_prompt三重文本标注,并记录精确的上游数据源版本哈希,实现了端到端的可追溯性。
使用方法
用户可通过Hugging Face CLI快速获取单张测试图像,指定镜像路径与本地目录即可完成下载。若需批量处理,则利用datasets库加载Parquet分片,以Python字典形式访问图像张量与对应文本提示。数据集中manifest.json与Parquet行均记录了每个样本的唯一标识符与哈希校验值,便于用户验证数据完整性。使用时需遵守Apache-2.0许可协议,若在烟雾测试之外场景引用,建议一并标注上游Fine-T2I工作的作者信息与arXiv论文条目。
背景与挑战
背景概述
SeFi-Image-SemVAE-Demo数据集由SeFi-Image团队于2026年创建,旨在为SemVAE(语义变分自编码器)的图像表征与特征压缩路径提供轻量级的功能验证工具。该数据集源于Fine-T2I项目(由Xu Ma、Yitian Zhang、Qihua Dong和Yun Fu等研究人员主导),通过精心筛选8幅合成图像构成独立的冒烟测试(smoke-test)基准。在文本到图像生成与潜在空间表征学习领域,SemVAE致力于弥合高维视觉特征与语义信息之间的鸿沟,而该演示数据集为开发者提供了快速验证加载、预处理与编码流程的标准化样本,避免了大规模训练集的冗余开销。其简洁的配置(8条样本、双格式存储)显著降低了入门门槛,推动了SemVAE工具链的社区采纳与可复现性研究。
当前挑战
该数据集面临的挑战主要体现在两个方面。首先,在领域问题层面,SemVAE需要解决图像表征中语义信息的紧凑编码难题,即如何在保持高重构保真度的同时(如检查的平均余弦相似度需超过0.80),将图像压缩为离散的语义令牌序列,这要求编码器能捕获跨模态的细粒度对应关系。其次,在构建过程中,数据集的来源一致性至关重要:所有样本必须严格校验自Fine-T2I数据集的固定修订版本(保证像素级哈希匹配),但源图像由多种生成器(如Z-Image-Turbo与FLUX.2-dev)产生,其风格与质量差异可能引入隐式偏置。此外,数据集刻意排除真实图像,导致在泛化能力测试上存在局限,需依赖上游基准的扩展验证。
常用场景
经典使用场景
SeFi-Image-SemVAE-Demo数据集作为一套精巧的合成图像测试夹具,其核心经典用途在于验证SeFi-Image SemVAE模型的加载器与特征压缩管线的功能完整性。该数据集包含八幅独立合成的JPEG图像,每幅图像均以原始文件形式和嵌入在Parquet分片中的字节形式双重呈现,为开发者提供了从命令行到数据集加载器的多路径测试入口。通过执行烟雾测试,研究者能够快速确认图像预处理、令牌切片及压缩等关键环节是否按预期运转,从而在正式开展大规模训练或评估前,确保基础设施的稳健性与可复现性。这一轻量级设计尤其适合作为持续集成流程中的自动化验证环节,有效降低了因环境差异或代码变更引发的潜在错误风险。
解决学术问题
在学术研究层面,该数据集主要解决了图像表示学习领域中一个常被忽视的基础性问题——实验环境的可控验证与可复现性保障。许多研究因依赖复杂的数据流水线而难以隔离故障来源,SeFi-Image-SemVAE-Demo通过提供标准化的、哈希校验过的合成样本,使学者们能够精确地诊断其特征提取模型在加载、预处理与压缩阶段的行为。其所附带的确定性重建度量指标(如令牌余弦相似度)为评估管线输出的一致性提供了量化基准,从而避免了因数据加载异常而导致的实验偏差。这一贡献虽小却至关重要,它促进了研究社区在共享代码与模型时,能够拥有一个公认的参考点,增强了科学结论的可靠性。
衍生相关工作
该数据集衍生出的相关工作紧密围绕其上游与下游的技术生态。其上游根基源于Fine-T2I数据集中的合成增强提示子集,该工作由Ma等人提出,旨在为文本到图像微调提供大规模、多样化的训练资源,并已在arXiv上发布相关论文。下游方向则直接指向SeFi-Image SemVAE模型本身——一个专注于图像语义特征压缩与表示的专用架构。基于此数据集作为验证基准,后续研究很可能会探索改进的令牌余弦度量方法、更高效的特征压缩算法,或是将其测试框架扩展到其他视觉表示模型。这些衍生工作共同构建了一个从数据生产、模型验证到性能评估的闭环,推动了图像表示领域基础设施的标准化进程。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

