
遇见数据集

pashto-translated-psychology

收藏
Hugging Face2026-06-27 更新2026-06-29 收录
官方服务:

资源简介:

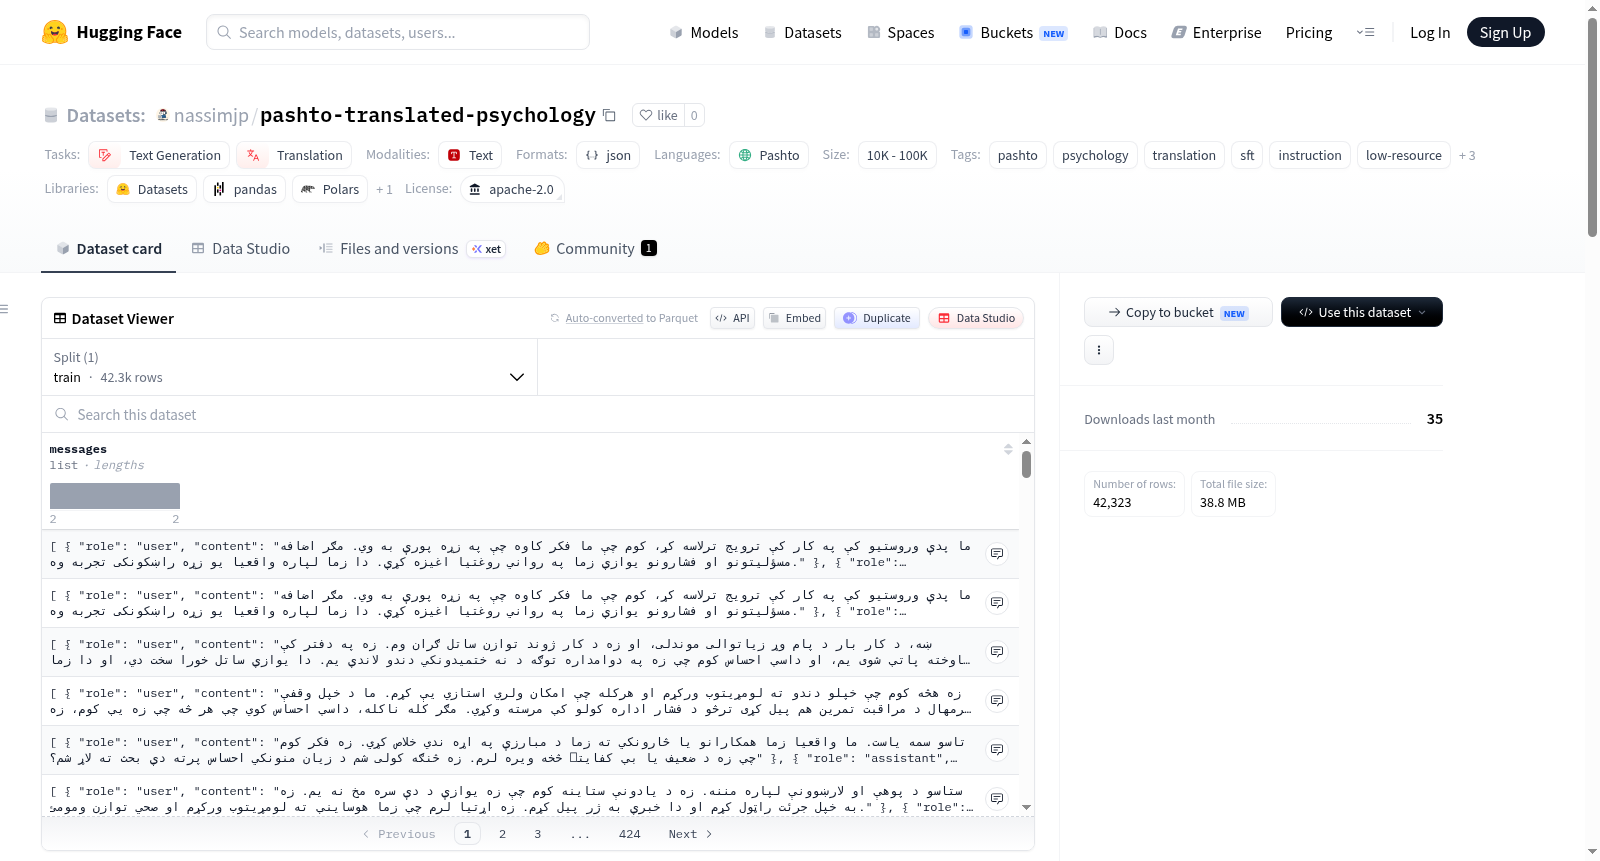
该数据集包含翻译成普什图语的简短、清晰、领域特定的心理学条目,专为普什图语大语言模型对齐、心理健康推理任务、情感感知对话、短上下文监督微调训练以及低资源语言研究而优化。每个条目长度不超过500字符,确保数据简洁,适用于快速训练、令牌高效的微调和移动友好型模型开发。数据格式为JSON对象,每行包含一个input字段(普什图语提示)和一个output字段(普什图语翻译的心理学回答),例如输入为د اضطراب نښې څه دي?(焦虑的症状是什么?),输出为相应的心理学解释。数据集规模在1,000到10,000个样本之间,属于文本生成和翻译任务范畴,使用Apache 2.0许可证,允许研究和商业用途。预期应用包括构建普什图语指令调优模型、心理健康聊天机器人、领域特定推理系统,并支持对Qwen、LLaMA、Ministral、Gemma等模型的微调。需要注意的是,该数据集不能替代专业心理学建议,翻译可能存在细微风格差异,建议在部署时与安全对齐数据集结合使用以增强模型安全性。

This dataset provides short, clear, domain-specific psychology entries translated into Pashto, optimized for Pashto large language model alignment, mental health reasoning tasks, emotion-aware dialogues, short-context supervised fine-tuning training, and low-resource language research. Each entry is no longer than 500 characters, ensuring conciseness for fast training, token-efficient fine-tuning, and mobile-friendly model development. The data format is JSON objects, each line containing an input field (Pashto prompt) and an output field (Pashto-translated psychology answer), e.g., input د اضطراب نښې څه دي? (What are the symptoms of anxiety?) and output the corresponding psychological explanation. The dataset size ranges from 1,000 to 10,000 samples, falling under text generation and translation tasks, licensed under Apache 2.0 for research and commercial use. Intended applications include building Pashto instruction-tuning models, mental health chatbots, domain-specific reasoning systems, and supporting fine-tuning for models like Qwen, LLaMA, Ministral, and Gemma. Note that this dataset is not a substitute for professional psychological advice, translations may have subtle stylistic variations, and it is recommended to combine with safety-aligned datasets during deployment to enhance model security.
创建时间:
2026-06-27
搜集汇总
数据集介绍
pashto-translated-psychology 数据集图片
构建方式
该数据集精心汇集了经过专业翻译的心理学科普条目,将英文心理学语料精准转化为普什图语。每一条目均严格控制字符数在500以内,以JSON格式组织,其中'input'字段承载普什图语的心理咨询或知识性提示,而'output'字段则提供对应的翻译解答。构建过程聚焦于简洁性与领域纯净度,确保语料既贴近心理健康场景,又适用于低资源语言的模型对齐任务。
特点
数据集具有鲜明的领域专精特性,涵盖焦虑识别、情绪管理及心理健康常识等核心主题,条目短小精悍且语义完整。其最大亮点在于填补了普什图语在心理推理与情感对话上的数据空白,非常适合用于短上下文的有监督微调。此外,数据规模适中,既保证了训练效率,又为低资源语言研究提供了高质量的基准语料。
使用方法
用户可通过HuggingFace的datasets库直接加载,仅需一行代码'load_dataset("nassimjp/pashto-translated-psychology")'即可获取训练集。该数据集专为普什图语指令微调模型设计,尤其适合开发心理健康聊天机器人或提升多语言大模型在普什图语上的情感理解能力。使用时需注意搭配安全对齐数据集以确保部署可靠性,且不应替代专业的心理咨询服务。
背景与挑战
背景概述
普什图语作为全球约5000万人口使用的语言,在自然语言处理领域却长期处于低资源状态,尤其在心理健康这一高度敏感且专业性强的子领域,缺乏高质量的标注数据成为制约大语言模型服务该语言群体的主要瓶颈。由研究者nassimjp主导创建的普什图语翻译心理学数据集(Pashto Translated Psychology)于近年来发布,其核心研究问题在于为低资源语言构建面向心理健康的指令微调数据,从而推动普什图语大语言模型的情感感知推理与对话能力发展。该数据集通过将心理学短条目翻译为普什图语,每条控制在500字符以内,以适配高效训练与移动端部署,为普什图语社区的心理健康技术支持以及低资源语言NLP研究提供了开创性的基础资源。
当前挑战
该数据集所解决的领域挑战在于,普什图语在心理健康对话与情感推理任务中面临显著的数据稀缺问题,现有模型因缺乏领域特定的指令微调数据而难以理解文化语境下的情绪表达,导致心理健康支持服务在低资源语言群体中近乎空白。构建过程中,最大的挑战在于确保翻译的心理学专业准确性同时兼顾普什图语的语言风格差异,因为心理学概念具有文化敏感性,直译可能引发语义偏差;此外,数据集规模仅数千条,如何在有限样本中保持领域覆盖广度和指令多样性,并对抗长尾概念稀疏性,也是数据筛选与对齐需要克服的困难。
常用场景
经典使用场景
在低资源语言自然语言处理领域,pashto-translated-psychology数据集为普什图语的心理健康领域指令微调提供了稀缺的高质量资源。其经典使用场景集中于对大型语言模型进行领域特定对齐训练,例如将Qwen、LLaMA等通用模型微调为能够理解并回应用户心理困惑的普什图语对话系统。每条样本短小精悍,不超过500字符,这使其特别适合快速迭代的监督式微调流程,能够高效赋能移动端或资源受限环境下的轻量级心理健康助手。研究者常利用该数据集构建情感感知的对话管道,使模型在普什图语环境中准确识别焦虑、抑郁等心理状态并提供初步回应。
实际应用
在实际应用中,该数据集支撑了面向普什图语使用者的心理健康智能服务部署。例如,可基于微调后的模型开发轻量级聊天机器人,用于初步筛查焦虑症状或提供情绪疏导建议,尤其适合阿富汗及巴基斯坦普什图语社区中专业心理健康资源匮乏的地区。数据集也可嵌入到移动端应用程序中,作为情感计算模块的核心训练数据,实现低成本、大规模的用户心理状态辅助评估。此外,其短文本结构便于与对话系统流水线集成,在实时响应场景中显著降低推理延迟,从而提升用户体验与可用性。
衍生相关工作
围绕该数据集已衍生出若干前沿探索工作。研究者利用其作为种子语料,通过回译或半监督方法扩展构建更大规模的普什图语心理健康指令集,推动跨语言情感迁移学习。也有工作将其与多语言情感标注集相结合,探究低资源语言上模型的知识蒸馏效果。此外,部分团队将其纳入普什图语评估基准,用于对比不同量级模型在领域对话流畅性、安全性及情感一致性上的表现。这些衍生研究不仅验证了数据集的有效性,更促进了低资源语言NLP社区在心理健康这一伦理敏感领域中的方法创新与标准建立。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

