
insilicomedicine/URSA-BBs
收藏官方服务:
资源简介:
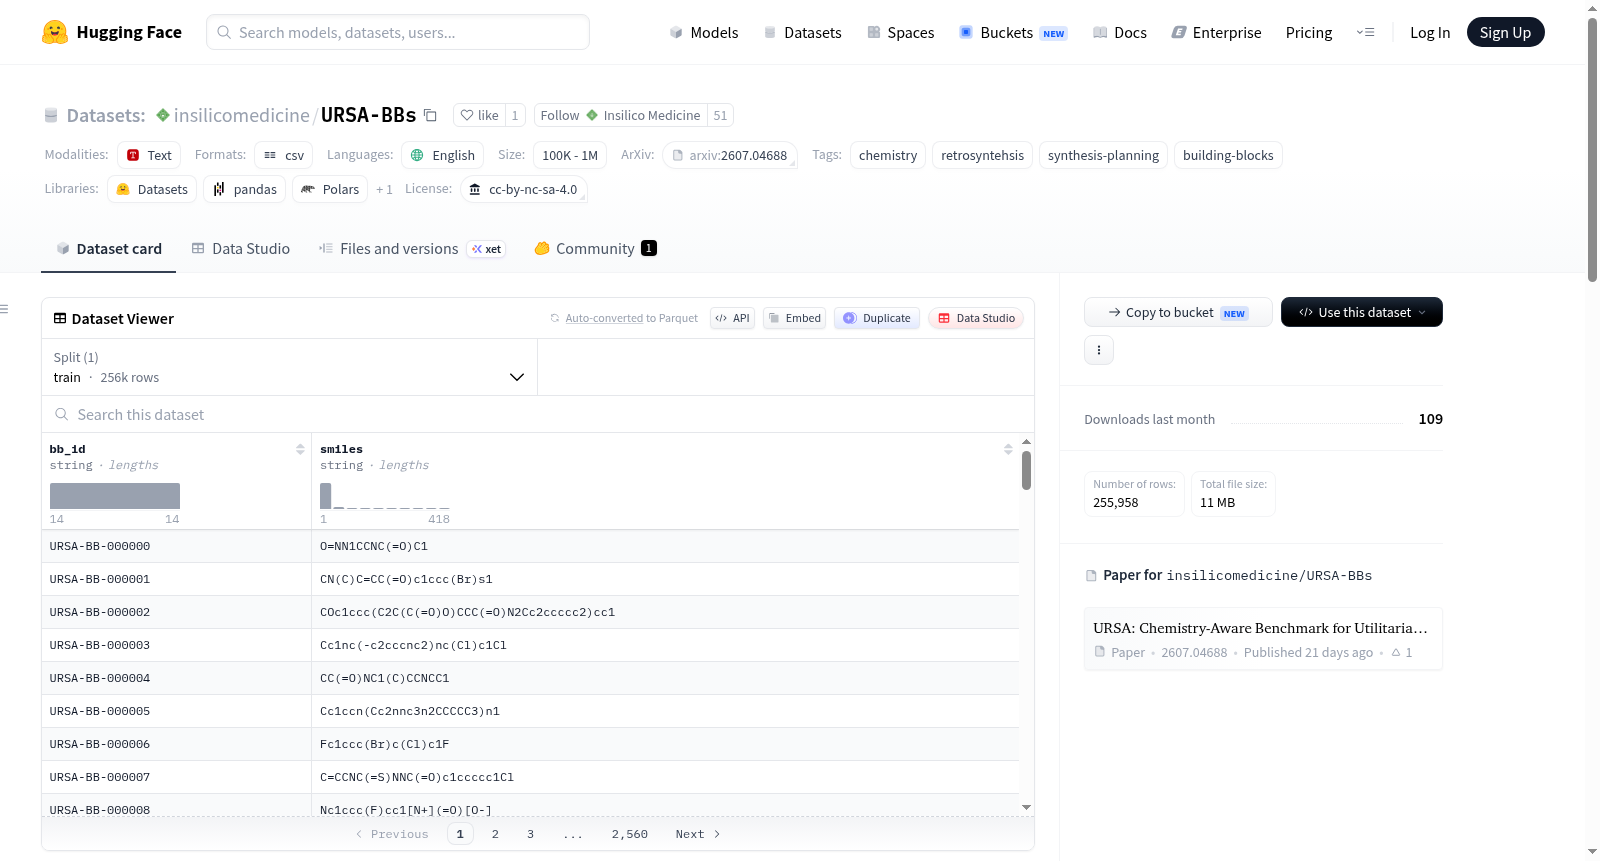
URSA Building Blocks (URSA-BBs) 是一个商业可用构建块的目录,用作URSA逆合成基准测试中的起始材料库存(库存终止参考)。当预测路线的所有终端叶节点都存在于该集合中时,该路线被视为库存终止。这是一个仅包含结构和标识符的简单列表——不重新分发价格、供应商或可用性元数据。
A catalog of commercially available building blocks used as the starting-material stock (stock-termination reference) in the URSA retrosynthesis benchmark. A predicted route is considered stock-terminated when all of its terminal leaves are present in this set. This is a plain list of structures and identifiers — no prices, vendors, or availability metadata are redistributed.
提供机构:
insilicomedicine搜集汇总
数据集介绍
构建方式
URSA-BBs数据集构建于逆合成分析基准测试框架URSA之中,旨在为合成路线规划提供一组明确可用的商业构建块集合。该数据集源于ASKCOS平台公布的“可购买”化学品目录,并经由eMolecules商业数据库独立验证其实际可购性,从而确保每一个包含的化合物均具备商业可得性。所有原始标识符均被替换为URSA内部统一编码(bb_id),每个条目被赋予唯一的URSA-BB编号,并以SMILES格式记录分子结构。最终数据集以单一CSV文件形式封装,包含255,958个条目,仅保留bb_id与smiles两列,不涉及价格、供应商或库存等元数据。这种设计确保了数据结构的高度简洁性与聚焦性,便于在逆合成评价任务中直接作为终止条件使用。
特点
URSA-BBs数据集的显著特点是其专业聚焦于商业可得性验证与标准化标识,从而为逆合成路线规划提供一个可靠且可复现的终止参考集。该数据集规模适中,包含超过25万种结构多样的有机分子,足以覆盖常见合成策略中对起始原料的需求。所有分子均采用SMILES字符串表征,便于与现代化学信息学工具及机器学习模型无缝对接。尤为关键的是,数据集通过双重来源(ASKCOS与eMolecules)验证商业可供性,显著提升了路线规划结果在现实合成中的可行性与可信度。此外,CC BY-NC-SA 4.0许可协议保障了数据集的学术非商业使用与衍生传播,进一步促进了开放科学与协作研究。
使用方法
URSA-BBs数据集的使用方式极为简便,完全兼容Hugging Face Datasets库的标准加载流程。用户只需通过一行Python代码调用load_dataset函数,指定数据集名称及数据文件路径,即可将CSV文件读入为可直接操作的数据集对象。随后,研究人员可遍历数据集中的每一个条目,提取bb_id与smiles字段,在逆合成预测算法中构建终止条件判断逻辑,即当预测路线的所有终端原料均出现在该集合时,视为合成路径到达商业可得的起始原料。该数据集无需额外的数据库或API支持,轻量级设计使其非常适合嵌入现有的机器学习工作流与基准测试框架,促进逆合成分析领域的标准化评估与横向对比。
背景与挑战
背景概述
在逆合成分析领域,商业可得砌块目录是评估合成路线可行性的基石,直接影响着模型预测结果的实用性与可靠性。URSA Building Blocks(URSA-BBs)数据集由Insilico Medicine的研究团队于2026年创建,核心研究人员包括Bogdan Zagribelnyy、Ivan Ilin等人,旨在为URSA逆合成基准测试提供标准化的起始物料参考集。该数据集整合了来自ASKCOS“可购买”目录并经eMolecules独立验证的255,958种商业可得砌块,采用SMILES表示与内部标识符,剔除了价格、供应商等商业元数据。URSA-BBs的发布弥补了逆合成评估中缺乏统一、可复现的终止标准的空白,为化学信息学领域提供了一种公正的评估工具,推动了从算法开发到实际药物合成的桥梁建设。
当前挑战
URSA-BBs面临的核心挑战在于逆合成评估的生态复杂性。首先,解决的核心领域问题是合成路线终止判定的模糊性:传统方法常依赖不透明或过时的商业数据库,导致基准结果难以横向比较;URSA-BBs通过公开可用的砌块目录实现了标准化,但其单一来源(ASKCOS)与有限验证(eMolecules)可能遗漏大量实际可得的替代砌块。其次,构建过程中面临数据清洗与异构性挑战:原始ASKCOS数据需重构标识符并剔除供应商信息,但砌块结构的化学多样性(如立体化学、保护基差异)可能导致SMILES表示歧义,影响下游任务的精确匹配。此外,CC BY-NC-SA 4.0许可限制了商业应用,而砌块目录的时效性(商业可得性频繁变动)要求定期更新,但维护成本高,依赖人工验证难以规模化,最终影响了数据集在工业场景中的实用广度。
常用场景
经典使用场景
URSA-BBs数据集作为逆合成分析基准测试中的起始物料库存参考,是评估逆合成规划算法实用性的核心资源。在逆合成研究中,预测的合成路线需要以可商购的构建模块作为合成终点,而URSA-BBs正是提供了这样一个经过独立验证的商业可得构建模块库。研究者利用该数据集作为检索和判定合成路线是否终止的黄金标准,从而对各类逆合成模型生成的路线进行精准的可行性和完备性评估。该数据集包含超过25万种结构多样的化合物,覆盖了广泛的化学空间,为开发更贴近实际工业需求的逆合成工具奠定了数据基础。
衍生相关工作
基于URSA-BBs数据集,研究社区已衍生出多个标志性工作。其中最为核心的是URSA基准本身,该基准首创性地将构建模块可得性纳入逆合成评估框架,提出了路由穷举率、双分子起始比例等实用性指标。后续工作包括利用该数据集重新训练或微调现有的逆合成模型(如GLN、Retro*等),使其在输出路线时能够主动规避不可购得的起始原料;以及开发基于该库存数据的合成路径可行性预测器,从而在分子发现早期就估计出候选分子的可合成性,展现了该数据集广泛的研究影响力。
数据集最近研究
最新研究方向
URSA-BBs数据集作为逆合成分析基准测试中的起始原料库,正推动着计算化学领域向更加务实、可验证的合成路线规划方向发展。当前前沿研究聚焦于利用该数据集构建和评估深度逆合成模型,尤其是那些追求实际可操作性的“功利性”逆合成评估框架。该数据集的发布与大型语言模型在化学空间中的应用热潮相呼应,通过提供经过商业可得性验证的255,958个构筑块,为研究社区树立了衡量合成路线可行性的黄金标准。其背后关联的URSA基准测试,正促使算法不仅关注新颖性,更注重化学逻辑的严谨性与路径的实用终结条件,从而加速实验室自动化与药物发现流程的智能化升级,对重塑逆合成评估范式具有深远影响。
以上内容由遇见数据集搜集并总结生成


