
Data-Gouv-FR/fanzines-repertories-par-lassociation-meluzine-org
收藏数据链接:
官方服务:
资源简介:
这是Meluzine.org协会数据库表的CSV导出,该协会几十年来记录了法语粉丝杂志的制作。数据集展示了粉丝杂志、它们的系列、制作这些杂志的人群、摘录、价格以及相关事件。
CSV export of database tables from the Meluzine.org association, which has cataloged French-language fanzine productions for several decades. The dataset presents fanzines, their series, the groups of people who produced them, excerpts, prices, and events related to these fanzines.
提供机构:
Data-Gouv-FR搜集汇总
数据集介绍
构建方式
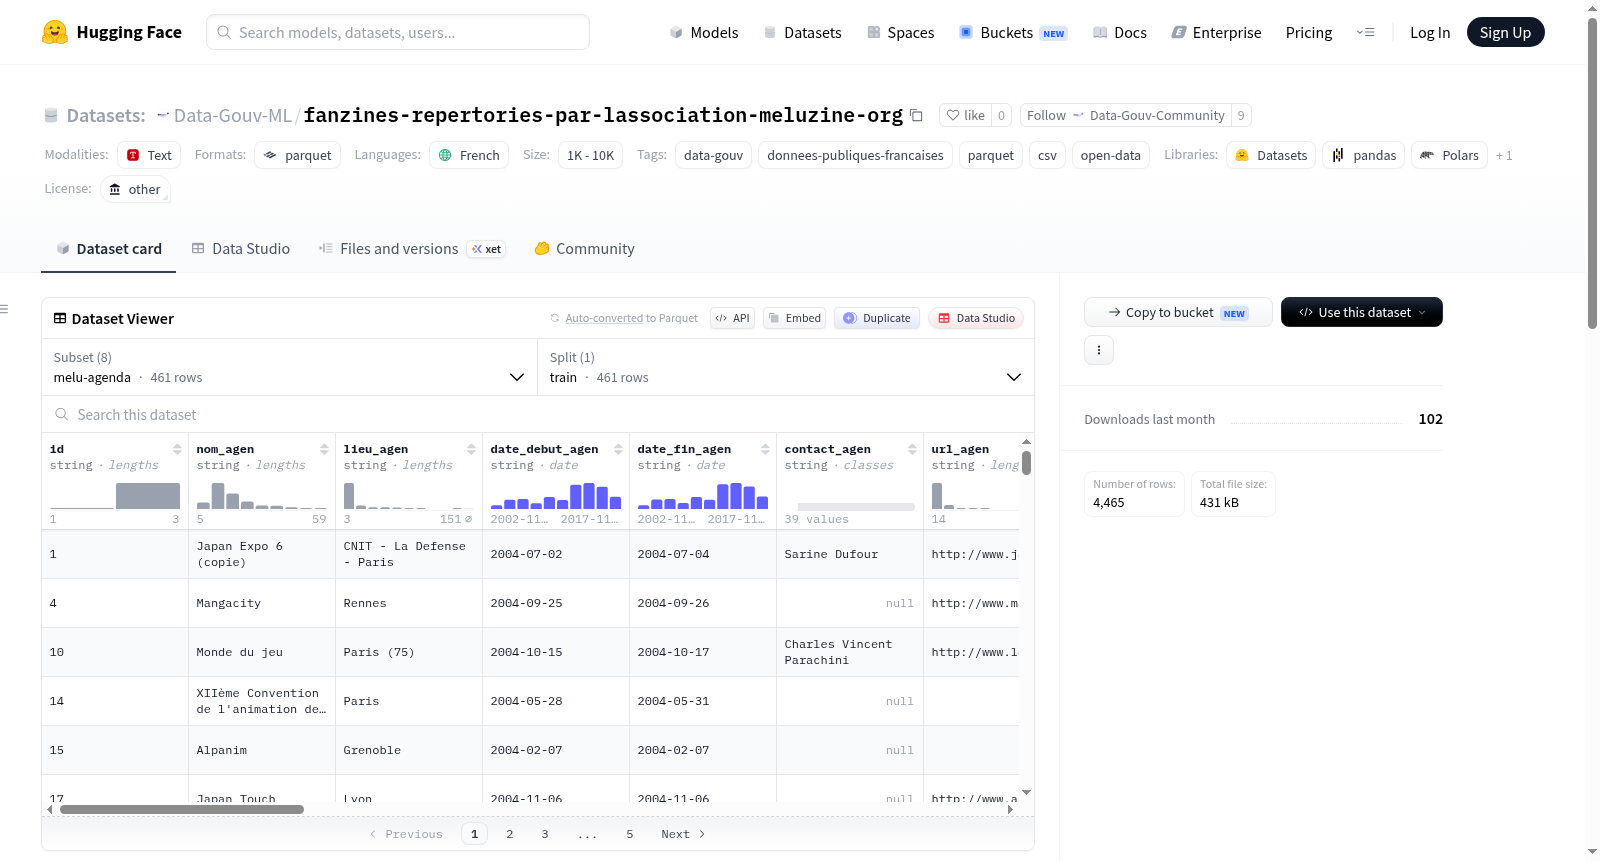
该数据集源于法国Meluzine.org协会历时数十年对法语区同人志(fanzine)生产的系统梳理,原始数据以CSV格式提取自该协会的数据库。数据集在HuggingFace平台上被重构为多配置结构:每一份原始表格资源对应一个HuggingFace子集(configuration),所有子集均统一包含名为'train'的分割。数据集基于法国公共数据门户data.gouv.fr的开放数据资源构建,采用CC-BY许可协议,确保了来源的权威性与使用的开放性。
特点
数据集的一个显著特征是其多维度、高颗粒度的结构化设计。它并非单一表格,而是由八个相互关联的子集构成,分别涵盖同人志类别(melu-categories)、系列信息(seriefestival)、活动日程(melu-agenda)、合作伙伴(melu-partenaires)、期刊与类别关联(melunumeros-melucategories)、日期索引(melu-jour)、内容详情(melu-contenus)以及格式定义(melu-formats)。这种设计使研究者能够灵活地从不同视角切入,深入探究法语同人志的生产网络、传播脉络与社会参与。
使用方法
使用者可通过HuggingFace的`datasets`库便捷调用该数据集。调用时需指定具体子集名称,例如`load_dataset("Data-Gouv-ML/fanzines-repertories-par-lassociation-meluzine-org", "melu-categories")`,即可加载对应子集的训练数据。每个子集均以Parquet格式存储,兼顾了查询效率与存储紧凑性。建议使用者根据研究主题选择适配的子集,或结合多个子集进行跨表关联分析,从而全面还原法语同人志生态的丰富面貌。
背景与挑战
背景概述
该数据集由法国非营利组织Meluzine.org经过数十年的系统性收集与整理,于近年发布于法国政府开放数据平台data.gouv.fr,并由Data-Gouv-ML团队迁移至HuggingFace平台。其核心研究问题聚焦于法语圈同人志(fanzine)文化的数字化建档与结构化分析。作为法语独立出版文化研究的重要资源,该数据集系统收录了数十年间法语同人志的生产记录,涵盖杂志本身、系列沿革、创作者群体、内容摘录、相关奖项及活动等多元维度。其对文化研究、数字人文及小众出版史领域具有显著学术价值,为探索非主流印刷文化的传播模式与社群生态提供了难得的量化基础。
当前挑战
该数据集所解决的领域问题在于,同人志作为边缘性文化产物,其分散性、非正式性与短暂性导致传统文献学难以系统捕获。构建过程中的挑战尤为突出:首先,数据来源依赖人工长期追踪与手工录入,不同时期的信息格式与质量标准难以统一,导致跨表关联(如刊物与系列、创作者与活动)存在断裂与歧义。其次,原始数据库涵盖8个独立表格(如类别、节日、日程等),其关系型结构向平面化Parquet格式迁移时,需保留隐含的多对多关联,这对数据清洗与schema重建构成技术难题。此外,法语方言、笔名变体及历史包装差异的规范化处理,进一步加剧了数据整合的复杂度。
常用场景
经典使用场景
该数据集源自法国非营利组织Meluzine.org数十年间对法语圈同人志(fanzine)作品系统的整理与归档,承载着珍贵的地下文化与亚文化史料。经典使用场景聚焦于法语同人志的元数据整合与结构化分析,研究者可利用其多维度配置(如类别、节日序列、参与方、内容摘要等)构建关联数据库,用于探索同人志的出版脉络、创作者社群网络及主题演变轨迹。数据集以开放的Parquet与CSV格式提供,方便通过Hugging Face的Datasets库直接加载,为数字人文学者提供了高互操作性的研究起点。
实际应用
实际应用中,该数据集可服务于文化遗产机构的数字化策展与知识图谱构建。例如,图书馆与档案馆可将其作为元数据基准,整合散落于个人收藏的实体同人志,构建可检索的虚拟馆藏。同时,数据集的分类体系(如节日序列、合作伙伴表)能支撑展览策划与教育项目,通过时间线与地理分布的可视化呈现同人志运动的历史地理变迁。此外,出版行业分析者可利用其提取小众市场的创作规律,辅助预测文化趋势,甚至指导当代同人志的发行策略。
衍生相关工作
该数据集催生了若干跨学科衍生研究,典型工作包括:基于`melu-categories`与`seriefestival`配置的主题演化分析,利用自然语言处理技术对同人志标题和摘要进行时序列建模,揭示特定社会议题(如女权、生态)在亚文化中的涌现周期;围绕`melu-partenaires`构建的创作者协作网络,通过社会网络分析方法识别关键节点与传播路径;以及将`melu-contenus`与外部档案库(如法国国家图书馆的数字化馆藏)联动,实现同人志内容实体(如插画、诗歌)的跨域语义对齐。这些工作共同拓展了亚文化大数据的研究边界。
以上内容由遇见数据集搜集并总结生成


