
遇见数据集

terminal_bench_2_a3_rl_laion_nemotron_gym_math_advanced_calculations_v3_60_8B_20261ba9adc8

收藏
Hugging Face2026-08-30 更新2026-08-31 收录
官方服务:

资源简介:

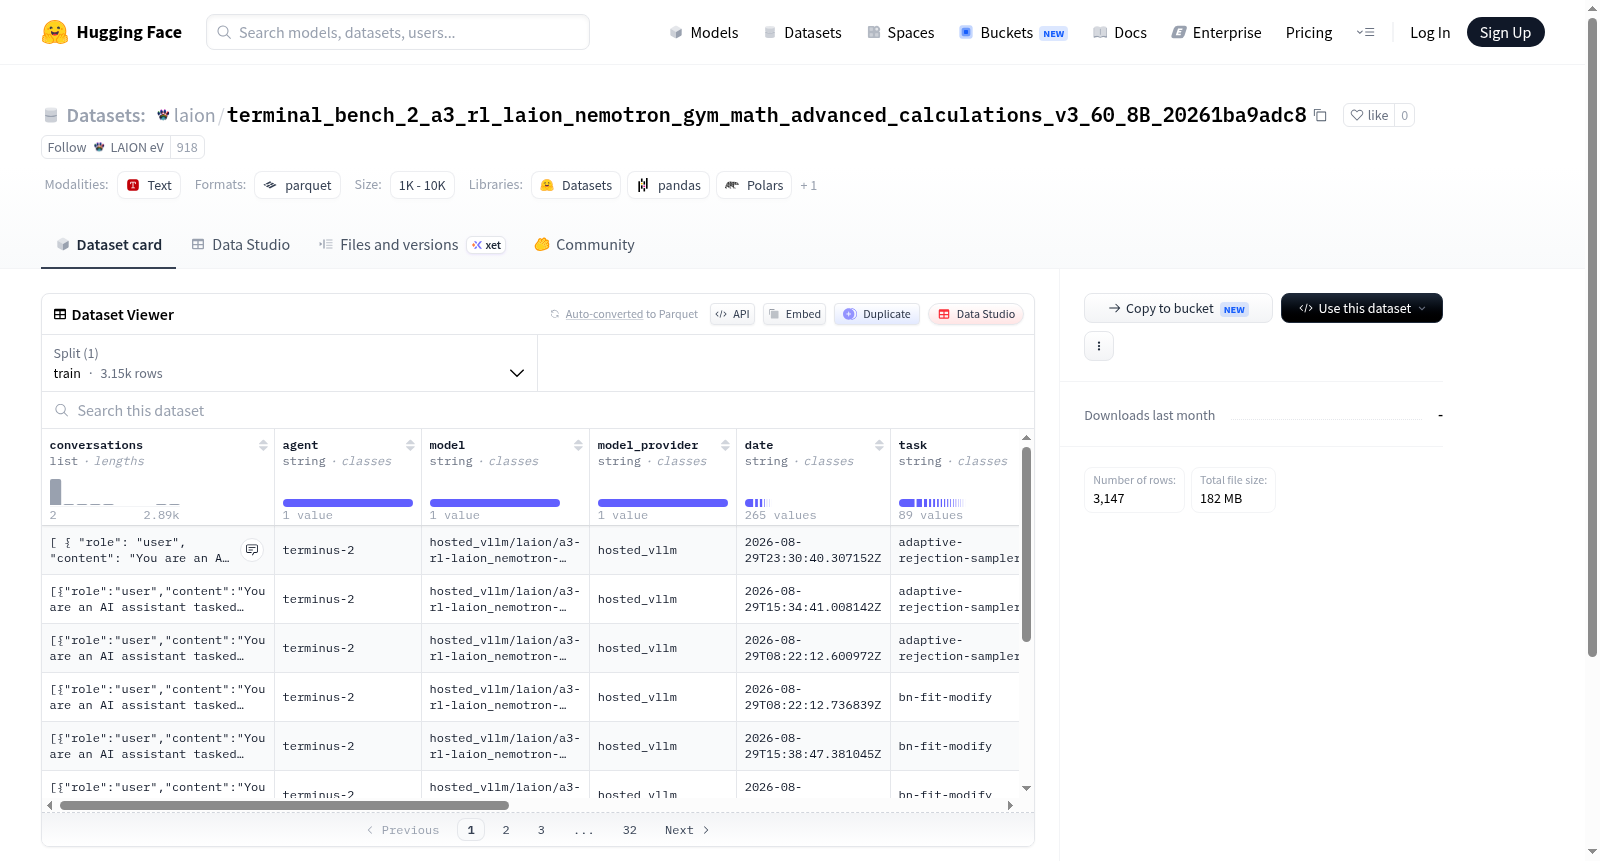
该数据集包含AI agent与用户之间的对话交互记录,每条数据包括对话内容(conversations,由角色role和内容content组成)、agent名称、模型名称、模型提供商、日期、任务类型、轮次(episode)、运行ID、试验名称、结果、验证输出以及追踪来源。数据集共3147个训练样本,总大小约232MB。适用于对话系统评估、agent行为分析、模型输出质量研究、多轮对话理解等任务。

This dataset contains conversation interaction records between AI agents and users. Each data entry includes conversation content (conversations, consisting of role and content), agent name, model name, model provider, date, task type, episode, run ID, experiment name, result, validation output, and trace source. The dataset has a total of 3147 training samples, with a total size of approximately 232MB. It is suitable for tasks such as dialogue system evaluation, agent behavior analysis, model output quality research, and multi-turn dialogue understanding.

提供机构:
LAION eV
创建时间:
2026-08-30
原始信息汇总

数据集概述

该数据集为 laion/terminal_bench_2_a3_rl_laion_nemotron_gym_math_advanced_calculations_v3_60_8B_20261ba9adc8,来源于 Hugging Face 数据集平台。

核心内容

这是一个包含 3,147 条训练样本 的对话数据集,主要用于强化学习或数学高级计算相关的智能体(Agent)训练与评估任务。数据集总大小约 222 MB(下载大小约 173 MB)。

数据字段

数据集每条样本包含以下字段:

字段名 类型 说明
conversations 列表 对话内容,包含 role(角色)和 content(内容)两个子字段
agent 字符串 智能体标识
model 字符串 使用的模型名称
model_provider 字符串 模型提供方
date 字符串 日期信息
task 字符串 任务类型
episode 字符串 回合编号
run_id 字符串 运行标识
trial_name 字符串 试验名称
result 字符串 结果输出
verifier_output 字符串 验证器输出
trace_source 字符串 追踪来源

数据划分

  • 唯一划分train 训练集,包含 3,147 条样本,数据格式为 data/train-*

适用方向

该数据集适用于强化学习、数学高级计算任务、智能体训练与评估、对话生成等领域的研究与开发。
搜集汇总
数据集介绍
terminal_bench_2_a3_rl_laion_nemotron_gym_math_advanced_calculations_v3_60_8B_20261ba9adc8 数据集图片
构建方式
该数据集名为terminal_bench_2_a3_rl_laion_nemotron_gym_math_advanced_calculations_v3_60_8B_20261ba9adc8,源自对高级微积分问题求解过程的强化学习轨迹捕捉。其构建依托于gym数学环境,采用NVIDIA Nemotron 8B模型,结合LAION数据源进行迭代训练,收集了3147条多轮对话序列。每条样本不仅包含模型与环境的交互记录,还附加了任务描述、运行标识符、结果验核输出等元数据,系统性地沉淀了模型在探索数学解题策略时的完整路径与决策逻辑。
特点
数据集的核心特色在于其高度的结构化与丰富的上下文信息。每条数据记录了完整的会话历史,涵盖角色切换与内容演化,并附有agent类型、模型名称、日期等可追溯属性。尤为突出的是,数据集中整合了验证器输出(verifier_output)与结果字段,便于研究者评估动作的有效性及最终解答的正确性。此外,通过episode、run_id和trial_name等字段,数据支持对多次尝试的对比分析,为深入理解强化学习中的探索-利用平衡提供了宝贵素材。
使用方法
使用该数据集时,研究者可将其作为微调语言模型或训练数学推理智能体的监督数据。因为每条样本包含带标注的对话序列,可直接用于序列到序列模型的训练,或作为RL环境中的经验回放缓存。借助辅助字段(如task和episode),可轻松筛选出特定问题类型或某一学习阶段的轨迹,用于针对性评估。此外,通过解析verifier_output,可构建奖励模型或进行结果分析,进而优化策略网络在数学推理任务上的表现。
背景与挑战
背景概述
在人工智能领域,强化学习与大型语言模型的融合正推动着智能体在复杂任务处理上的能力跃迁。本数据集名为terminal_bench_2_a3_rl_laion_nemotron_gym_math_advanced_calculations_v3_60_8B,由LAION等研究机构于2024年构建,核心研究问题聚焦于利用强化学习范式训练8B参数量的语言模型,以解决高级数学计算问题。该数据集包含3147条实例,涵盖对话记录、任务描述及验证器输出,为评估模型在数学推理与工具调用方面的能力提供了基准。其影响力在于促进开源社区对强化学习与语言模型结合的研究,尤其为数学密集型领域的智能体训练提供了宝贵资源。
当前挑战
该数据集面临的挑战多维且深刻。领域层面,高级数学计算问题要求模型不仅具备精准的算术能力,还需理解复杂数学符号与逻辑推导,这对于小型8B模型而言是一项艰巨任务,易产生数值误差或推理缺陷。构建过程中,数据采集需整合多样化的数学问题与对话轨迹,确保覆盖广泛题型与难度梯度,同时保证标注一致性与质量;此外,强化学习环境的交互数据需协调模型与外部验证器的反馈,处理延迟与噪声,以维持训练稳定性,这些均构成技术上的严峻考验。
常用场景
经典使用场景
在人工智能与数学推理交叉领域,该数据集聚焦于高级数学计算任务的智能体行为轨迹学习。其核心使用场景在于训练和评估基于强化学习的语言模型智能体,使其能够通过交互式终端环境执行复杂数学推导与精确计算。数据集包含了完整的会话记录、智能体身份、模型来源及任务元数据,为研究者提供了丰富的监督信号,用以优化模型分步骤解题的推理策略,并验证其在长链条逻辑推理中的鲁棒性。
衍生相关工作
该数据集催生了多项衍生工作,如构建针对数学推理的强化学习奖励模型,利用其轨迹数据训练过程监督的验证器,进一步精炼步骤级反馈。研究者亦基于此数据集开发了多智能体协作框架,促使模型间通过互相校验提升最终答案的精确度。此外,数据集中agent与model字段的对照分析为跨模型知识迁移研究提供了素材,推动了关于模型泛化能力与领域自适应技术的深入探讨。
数据集最近研究
最新研究方向
该数据集聚焦于强化学习驱动的智能体在复杂数学推理任务中的表现,其名称中的“terminal_bench”暗示了终端基准测试场景,而“advanced_calculations”则明确了高阶运算的挑战性。结合其源自Laion与NVIDIA Nemotron的混合数据,以及包含多轮对话、智能体行为追踪和验证器输出等丰富特征,此数据集堪称当前大语言模型智能体研究的前沿枢纽,尤其在自主求解数学问题与工具调用能力的评估上具有里程碑意义。其构建逻辑呼应了近期热点——利用环境反馈与自我博弈提升模型推理效能,同时为可解释性验证和课程学习提供了高质量的语料基石。这一资源对于推动面向科学计算与工程优化的认知智能体落地,以及培育具备演算精确性和策略适应性的下一代AI系统,均具有不可小觑的学术价值与产业转化潜力。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

