
遇见数据集

sungkwang2/khalani-en-kha-translation

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

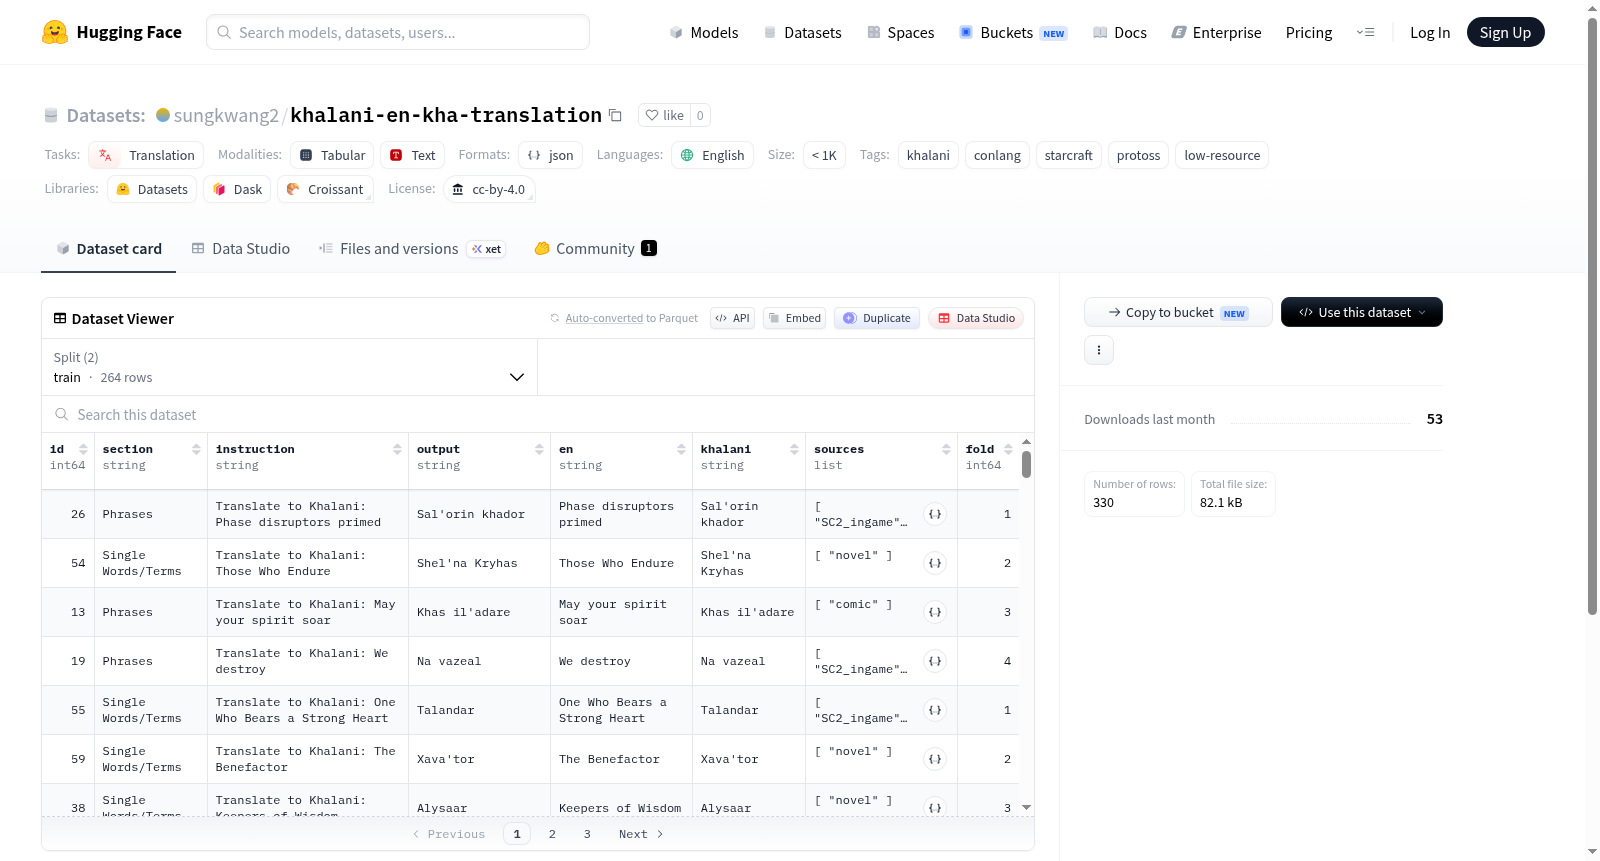
Khalani与英语翻译数据集,专注于Khalani(《星际争霸》中神族构造语言)与英语之间的双向翻译。数据集包含55个翻译对,采用5折交叉验证(例如fold0:44个训练样本和11个测试样本)。文件格式为JSONL,其中`*.jsonl`表示英语到Khalani的翻译,`*_kha2en.jsonl`表示Khalani到英语的翻译。每个JSONL行包含以下字段:指令(instruction)、输出(output)、英语文本(en)和Khalani文本(khalani)。需要注意的是,由于数据集规模较小(仅55对),全微调可能导致过拟合(即模型记忆训练数据而无法泛化到未见数据)。该数据集旨在用于探索性研究,特别是关于自回归与扩散模型在构造语言处理中的比较,不建议用于得出一般性结论。相关模型可在huggingface.co/sungkwang2找到。

Khalani to English translation dataset, focusing on bidirectional translation between Khalani (a constructed language for the Protoss race in StarCraft) and English. The dataset consists of 55 translated pairs, using 5-fold cross-validation (e.g., fold0: 44 training samples and 11 test samples). The file format is JSONL, where `*.jsonl` represents English to Khalani translation, and `*_kha2en.jsonl` represents Khalani to English translation. Each JSONL line contains the following fields: instruction, output, English text (en), and Khalani text (khalani). Note that due to the small dataset size (only 55 pairs), full fine-tuning may lead to overfitting (i.e., the model memorizes training data and fails on held-out data). This dataset is intended for exploratory research, particularly in the context of comparing autoregressive versus diffusion models for constructed language processing, and is not suitable for drawing general conclusions. Related models can be found at huggingface.co/sungkwang2.
提供机构:
sungkwang2
搜集汇总
数据集介绍
sungkwang2/khalani-en-kha-translation 数据集图片
构建方式
该数据集以《星际争霸》中神族所使用的人造语言“卡莱尼语”(Khalani)为核心,精心收集了55对英-卡双语翻译对,构成一个小型但高度专业化的平行语料库。数据以JSONL格式组织,其中文件默认方向为英语至卡莱尼语,而带有“_kha2en”后缀的文件则提供反向翻译。每条数据包含指令、输出、英语原文及卡莱尼语文本四个字段,便于多角度使用。为评估模型泛化能力,数据集采用5折交叉验证,每折划分44条训练样本与11条测试样本,确保在极低资源场景下进行稳健的探索性实验。
使用方法
使用该数据集时,研究者可直接加载JSONL格式的翻译对,并依据文件名选择翻译方向。建议采用少量样本学习或参数高效微调方法(如LoRA),避免全参数微调带来的过拟合风险。由于数据量极小,适合作为快速原型验证或方法论对比的测试床,例如比较自回归模型与扩散模型对稀缺语料的记忆与泛化能力。推荐结合原始模型进行实验,相关预训练模型可在HuggingFace上以“sungkwang2”为标识获取,以复现作者的研究路径。
背景与挑战
背景概述
Khalani-En-Kha翻译数据集诞生于对虚构语言(conlang)这一跨学科领域的探索,其构建由研究者Sungkwang等主导,时间可追溯至StarCraft系列游戏中Protoss种族所使用的Khalani语言体系。该数据集的核心研究问题聚焦于极低资源情境下的神经机器翻译能力,尤其是对非自然语言符号系统的语义映射与生成建模。作为仅包含55对平行句对的微型资源,它在人工智能语言学界开辟了罕见的实验场域,服务于对比自回归(AR)与扩散模型在虚构语言翻译任务上的表现差异。尽管规模极小,但其独特定位为跨语言泛化机制的研究提供了新颖的测试基准,尤其推动了低资源翻译技术向非真实语言体系的延伸思考。
当前挑战
该数据集面临的首要挑战源于其极端稀缺的样本量——仅55个翻译对导致完整微调极易过拟合,表现为模型机械记忆训练集却无法泛化至未见样本,直接暴露出传统神经翻译架构在超低资源场景下的结构性缺陷。构建过程中,研究团队需在语言学准确性(如Khalani语法规则继承自游戏官方设定)与实验可控性之间寻求平衡,同时控制5折交叉验证中fold0(44训练/11测试)的划分方差对结论的影响。更广义的挑战在于,虚构语言的语法未完整性、文化语境的缺失以及非自然语义的随机性,使得任一翻译推测均难以被客观评估,这要求设计者警惕将探索性结果误判为性能断言的可能。
常用场景
经典使用场景
在这个充满神秘色彩的虚构语言研究领域,Khalani语作为《星际争霸》中Protoss种族的精心构造语言,为计算语言学家提供了一个独特而迷人的实验场。该数据集经典使用场景聚焦于低资源机器翻译任务,研究者利用其仅有的55对平行语料,通过5折交叉验证划分训练集与测试集,探索在极端数据稀缺条件下神经翻译模型的极限表现。这一场景尤其适合验证小样本学习、元学习以及预训练模型迁移能力在人工语言上的适应性,成为连接虚构语言学与自然语言处理前沿技术的重要桥梁。
解决学术问题
该数据集直面低资源神经机器翻译领域最棘手的核心挑战:在训练样本极度匮乏时模型如何避免过拟合而保持泛化能力。它精准揭示了传统全参数微调策略在此情境下的失败特性——模型倾向记忆有限训练样本却无法应对未见语料,从而为研究正则化技术、提示学习、扩散模型与自回归模型差异比较等学术议题提供了可量化的基准。通过对这一人工语言的探索,研究者得以剥离自然语言先天性噪声干扰,专门评估模型架构对孤立且规则性强的语义映射的捕捉效率,推动了翻译模型在处理极端低资源语言时鲁棒性与灵活性的理论突破。
实际应用
在现实世界的应用图谱中,这一数据集的核心价值在于为游戏本地化与虚拟世界跨语言通信系统提供技术原型。由于Khalani语具备人工语言的规则性与封闭性,其翻译实验可直接指导游戏公司开发自动化对话生成工具,实现Protoss角色实时双语字幕的精准映射。此外,针对科幻影视、文学作品中的虚构语言翻译需求,如《阿凡达》的纳美语或《权力的游戏》的多斯拉克语,该数据集验证的少样本翻译策略可被快速迁移,帮助创作者与粉丝社群高效构建跨语言理解桥梁,显著降低人工考据成本,焕发虚构语言在数字娱乐产业中的实用生命力。
数据集最近研究
最新研究方向
在低资源语言机器翻译与构造语(conlang)探索的交叉前沿,Khalani-英语翻译数据集以《星际争霸》中Protoss族的虚构语言为对象,仅含55条平行语对,成为研究极端低资源场景下神经机器翻译极限的微型基准。当前热点聚焦于自回归模型与扩散模型在构造语任务上的表现差异:该小样本集天然防止全参数微调(易过拟合),迫使研究者转向元学习、提示工程或对比解码等轻量化策略。其意义在于,不仅为游戏语言学与人工语言计算建模开辟实证路径,更通过‘虚构语言’这一可控复杂度媒介,揭示了真实濒危语言翻译中数据匮乏的共性困境,推动少样本翻译范式从模拟数据向人创复杂语言系统的能力迁移。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

