
mm-eval/SciFIBench
收藏官方服务:
资源简介:
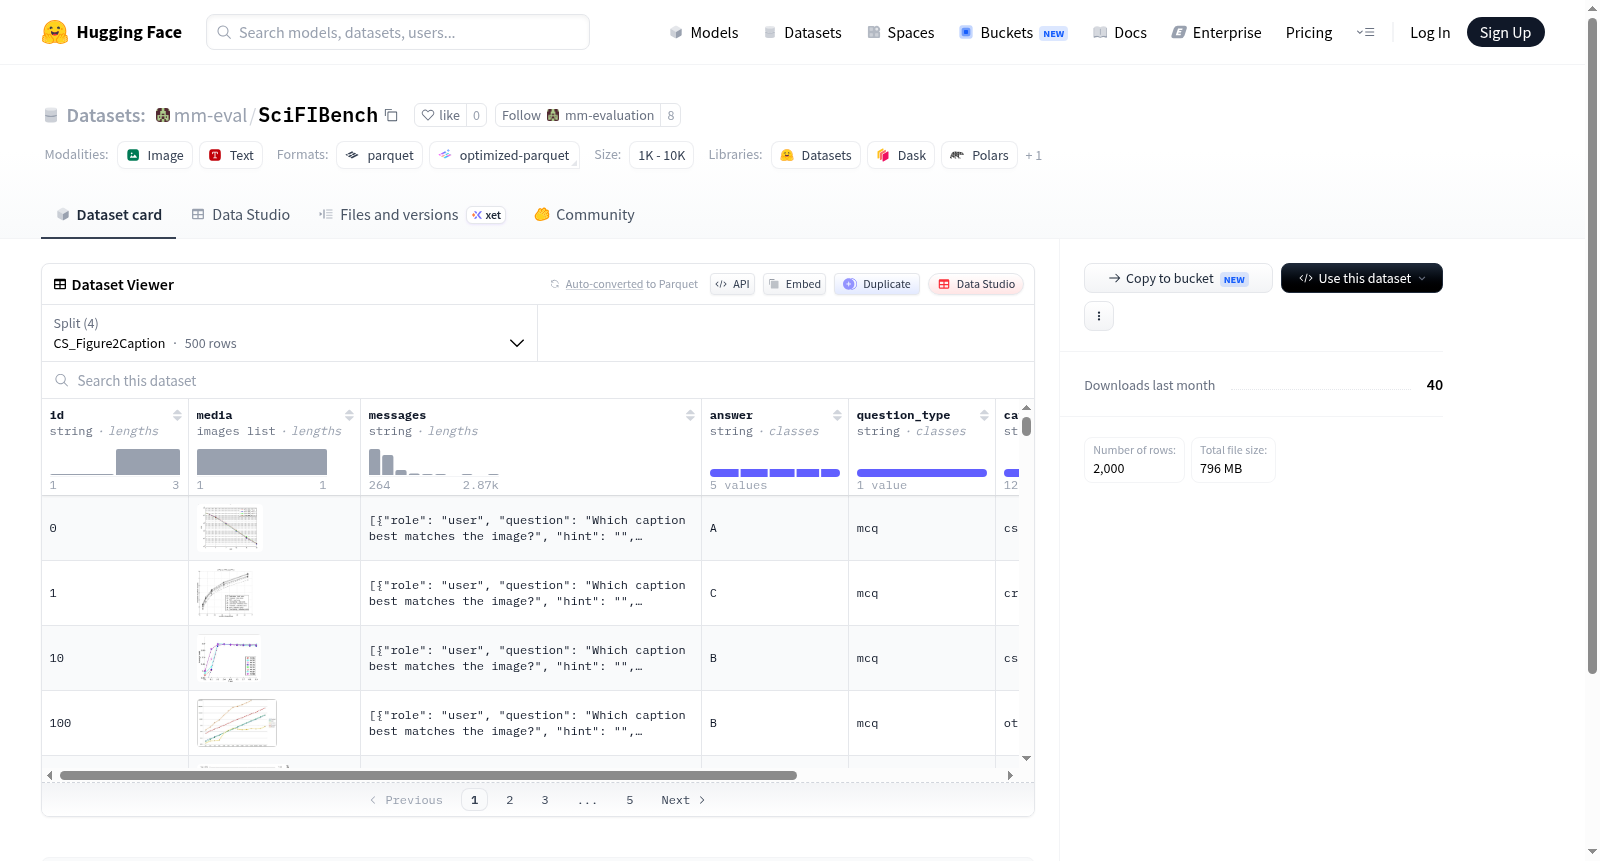
该数据集包含四个子集,分别对应计算机科学领域和通用领域的图像到文本描述(Figure2Caption)以及文本描述到图像(Caption2Figure)任务。每个子集有500个样本,每个样本包含一个唯一标识符、图像列表和消息字符串。
This dataset contains four subsets corresponding to figure-to-caption and caption-to-figure tasks in computer science and general domains. Each subset has 500 samples, each sample includes a unique identifier, a list of images, and a message string.
提供机构:
mm-eval搜集汇总
数据集介绍
构建方式
SciFIBench数据集旨在评估多模态大模型在科学图表理解与生成方面的能力。其构建过程遵循严谨的双向任务设计,涵盖'图表到描述'(Figure2Caption)与'描述到图表'(Caption2Figure)两种互补范式。数据源被划分为计算机科学(CS)与通用科学(General)两大领域,每个领域分别生成500个样本,共计2000个高质量实例。每个样本包含唯一的标识符(id)、关联的图片(media)、结构化的消息序列(messages)、标准答案(answer)、问题类型(question_type)及所属类别(category),确保了数据集的系统性与可扩展性。
特点
该数据集的核心特色在于其双向推理评估维度,不仅要求模型从科学图表中提取语义信息并生成准确描述,还要求模型依据给定的文字描述逆向重构对应的图表内容。这种设计能够全面检验模型在视觉-语言跨模态理解中的综合能力。此外,通过区分计算机科学图表与普遍科学图表,数据集覆盖了从专业领域到通识领域的多样化图表类型,为评估模型的泛化性能提供了丰富场景。每个样本均经人工校验,保证了标注质量与任务难度的一致性。
使用方法
使用时,用户可通过HuggingFace Datasets库加载该数据集,支持按默认配置获取全部四个分片(CS_Figure2Caption、General_Figure2Caption、CS_Caption2Figure、General_Caption2Figure)。在每个样本中,'messages'字段包含模型输入所需的对话轮次信息,而'answer'字段提供标准参考输出,便于计算模型预测与真实结果之间的差异。建议研究人员将数据划分为训练与测试集,利用'question_type'字段针对不同任务微调多模态模型,并采用CLIPScore、BLEU等指标评估图表到描述的生成质量。
背景与挑战
背景概述
SciFIBench是一个专注于科学图表理解与生成的数据集,诞生于多模态大模型与科学文献智能化处理交叉领域。该数据集由专业研究团队构建,旨在解决科学图表与文本间复杂映射关系的基础性问题。核心研究聚焦于两大方向:从图表到文字描述的生成(Figure2Caption)以及从文字描述重构图表(Caption2Figure),分别涵盖计算机科学(CS)与通用科学(General)领域。其设计兼顾领域特定性与跨学科普适性,为评估多模态模型在科学推理、视觉语义对齐等能力上提供了标准化基准。自发布以来,SciFIBench已成为检验前沿多模态模型在科学可视化理解方面表现的重要测试平台,对推动学术知识自动化提取与科学图表交互技术发展具有显著影响力。
当前挑战
SciFIBench所应对的领域挑战在于科学图表理解的源生复杂性,包括图表中隐含的多层次语义关系、专业符号与术语的准确识别以及跨模态信息的一致性推理。构建过程面临的核心困难涉及数据采集的广度与精度:既需涵盖计算机科学等专业领域的高密度信息图表,也需兼容通用科学场景中风格迥异的可视化表达。此外,构建任务(如Caption2Figure)要求模型具备生成精确排版、坐标轴标注与数据分布态势的能力,这对现有生成式多模态网络的细粒度控制提出严峻考验。数据标注质量保障、跨领域知识迁移有效性以及评估指标对科学严谨性的敏感度,亦是本数据集建设过程中不断攻坚的关键瓶颈。
常用场景
经典使用场景
SciFIBench是一个专注于科学图表理解的基准数据集,广泛应用于评估多模态大模型在科学领域图表与文字描述之间的双向推理能力。该数据集巧妙地将任务拆解为“图像到标题”与“标题到图像”两种经典范式,借助计算机科学(CS)和通用科学(General)两大子集,覆盖了学术论文中常见的折线图、柱状图、散点图等多样化科学可视化形式。研究者可借助SciFIBench检验模型是否具备从复杂图表中精准提取语义信息、识别趋势特征,并生成连贯科学描述的能力,其双视角设计尤为适合用于衡量跨模态对齐与科学知识迁移的性能表现。
解决学术问题
SciFIBench的提出直击当前多模态模型在科学文献理解领域缺乏标准化评估基准的痛点。传统视觉问答数据集往往聚焦日常场景,忽视了科学图表中严谨的逻辑结构和专业术语。该数据集通过严谨的图文双向验证机制,系统性地评估模型对科学图表内涵与外延的理解程度,解决了“模型能否像人类研究者一样从图中抽象出核心科学观点”这一关键问题。其细粒度的任务设计为诊断模型在视觉感知、语言生成与科学推理衔接上的薄弱环节提供了可靠依据,推动了科学人工智能领域的评测范式从“视觉匹配”向“科学理解”的深刻转变。
衍生相关工作
SciFIBench的发布催生了一系列关于科学图表与文本双向交互的经典研究工作。后续研究者围绕该数据集提出了多种优化策略,例如引入领域知识增强的视觉编码器以改进图表中数值趋势的感知精度,以及设计基于思维链的两阶段推理框架来提升标题生成的质量。部分工作致力于探索数据集的深层潜力,通过构建对抗性样本检验模型对科学图表中误导性视觉元素的鲁棒性,推动了科学多模态领域安全性研究的萌芽。此外,SciFIBench还作为关键评估基准,被用于验证图文对比学习、模态对齐蒸馏等前沿技术方法在科学文献理解上的真实效果。
以上内容由遇见数据集搜集并总结生成


