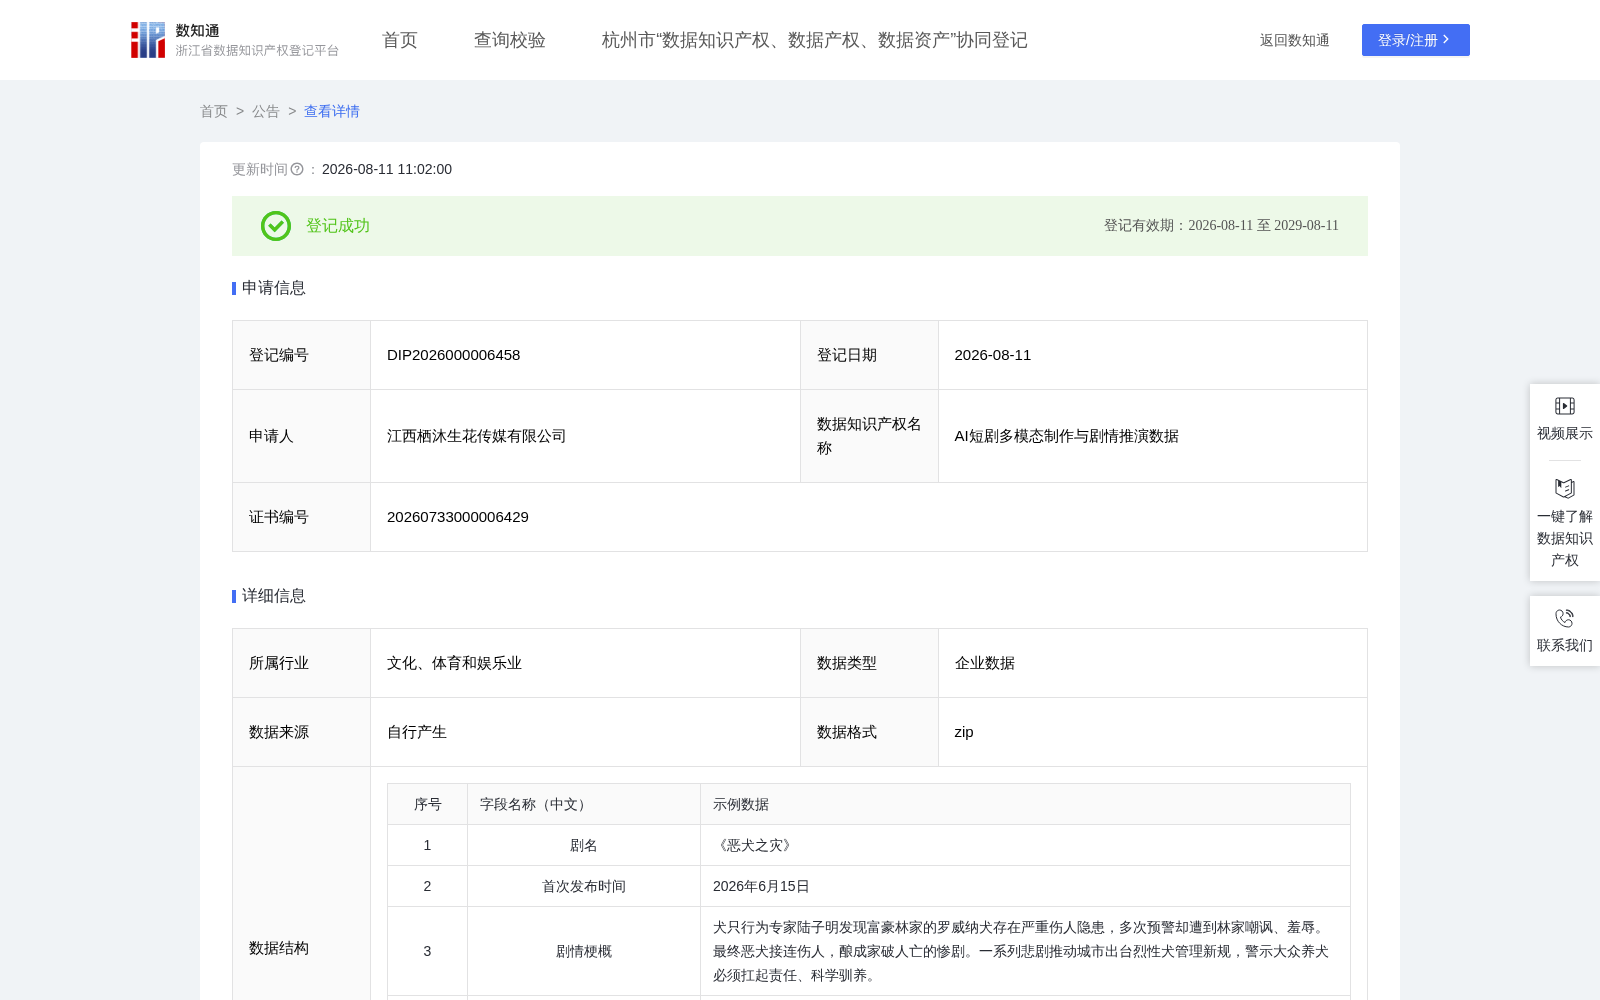
AI短剧多模态制作与剧情推演数据
收藏资源简介:
本数据集主要应用于AI短剧(以《恶犬之灾》为例,44集共51分钟)从剧本到成片的工业化制作流程,覆盖编剧、AI生成师、剪辑师、运营人员等多角色协同作业。在剧本阶段,通过NER算法自动提取每集的主要人物、核心标签、地理场景及情绪标签,将44集文本快速拆解为标准化场景结构化数据(含场景编号、出场人物及核心动机、人物弧光变化、关键事件链、核心台词、戏剧节拍等23个字段),辅助编剧快速识别每集叙事节奏是否合理、冲突铺垫是否充分;在生成阶段,将各场景的结构化字段作为完整输入指令集,驱动Seedance2.0模型严格按照场景编号顺序逐场景生成对应时长的视频素材,并通过前置锚点(人物设定图、场景设定图等)锁定人物、犬只及场景在44集中的视觉连贯性,有效解决多集批量生成中常见的形象飘移与风格不一致问题;在剪辑发布阶段,依据各场景情绪曲线数值,人工完成竖屏智能构图、情绪峰值音效匹配及动态字幕生成,提升抖音、红果等平台分发效率。本数据集合建立了“集级语义解析→场景级字段提取→多模态顺序生成→平台适配”的完整技术链路,可推广应用于同类都市现实题材的系列化AI短剧制作,为短剧的高用于平台用户的观看。(一)集级剧本语义解析、场景拆解与人工导演核心创作能力 导演根据创作意图对剧本进行结构化阅读与分镜级拆分,明确各场景的叙事功能与视觉表达要求,例如:输入《恶犬之灾》某一集剧本(含梗概及对话),通过NER(命名实体识别)算法提取“主要人物”(陆子明、林建业、林小宇、周雅)、“核心标签”(都市、宠物)、“地理场景”(林家别墅后院草坪、大门前等)、“情绪标签”(紧张、愤怒、冤屈、悬置)四类核心元数据。基于“都市家庭”基准背景,将每集文本按叙事功能自动拆解为“开场引入、中段冲突、结尾转折”三段式结构。 (二)场景级结构化数据提取、参数封装与场景校验规则 针对每集拆解后的分场景内容(以第一集为例:场景1-1“林家别墅后院草坪/日/外”、场景1-2“林家别墅大门前/日/外/闪回”、场景1-3“林家别墅后院草坪/日/外”),逐场景提取并封装以下23个结构化字段,构成该场景的完整AI生成参数包,将结构化字段共同构成该场景从视觉呈现、角色表演、镜头语言到音画氛围的完整生成指令集,实从文字剧本到分镜级参数的精确转化。转化后的场景设计、场景切换、镜头节奏及视觉风格均由人工导演确定,对人物形象、场景连续性、镜头效果及内容合规性进行确认,不符合要求的内容重新生成或人工调整。 (三)多模态生成、场景工作流执行与人工导演审核 将全量场景级结构化数据作为生成工作流的逐项执行指令集,输入“Seedance2.0”模型。每个场景的23个结构化字段共同构成该场景的唯一生成参数包。模型依据各场景的预估播出时长确定每段视频的帧数总量,并严格按照场景编号顺序依次执行生成:前一场景生成完成后,以其结尾画面作为下一场景的视觉衔接锚点(如场景1-2以“闪回”方式承接场景1-1;场景1-3以“闪回结束”回归场景1-1时间线),确保场景切换时的叙事连贯性。逐场景顺序执行,完成整集的视频素材生成。最终依据各场景情绪曲线数值,在每集结尾锁定最高悬念节点,强制生成下集预告的视觉衔接帧,串联44集之间的叙事连续性。整体剧集内容采用Seedance 2.0多模态视频生成模型,在人工导演全流程控制下运行,通过结构化提示词输入、关键帧约束、候选结果筛选及人工后期编辑等多级机制,实现AI生成与人工创作的协同生产模式。模型仅承担内容生成执行功能,不具备独立创作与价值判断能力,所有内容均需经过人工审核与编辑后方可发布。