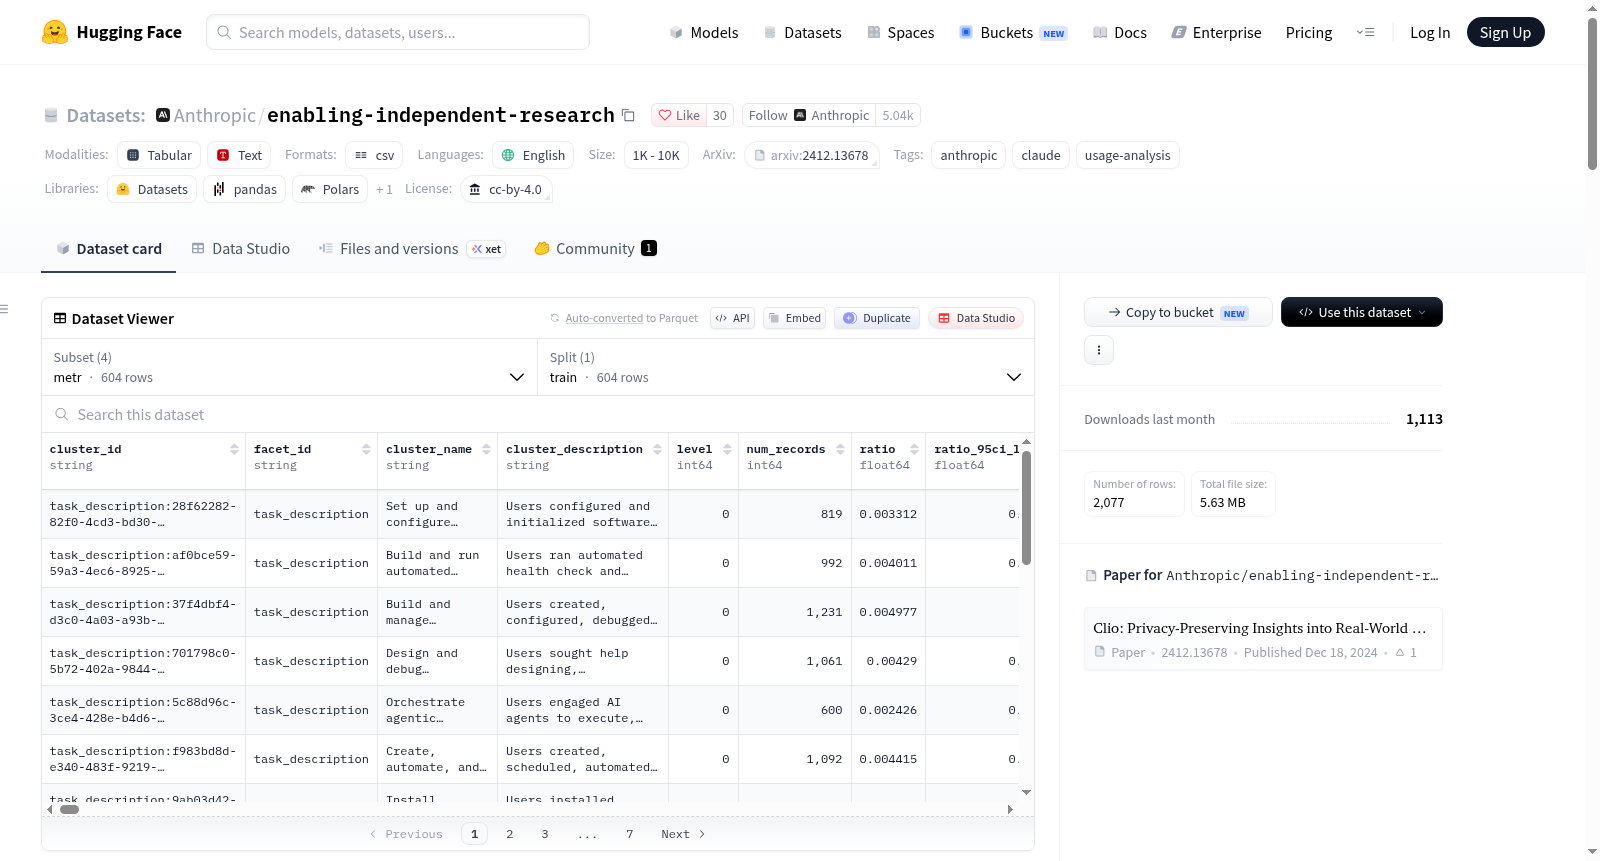
enabling-independent-research
收藏资源简介:
该数据集是 Anthropic Insights 试点项目的一部分,旨在支持独立研究机构分析用户如何与 Claude 交互。数据集包含四个子集,分别对应斯坦福大学、牛津大学和 METR 的研究:斯坦福大学研究人类与 AI 的协作方式;牛津大学研究用户使用 Claude 的体验及其与 Claude 行为的关系;METR 研究编码代理的实际生产力提升及其随模型代际的变化。每个子集大约包含 2026 年 4 月至 5 月期间采集的 250,000 条 Claude.ai 或 Claude Code 对话的聚合聚类数据。数据不包含原始对话,仅包含隐私保护的聚类信息(如聚类名称、描述、记录数、组织数、比例等),以及跨刻面交叉表列。数据集结构为 CSV 文件,每行代表一个聚类,包含基本列(cluster_id, facet_id, cluster_name, cluster_description, level, num_records, num_orgs, ratio, ratio_95ci_lower, ratio_95ci_upper, mean_val, sum_val)和跨刻面列。使用前需注意聚类名称和描述由 Claude 生成,不代表客观测量,且样本仅来自 Free、Pro 和 Max 用户,不包含 Team、Enterprise 或 API 客户数据。数据集遵循 CC BY 4.0 许可。
This dataset is part of the Anthropic Insights pilot project, aimed at supporting independent research institutions in analyzing how users interact with Claude. The dataset contains four subsets corresponding to studies from Stanford University, the University of Oxford, and METR: Stanford studies human-AI collaboration; Oxford studies user experience with Claude and its relationship to Claudes behavior; METR studies actual productivity gains from coding agents and how they vary across model generations. Each subset contains approximately 250,000 aggregated clusters of conversations from Claude.ai or Claude Code collected between April and May 2026. The data does not include raw conversations, only privacy-preserving cluster information (e.g., cluster name, description, number of records, number of organizations, ratio, etc.) and cross-facet cross-tabulation columns. The dataset is structured as CSV files, with each row representing a cluster, containing basic columns (cluster_id, facet_id, cluster_name, cluster_description, level, num_records, num_orgs, ratio, ratio_95ci_lower, ratio_95ci_upper, mean_val, sum_val) and cross-facet columns. Note that cluster names and descriptions are generated by Claude and do not represent objective measurements; the sample only includes Free, Pro, and Max users, excluding Team, Enterprise, or API customers. The dataset is licensed under CC BY 4.0.
数据集概述:Anthropic Insights Pilot: Partner Cluster Data
基本信息
- 数据集名称:Anthropic Insights Pilot: Partner Cluster Data
- 发布机构:Anthropic
- 语言:英语
- 许可证:CC BY 4.0
- 标签:anthropic、claude、usage-analysis
数据集背景
该数据集是Anthropic与三家外部研究机构合作项目的一部分,旨在支持独立研究用户如何使用Claude。项目详情可参考Anthropic的博客文章和相关论文。每项研究分析了2026年4月至5月期间约25万条Claude.ai或Claude Code对话,所有数据收集由Anthropic代为执行,各研究团队独立开展分析。
合作研究机构
- 斯坦福大学(Stanford University) :研究人类如何与AI协作,包括工作类型、人类承担的角色及协作失效场景。
- 牛津大学(University of Oxford) :研究用户使用Claude时的体验及其与Claude行为的关系。
- METR:非营利组织,评估前沿AI模型,研究编码代理的实际生产力增益及跨模型代际的变化。
数据内容与结构
数据集包含四个配置(config),每个配置对应一个CSV文件,分别是:斯坦福(stanford)、牛津(oxford)、METR(metr)及METR后续补充运行(metr_addendum)。其中metr_addendum基于新样本,采用了更严格的聚合最低阈值。
数据集中不包含原始对话,仅提供聚合后的、保护隐私的聚类数据。每一行代表一个聚类(cluster),即一组对研究者定义的问题(facet)回答方式相似的对话集合。
基础字段说明
cluster_id:聚类的唯一标识符facet_id:该聚类所属的研究者问题cluster_name:Claude生成的简短标签cluster_description:Claude生成的较长描述level:层级(0为最细粒度,级别1为更宽泛的父聚类)num_records:聚类中的对话数量num_orgs:聚类中涉及的不同组织数量ratio、ratio_95ci_lower、ratio_95ci_upper:聚类在样本中的占比及95%置信区间mean_val、sum_val:数值型facet的聚类级汇总统计量
此外,每个文件包含大量跨facet交叉列,将每个聚类与研究中的其他facet进行交叉制表,记录对应类别下的对话数量和比例。空白单元格表示该交叉未计算或低于隐私阈值。
隐私与审查
- 研究人员从未接触原始对话数据、用户标识符或组织标识符,全部原始数据和计算均在Anthropic服务器上完成。
- Anthropic工作人员在共享前对每个聚类名称和描述进行了人工审查,确保隐私、安全和研究质量。
- 发布前,外部第三方审计员尝试在该数据中重新识别用户,未能成功。
使用限制与注意事项
- 聚类名称和描述由Claude生成,应视作对底层对话的解读而非客观度量,不宜视为已验证结论或精确行为频率。
- 对话样本仅来自Free、Pro和Max用户,不包含Team、Enterprise或API客户数据,不代表Anthropic全部用户群体。
- Claude Code对话样本来自同意Anthropic使用其数据改进模型的消费者用户。
- 每项研究为固定时间窗口(2026年4-5月)的一次性快照。
- 牛津大学输出中有一个facet因疑似提示词措辞问题导致误导性聚类描述而被完全移除。
- Anthropic Insights无法区分被安全机制阻止的尝试与成功的尝试,描述有害请求的聚类反映的是用户请求内容,而非Claude实际提供的内容。
联系方式
查询可发送邮件至kunal@anthropic.com,研究者可通过此表单表达对未来Societal Impacts外部研究者合作的兴趣。