
遇见数据集

OpenVoiceOS/tts-test-sentence

收藏
Hugging Face2026-06-09 更新2026-06-14 收录
官方服务:

资源简介:

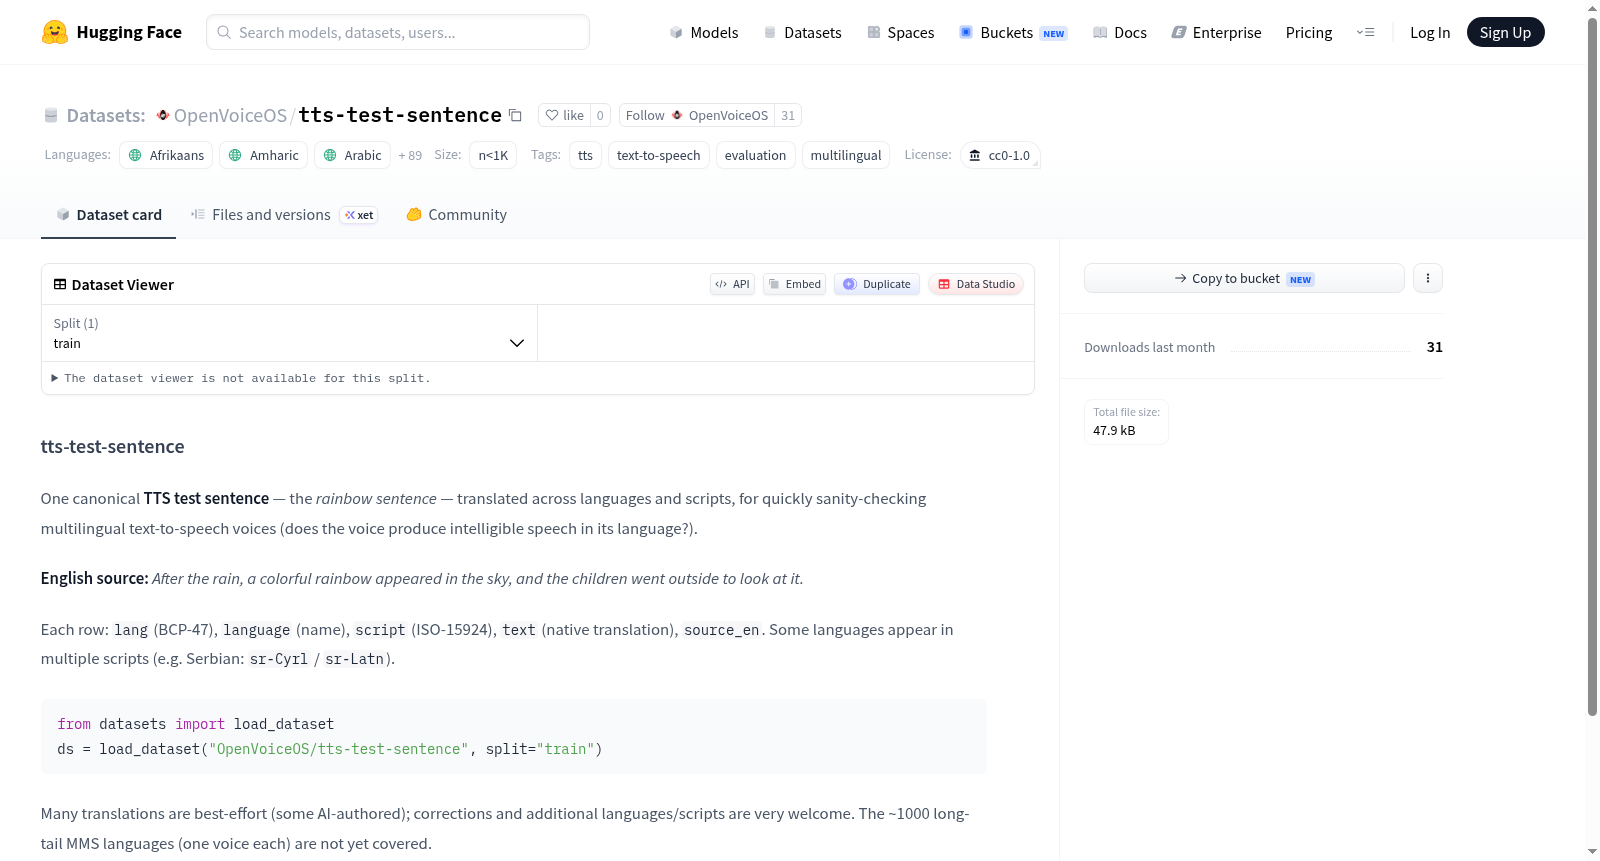
tts-test-sentence数据集是一个用于多语言文本到语音(TTS)测试的资源,包含一个标准测试句子(称为彩虹句子)的跨语言翻译。该句子在英文中为:After the rain, a colorful rainbow appeared in the sky, and the children went outside to look at it.,已被翻译成多种语言和脚本(支持超过100种语言,如af、am、ar、az等,包括中文)。数据集每行提供语言代码(BCP-47)、语言名称、脚本(ISO-15924)、本地翻译文本和英文源句子。它旨在帮助开发者和研究人员快速检查多语言TTS语音是否能在各自语言中产生可理解的语音输出。数据集覆盖多种语言变体(例如塞尔维亚语有西里尔和拉丁脚本),但翻译可能基于AI生成或最佳努力,欢迎更正和扩展。目前尚未覆盖约1000种长尾MMS语言。

The tts-test-sentence dataset is a resource for multilingual text-to-speech (TTS) testing, containing translations of a canonical test sentence (known as the rainbow sentence) across languages and scripts. The English source sentence is: After the rain, a colorful rainbow appeared in the sky, and the children went outside to look at it. It has been translated into numerous languages (over 100 languages including af, am, ar, az, and zh). Each row in the dataset includes lang (BCP-47), language (name), script (ISO-15924), text (native translation), and source_en. It is designed to quickly sanity-check multilingual TTS voices to ensure they produce intelligible speech in their respective languages. The dataset covers multiple language variants (e.g., Serbian in Cyrillic and Latin scripts), but translations are best-effort and may be AI-authored; corrections and additional languages/scripts are welcomed. It does not yet cover approximately 1000 long-tail MMS languages.
提供机构:
OpenVoiceOS
搜集汇总
数据集介绍
OpenVoiceOS/tts-test-sentence 数据集图片
构建方式
该数据集以英语彩虹句“雨后,天空中出现了五彩斑斓的彩虹,孩子们跑到户外仰望它”为源文本,通过多语言翻译和跨文字转写构建而成。每个数据条目均包含BCP-47语言代码、语言名称、ISO-15924文字标识、本地译文及英文源句,部分语言以多种文字形式呈现(如塞尔维亚语同时涵盖西里尔和拉丁文字)。数据集目前覆盖近百种语言与文字,翻译工作部分借助人工智能辅助完成,并欢迎社区贡献修正与新增。
特点
作为评测文本到语音(TTS)系统的基础句,这一数据集以单一经典测试句的多语言版本为核心,旨在快速验证合成语音在指定语言中的可懂度。其覆盖范围广泛,从非洲语言祖鲁语到东亚语言日语均有收录,并特别关注同一语言的不同文字变体。数据集规模精巧,不足千条,却集中反映了多语言TTS评估的关键需求,即跨语言一致性与文字适配能力。
使用方法
用户可通过HuggingFace datasets库直接加载数据集,调用load_dataset("OpenVoiceOS/tts-test-sentence", split="train")即可获取训练集。每条数据包含lang、language、script、text及source_en字段,便于按语言或文字筛选。研究者可将译文文本输入TTS模型生成语音,通过主观听测对比各语言版本的合成质量。该数据集尤其适合快速检验多语言模型的稳定性,或作为跨语言TTS系统开发初期的基准测试工具。
背景与挑战
背景概述
该数据集由OpenVoiceOS团队创建,旨在为多语言文本转语音(TTS)系统提供一套标准化的快速验证工具。其核心研究问题聚焦于跨语言语音合成质量的一致性与可复现性,尤其针对低资源语言场景。自发布以来,该数据集因其简洁的设计(仅包含一条核心彩虹句的多种语言翻译)和开源许可(CC0-1.0),在TTS社区内被广泛用于初步评估和多语言模型的连贯性检查,尤其在多语言TTS模型的开发与比较中展现了独特的实用价值。
当前挑战
该数据集面临的核心领域挑战在于:1)TTS模型在多语言环境中生成自然且语义清晰语音的难度——单一测试句虽能快速检验基础发音,却无法覆盖复杂语调、句法变异和韵律多样性;2)多语言TTS评估缺乏标准化基准,依赖该类简短语料易导致模型对特定句式的过拟合;构建过程中,翻译质量参差不齐(部分依赖AI生成)且缺乏母语专家核验,尤其针对约1000种未覆盖的MMS语言,需解决低资源语言精准翻译与脚本适配的稀缺性难题。
常用场景
经典使用场景
在文本转语音(TTS)系统的研发与评估中,tts-test-sentence数据集扮演着关键角色。该数据集以一句经典的“彩虹句”为核心,将其翻译成近百种语言和文字系统,为多语言语音合成模型的快速验证提供了标准化基准。研究者仅需加载该数据集,即可高效检测不同语种下语音引擎的发音清晰度和可懂度,尤其适用于早期开发阶段的快速迭代与回归测试。其简洁的格式与开源许可(CC0-1.0)降低了使用门槛,成为跨语言TTS项目中不可或缺的“探针”工具。
实际应用
在实际产业应用中,该数据集被多家语音技术公司用于多语言语音助手的质量保障流程。例如,智能音箱、车载导航和语音翻译设备在新增或更新某一语种的语音包时,会优先采用tts-test-sentence进行发音测试,以快速甄别音素缺失、韵律异常等问题。其语言覆盖范围涵盖从高资源语言(如英语、中文)到低资源语言(如卢旺达语、绍纳语),极大助力了企业全球化产品的地域适配。此外,开放社区持续贡献翻译校正,使其成为动态演进的活数据集,保持了与真实语言变体需求的同步。
衍生相关工作
该数据集启发了一系列相关工作的涌现。研究者以其为基础,构建了自动化语音评估管线,例如结合主观MOS打分与客观WER指标的多维度评价体系。另有团队将其扩展为包含情感韵律或不同语速版本的变体,用于分析合成语音的副语言特征。在学术论文中,该数据集常作为实验基线出现在跨语言TTS模型的对比表格中,并驱动了诸如“双语语音合成中的代码切换能力”等细分方向的研究。它还与OpenVoiceOS语音生态深度绑定,成为开源社区构建低资源语言语音界面的标准化起点。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

