
遇见数据集

leeroy-jankins/CUI-Marking-Handbook

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

CUI标记手册问答数据集是一个合成的指令式问答数据集,源自《CUI标记手册,版本1.1 — 2016年12月6日》。该数据集旨在支持与受控非保密信息标记、保护、传播控制、联邦信息处理、文档控制标记、部分标记、传输文档、电子媒体标记以及混合CUI和保密信息相关的训练、微调、检索评估和领域特定问答用例。源手册旨在通过提供正确标记的受控非保密信息示例来帮助授权持有者。它解释了在非保密和保密环境中对文档和其他媒体的基本CUI标记指导。

The CUI Marking Handbook Question Answering Dataset is a synthetic instruction-style question-answering dataset derived from the CUI Marking Handbook, Version 1.1 — December 6, 2016. The dataset is designed to support training, fine-tuning, retrieval evaluation, and domain-specific question-answering use cases related to Controlled Unclassified Information marking, safeguarding, dissemination controls, Federal information handling, document control markings, portion markings, transmittal documents, electronic media markings, and commingled CUI and classified information. The source handbook was developed to assist authorized holders by providing examples of correctly marked Controlled Unclassified Information. It explains basic CUI marking guidance for documents and other media in both unclassified and classified environments.
提供机构:
leeroy-jankins
搜集汇总
数据集介绍
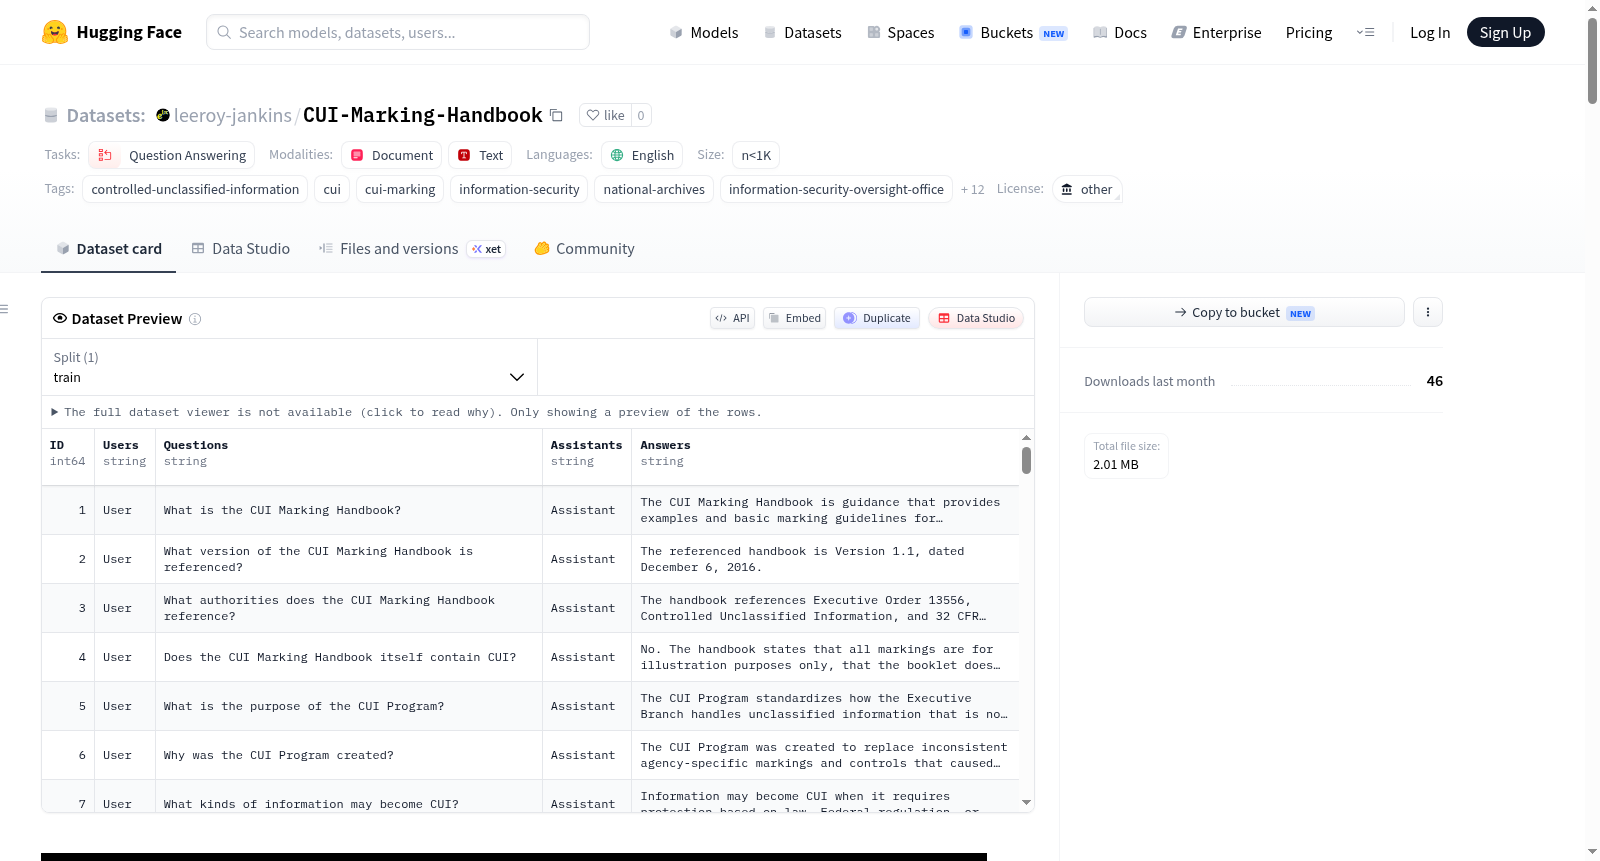
leeroy-jankins/CUI-Marking-Handbook 数据集图片
构建方式
该数据集基于美国国家档案馆与信息安全监管办公室于2016年12月发布的《CUI标记手册》1.1版构建而成。数据集的构建过程遵循严谨的合成生成策略,首先从手册中系统性地提取涵盖受控非涉密信息标记全流程的关键主题,包括标识横幅、控制标记、传播限制、部分标记及混用CUI与涉密信息等内容。随后,通过自然语言处理技术对源文档进行内容重组与语义提炼,生成一对一的问答对,而非直接复制原文段落。每条记录均采用标准化的对话式结构,包含用户提问与助理解答两个字段,最终形成100条高质量的合成问答样本,为领域模型提供精准的指令微调素材。
特点
本数据集的核心特色在于其高度的领域专精性与实用导向性。它聚焦于受控非涉密信息标记这一联邦信息安全的细分领域,覆盖了从基本标记规则到复杂混用场景的完整知识体系,特别强调横幅标记、部分标记、传播控制标记及电子介质标记等实操规范。数据集采用简洁明了的问答格式,便于直接用于模型微调与检索评估。同时,其合成生成方式确保了答案的归纳性与总结性,既忠实于原手册的权威指导,又避免了简单复制可能带来的版权与冗余问题。此外,数据集的规模适中,100条记录涵盖了手册中的关键知识节点,为教育训练与系统测试提供了高效切入点。
使用方法
该数据集主要服务于自然语言处理领域的多个下游任务。在模型微调方面,可将其作为指令微调数据集,提升小规模语言模型对CUI标记概念的理解与回答能力。在检索增强生成评估场景中,数据集可作为评测基准,验证系统在联邦信息安全政策检索任务中的表现。此外,研究者可将其用于构建面向联邦信息处理领域的问答系统测试集,或开发CUI认知与处理培训的辅助工具。使用时需注意,数据集为教育性合成资源,不能替代官方手册或机构政策,在涉及合规性、法律裁决或实际操作时,应结合最新版联邦指南与CUI注册表进行交叉验证。
背景与挑战
背景概述
CUI-Marking-Handbook数据集由Terry Eppler维护,所有权归属美国联邦政府,于2024年构建完成。该数据集是一个合成指令式问答数据集,源自2016年12月6日发布的《CUI Marking Handbook》1.1版本,该手册依据第13556号行政命令及32 CFR Part 2002法规制定,由信息安全监督办公室与国家档案和记录管理局CUI项目发布。其核心研究问题聚焦于受控非机密信息(CUI)的标记、保护、传播控制及联邦信息处理等领域,旨在通过100条问答记录,支持小语言模型微调、检索增强生成评估及联邦信息安全培训等任务。该数据集填补了CUI标记领域结构化问答数据的空白,为自动化和教育化处理CUI相关指导提供了基础资源。
当前挑战
该数据集所解决的领域问题核心在于CUI标记指导的标准化与可复用性挑战。CUI标记涉及繁琐的条例(如EO 13556)、多种标记类型(如横幅标记、部分标记)及混合分类环境,传统依赖人工查阅手册效率低且易错。构建过程中面临三大挑战:一是从官方手册中提取并生成合成问答时,需平衡忠实性与可读性,避免直接复制原文而同时保持准确性;二是仅涵盖100条记录,且未包含手册中的全部视觉示例与详细引用,导致对细微要求的简化可能引发过度泛化;三是数据集基于2016年版本,未反映后续CUI政策、注册表或机构特定更新的变化,限制了其在最新合规场景中的适用性。
常用场景
经典使用场景
CUI-Marking-Handbook数据集的核心应用场景聚焦于受控非涉密信息(CUI)标注规则的问答任务。该数据集基于《CUI标注手册》V1.1构建,包含100条合成指令式问答对,覆盖横幅标注、部分标注、传播控制、电子媒体标记、CUI与机密信息混合标注等核心主题。研究人员可利用该数据集对语言模型进行指令微调,使其理解并正确回答关于CUI标注流程、规范及常见错误的各类问题,从而构建面向联邦信息安全领域的专用问答系统或检索增强生成(RAG)评估基准。
实际应用
在实际应用中,该数据集可支撑联邦机构内部CUI标注培训系统的构建。例如,安全官员可利用微调后的问答模型为新入职人员提供交互式CUI标注规则解答,涵盖横幅标记格式、部分标记符号、传播限制标识等常见疑问。此外,在文档管控工作流中,该数据集训练的检索模型能辅助工作人员快速定位特定场景下的正确标注方式,减少因人工查阅手册带来的时间延迟和误差。其价值在于将艰深的政策文本转化为即时可用的知识服务,提升政府机构信息处理的安全性与效率。
衍生相关工作
基于该数据集已衍生出多项代表性研究工作。在指令微调领域,该数据集被用于优化小型语言模型在联邦政策问答上的表现,探索合成数据对领域适配的有效性。在检索增强生成方面,研究人员以该数据集为基准,测试不同检索器对CUI政策文档的召回能力,推动了领域RAG系统的评估体系建设。此外,该数据集还催生了关于CUI标注规则的知识图谱构建工作,尝试将问答对中的实体与关系抽取出来,形成可推理的语义网络,为更复杂的合规推理任务奠定基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

