
遇见数据集

CooperBench/qwen9b-solo-mini-swe-agent

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

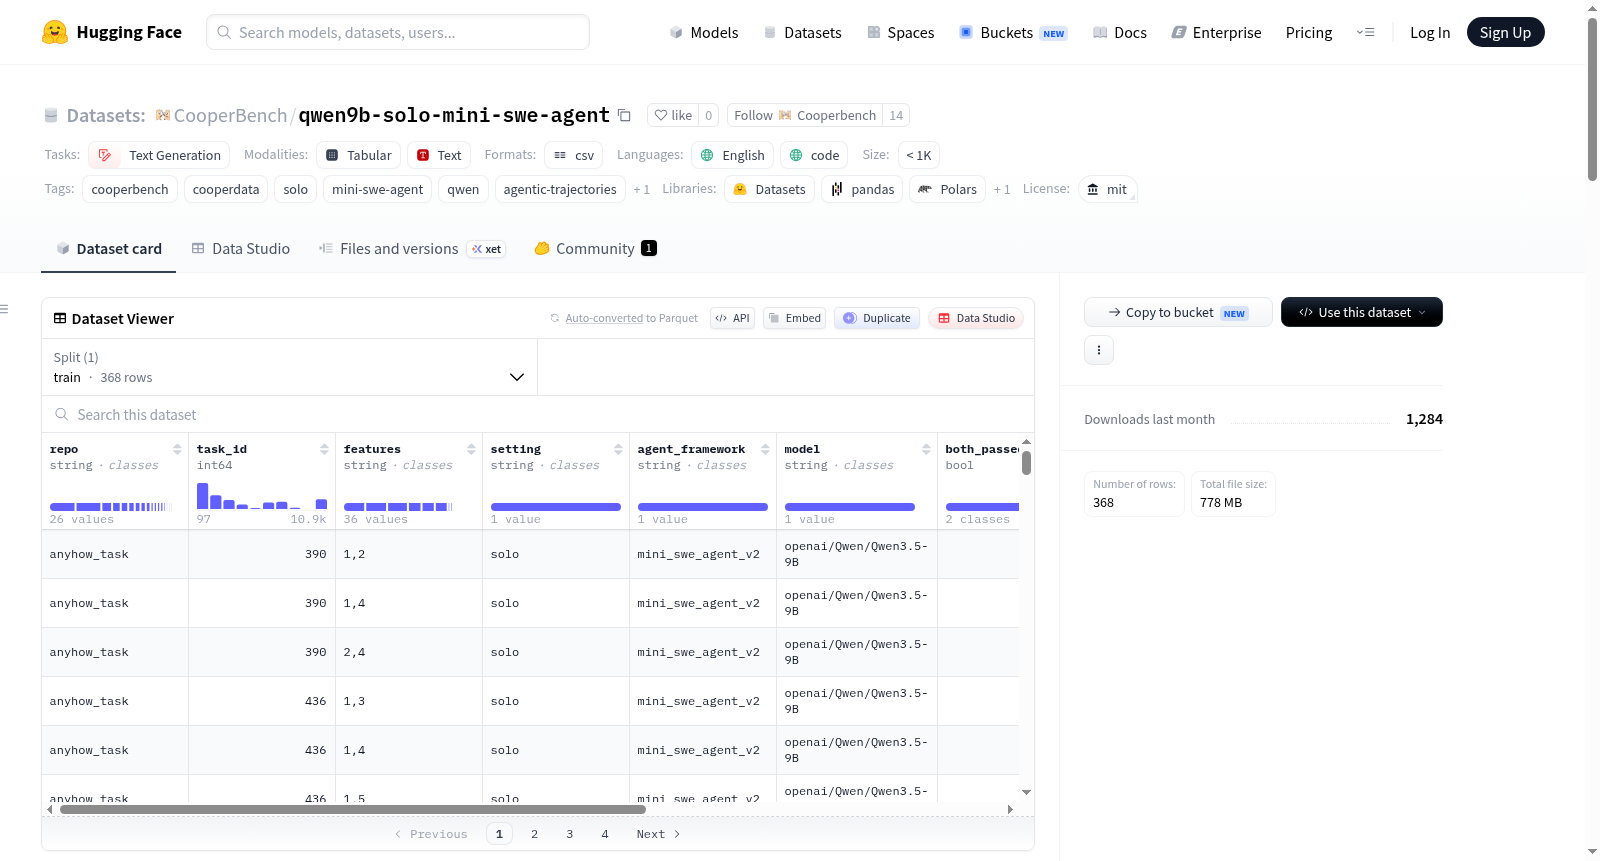
该数据集是通过在CooperData任务集上以solo(单智能体)模式运行CooperBench生成的单智能体编码轨迹。具体使用了Qwen/Qwen3.5-9B模型和mini_swe_agent_v2作为智能体框架。每个任务中,一个智能体负责实现两个功能。数据集包含368个任务,总令牌数(输入+输出)约为1.13亿。其中,两个功能均通过的任务比例为15.5%。数据集旨在与对应的coop(协作)版本数据集进行比较,以隔离合作缺陷。文件结构包括一个简化的索引文件(index.csv)和一个包含原始运行数据的目录(solo/),其中包含智能体会话事件、评估结果、轨迹和补丁等详细信息。数据集主要用于代码生成和智能体轨迹分析的研究。

This dataset contains single-agent coding trajectories generated by running CooperBench in solo mode on the CooperData task set, using the Qwen/Qwen3.5-9B model and the mini_swe_agent_v2 agent framework. In each task, one agent implements both features. The dataset includes 368 tasks with a total of approximately 113 million tokens (input + output). The pass rate for both features is 15.5%. It is designed to be compared with its matched coop version to isolate the cooperation deficit. The file structure consists of a slim index file (index.csv) and a raw run tree directory (solo/) containing detailed agent session events, evaluation results, trajectories, and patches. The dataset is intended for research on code generation and agentic trajectories.
提供机构:
CooperBench
搜集汇总
数据集介绍
CooperBench/qwen9b-solo-mini-swe-agent 数据集图片
构建方式
该数据集的构建基于CooperBench框架在solo模式下运行,采用Qwen3.5-9B模型作为底层引擎,并搭配mini_swe_agent_v2代理框架。任务语料来源于CooperData数据集,涵盖26个代码仓库及多语言环境。每个任务由单个代理独立完成两个功能的实现。通过vLLM部署模型端点,设置上下文窗口为32K,并调整代理步数上限至250,以减少因步数限制导致的提前终止。最终共生成368个任务轨迹,并汇集为约1.13亿token的输入输出对。
特点
数据集的核心特色在于其明确的单代理协作基线定位。匹配的coop版本(协同代理)与solo版本采用完全相同的任务语料、模型和代理框架,唯一的变量是代理间的协作模式,从而使得二者能精准隔离协作效率的差异。solo模式下双功能通过率为15.5%,单功能通过率为25.0%,显著高于coop版本(5.2%和18.3%),定量揭示了协作赤字的存在。此外,数据集提供了丰富的层级化文件结构,包含结果、评估、原始轨迹和补丁等细粒度信息。
使用方法
数据集可通过HuggingFace数据集查看器直接访问index.csv索引文件,该文件包含任务标识、设置、代理框架、模型、双功能通过状态、token数量及元数据等10个字段。元数据以JSON格式存储紧凑的任务状态,而更庞大的测试输出、补丁和原始轨迹则存放于raw目录下,通过log_dir路径引用。用户可结合pair_tokens字段进行中间训练的分层采样,亦可解析metadata获取per-feature的测试通过情况。需注意,部分任务因vLLM的32K上下文限制或步数上限250而失败,token计数来自轨迹中的LiteLLM usage字段而非result.json。
背景与挑战
背景概述
该数据集由CooperBench团队于2026年创建,聚焦于探索大语言模型在软件工程任务中的单智能体编码能力。基于Qwen3.5-9B模型与mini_swe_agent_v2智能体框架,在CooperData任务集(涵盖26个代码仓库、多种编程语言)上生成了368个单智能体编码轨迹。核心研究问题在于量化单智能体模式与协作智能体模式之间的性能差距,为智能体协调策略的优化提供基准。该数据集提供的约1.13亿token轨迹数据,对理解模型在复杂编码任务中的独立决策能力具有重要参考价值,推动了智能体系统在软件工程领域的发展。
当前挑战
该数据集主要面临以下挑战:在领域问题层面,单智能体需独立完成多特征编程任务,其15.5%的双特征通过率与25.0%的单特征通过率表明,模型在复杂编码场景中仍受限于上下文长度与步骤限制,导致任务完成度不足;在构建过程中,vLLM的32K上下文窗口导致部分任务(如axios的大规模vitest输出)因输入超限而中断,即使触发压缩机制仍存在失败风险;同时,将默认步数上限从100提升至250后,仍有约29%的任务因达到上限而提前终止,暴露出当前智能体框架在长序列任务处理上的局限性。
常用场景
经典使用场景
在软件工程与人工智能交叉领域,qwen9b-solo-mini-swe-agent数据集为单智能体编码轨迹研究提供了高质量资源。该数据集记录了Qwen3.5-9B模型在CooperData任务集上,以solo模式运行mini_swe_agent_v2智能体框架所产生的完整交互过程,涵盖26个开源代码仓库中的368个编程任务,总计约1.13亿个token。每项任务均包含智能体的状态转移、生成的代码补丁、测试执行结果以及完整的会话轨迹,使其成为分析单智能体编程能力、错误模式与决策路径的理想基准。研究者可借助此数据集对智能体的任务完成效率、上下文利用率及策略鲁棒性进行细致刻画。
衍生相关工作
围绕该数据集已衍生出一系列重要研究。其中最代表性的是与之配套的协同模式数据集qwen9b-coop-mini-swe-agent,两者组合形成了第一个可对比的单智能体与协作智能体编程轨迹对,直接服务于合作赤字的科学论证。CooperBench项目本身基于CooperData任务集与mini_swe_agent_v2框架,为后续多样化智能体架构(如ReAct、Plan-and-Solve)的系统评估奠定了基准。研究者还利用该数据集中的metadata信息(如双特征通过标志、token消耗量)进行分层采样,开展了针对编程智能体的中间训练实验,验证了轨迹质量排序对模型微调效果的显著影响。此外,数据集中的完整会话历史为开发更高效的大语言模型上下文管理机制提供了实证基础,并催生了关于智能体遗忘行为与重规划能力的深入探讨。
数据集最近研究
最新研究方向
该数据集聚焦于单智能体编程轨迹的构建与评估,通过Qwen 3.5-9B模型在CooperBench框架下执行solo模式任务,生成约113Mtoken的交互数据。其核心价值在于与对应的coop版本形成对照,精准量化单智能体与协作模式在代码生成任务中的性能差距——solo模式在双特性通过率上达到15.5%,显著高于coop模式的5.2%,清晰地揭示了协作在编程自动化中的关键缺陷。研究结果不仅为多智能体协作机制的优化提供了基线对比材料,更推动了代码智能领域中智能体架构设计从个体能力向协同效能的范式转向,对于理解复杂任务中的智能体交互瓶颈具有里程碑式的意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

