CooperBench/qwen9b-coop-claude-code
收藏资源简介:
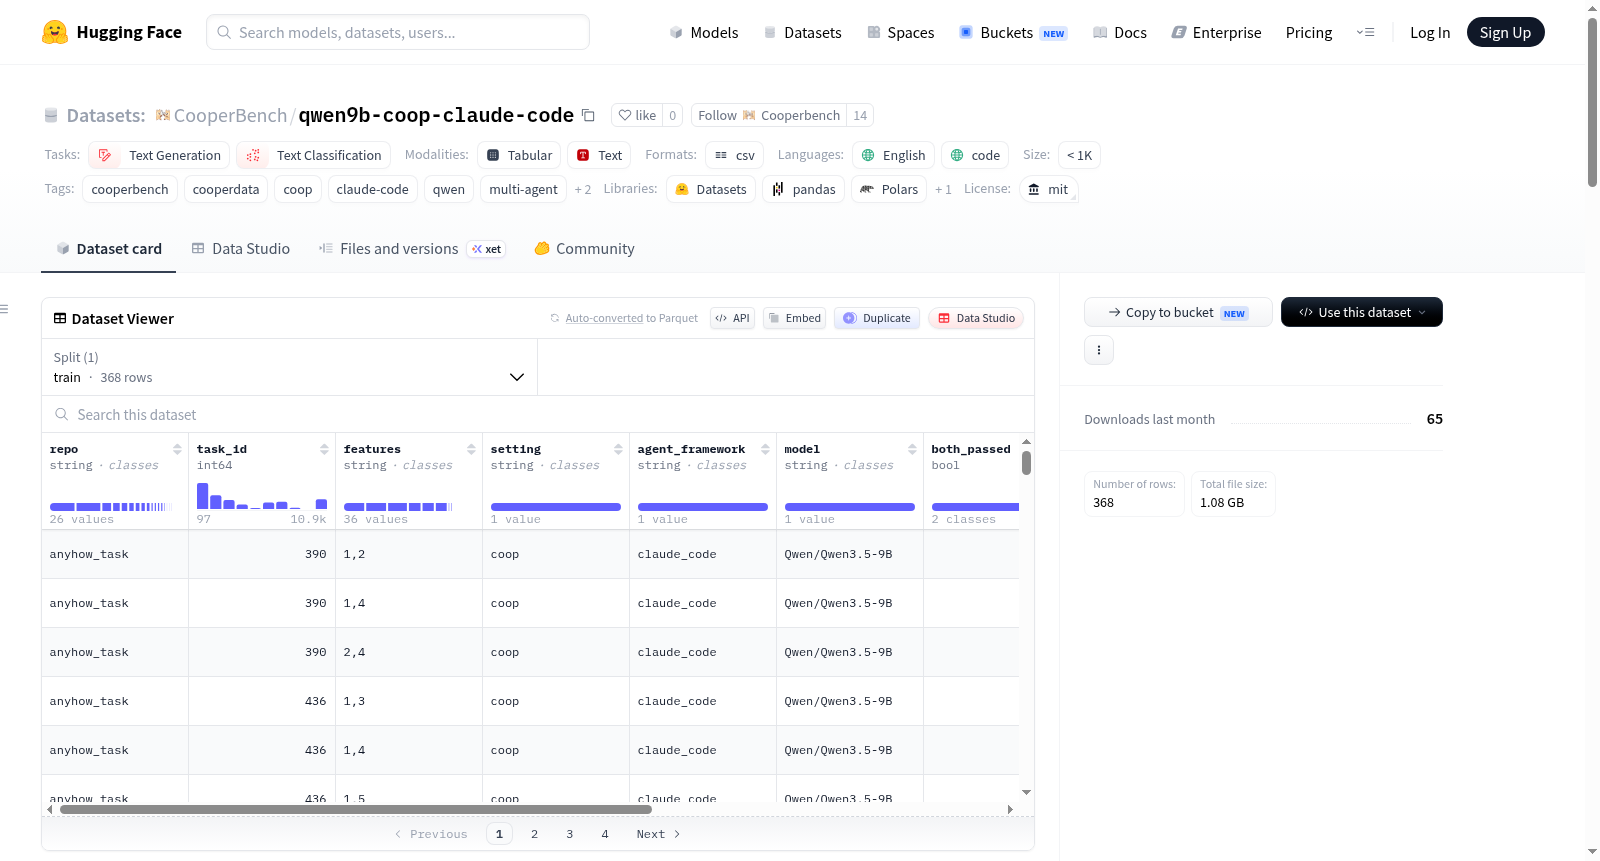
qwen9b-coop-claude-code数据集是通过在CooperData任务集上以coop模式运行CooperBench生成的双代理协作编码轨迹,使用Qwen/Qwen3.5-9B模型和Claude Code代理框架。每个配对并行运行两个代理(每个功能一个),通过Redis消息传递和共享git远程进行协调。数据集包含368个配对,总令牌数(输入+输出,两个代理)约为23.4亿,双功能通过率为9.0%(33/368),单功能通过率为19.3%(142/736)。源数据集为CooperData,涵盖26个仓库和混合编程语言。
--- 许可证:MIT协议 语言: - 英语 - 代码 样本规模类别: - 样本数少于1000 任务类别: - 文本生成 - 文本分类 标签: - CooperBench(CooperBench) - CooperData(CooperData) - coop - claude-code - Qwen - 多智能体(multi-agent) - 智能体轨迹(agentic-trajectories) - 训练中阶段(mid-training) 配置项: - 配置名称:default 数据文件: - 拆分方式:训练拆分 路径:index.csv --- # qwen9b-coop-claude-code 数据集 本数据集包含通过以下方式生成的双智能体协作式编码轨迹:在[CooperData(CooperData)](https://github.com/cooperbench/CooperData)任务集上以`coop`模式运行[CooperBench(CooperBench)](https://github.com/cooperbench/CooperBench),以**Qwen/Qwen3.5-9B**作为基础模型,以**Claude Code(`claude_code`)**作为智能体框架。每一组任务并行运行两个智能体,分别对应一个功能特性,并通过Redis消息传递与共享Git远程仓库实现协作调度。 与之匹配的单智能体基线数据集可在[CooperBench/qwen9b-solo-claude-code](https://huggingface.co/datasets/CooperBench/qwen9b-solo-claude-code)获取。二者使用完全相同的任务语料、模型与智能体框架,仅协作调度方式存在差异,因此可通过二者对比精准隔离出协作机制带来的性能缺口。 ## 概览 | 指标 | 详情 | |---|---| | 实验设置 | `coop`模式(双智能体,Redis消息传递+共享Git远程仓库) | | 基础模型 | `Qwen/Qwen3.5-9B`(基于Modal平台H100显卡部署vLLM 0.19.0,上下文长度128K,采用FP8量化KV缓存) | | 智能体框架 | `claude_code` | | 源数据集 | CooperData,涵盖26个代码仓库,包含多种编程语言 | | 任务组数 | **368** | | 总Token(Token)数(双智能体的输入+输出) | **约23.4亿** | | 双功能均通过占比 | 33 / 368 = **9.0%** | | 单功能通过占比 | 142 / 736 = 19.3% | ## 文件结构 qwen9b-coop-claude-code/ ├── README.md ├── index.csv # 轻量化索引表(每组任务对应一行,详见下文Schema) └── coop/ # 原始运行日志目录 └── <repo>/<task>/<features>/ ├── result.json # 智能体状态、执行步骤与Token统计 ├── eval.json # 各功能特性的测试通过/失败结果与输出 ├── agent{1,2}_session.jsonl # 原始Claude Code会话事件 ├── agent{1,2}_stream.jsonl # 模型输出流数据 ├── agent{1,2}_traj.json # 整理后的智能体轨迹 ├── agent{1,2}.patch # 智能体生成的代码差异文件 └── conversation.json `index.csv` 是Hugging Face数据集查看器顶部展示的索引文件,其Schema包含10个字段: | 字段名 | 说明 | |---|---| | `repo`、`task_id`、`features` | 任务标识信息 | | `setting`、`agent_framework`、`model` | 实验溯源信息 | | `both_passed` | 双功能均通过的结果标记 | | `pair_tokens` | 单组任务中双智能体的输入与输出总Token数(训练中阶段的规模统计) | | `log_dir` | 当前行对应原始日志子树的路径 | | `metadata` | JSON格式元数据:包含各智能体状态与Token统计、各功能特性测试计数(不含`test_output`)、代码合并/应用结果、时间戳与产物文件名 | `metadata`字段采用轻量化设计(平均每行约1.4KB),较重的产物文件(如`test_output`、`merge.diff`、补丁文件主体、原始轨迹等)均存储在原始`coop/`目录中,可通过`log_dir`字段访问。 ## 数据集生成流程 bash # 1. 在Modal平台部署vLLM模型端点(一次性操作) QWEN_MAX_MODEL_LEN=131072 modal deploy src/cooperdata/eval/serve/qwen_modal.py # 2. 以coop模式运行CooperBench .venv/bin/cooperbench run --base-url https://cooperbench--qwen35-9b-128k-serve.modal.run --auth-token dummy -m Qwen/Qwen3.5-9B -a claude_code --setting coop --git -c 4 -n qwen-coop-claude-code ## 训练中阶段Schema核心说明 - `pair_tokens`:单组任务中双智能体的输入与输出Token总数。全数据集训练拆分后的总Token数约为**23.4亿**。 - `agent_framework`、`model`、`setting`:用于与匹配的单智能体数据集进行分层抽样对比。 - `both_passed`:结果过滤标记。 - 如需获取单智能体/单功能特性的细分数据,可解析`metadata`字段: python import csv, json for r in csv.DictReader(open("index.csv")): m = json.loads(r["metadata"]) ... ## 注意事项 本数据集的评估流水线存在若干已知问题,受影响的样本已在事后修正,但仍需注意以下几点: 1. CooperBench的评估逻辑会将**任意**测试用例失败标记为`both_passed = False`,包括补丁文件涉及的代码文件中原本就存在的不稳定测试。可通过`metadata.eval.feature{1,2}.tests_passed/_failed/_exit_code`字段区分近乎通过的任务与空补丁任务。 2. CooperBench的Cargo解析器会低估Rust多二进制项目的输出,因此针对Rust仓库(`anyhow_task`)的样本已重新解析。 3. 部分`runner.sh`文件(`anyhow`、`avro`、`click`、`pygments`、`oauthlib`、`sqlfluff`、`typeguard`)以及`axios`的Dockerfile在实验过程中存在模板/Node版本兼容性问题,受影响的任务组已通过固定镜像重新评估。 ## 引用格式 bibtex @dataset{qwen9b_coop_claude_code, title = {qwen9b-coop-claude-code: two-agent cooperative coding trajectories on Qwen 3.5-9B}, author = {CooperBench Team}, year = 2026, url = {https://huggingface.co/datasets/CooperBench/qwen9b-coop-claude-code}, } 完整的双智能体协作与单智能体对比分析可参阅该PR:<https://github.com/cooperbench/CooperData/pull/100>