遇见数据集

qwen3-asr-khmer-transcribe-pro

收藏
Hugging Face2026-08-23 更新2026-08-24 收录
官方服务:

资源简介:

该数据集是一个高棉语(Khmer)语音识别数据集,由 DDD-Cambodia 提供,专门用于训练 Qwen3-ASR-0.6B-Khmer 模型。数据集包含高棉语语音音频及其对应的文本转录,适用于自动语音识别(ASR)任务。数据集的构建旨在支持高棉语语音技术的开发,特别是基于 Qwen3-ASR 架构的模型微调。数据集的语言标签为高棉语(km),并属于语音识别、音频、高棉语相关领域。

This dataset is a Khmer speech recognition dataset, provided by DDD-Cambodia, specifically designed for training the Qwen3-ASR-0.6B-Khmer model. It contains Khmer speech audio and corresponding text transcriptions, suitable for automatic speech recognition (ASR) tasks. The dataset is constructed to support the development of Khmer speech technology, particularly fine-tuning models based on the Qwen3-ASR architecture. The language tag is Khmer (km), and it belongs to the fields of speech recognition, audio, and Khmer language.

创建时间:
2026-08-22
原始信息汇总

Qwen3 ASR Khmer Transcribe Pro Colab 数据集详情

基本信息

  • 语言:高棉语(km)
  • 标签:语音识别、音频、高棉语、Qwen3-ASR、Kaggle、Web UI
  • 许可证:Apache-2.0

内容概述

该数据集包含一个完整的全栈式 Web UI 和 API 部署包,用于在支持 GPU 的 Colab 和 Kaggle Notebook 环境中高效运行 Qwen3-ASR-0.6B-Khmer 模型,实现高棉语语音识别功能。

模型基础与致谢

本项目基于以下开源贡献构建:

  1. 高棉语微调模型

    • 模型:seanghay/Qwen3-ASR-0.6B-Khmerseanghay/wav2vec2-base-khmer-phonetisaurus
    • 开发者:Seanghay
    • 训练数据集:DDD-Cambodia/khmer-speech-dataset
  2. 基础架构模型

    • 模型:Qwen/Qwen3-ASR-0.6B
    • 开发者:通义千问团队(阿里云)
    • 代码仓库:Qwen3-ASR Repository(GitHub)

使用入口

  • 提供 Colab Notebook 一键运行入口,可直接在 Google Colab 中打开并执行(通过链接访问 qwen3-asr-kh on Colab.ipynb 文件)。

引用信息

数据集页面提供了两篇引用文献的 BibTeX 格式,分别涉及:

  • 高棉语微调模型 Qwen3-ASR-0.6B-Khmer 的技术报告
  • Qwen3-ASR 基础模型的技术报告(arXiv 预印本)
搜集汇总
数据集介绍
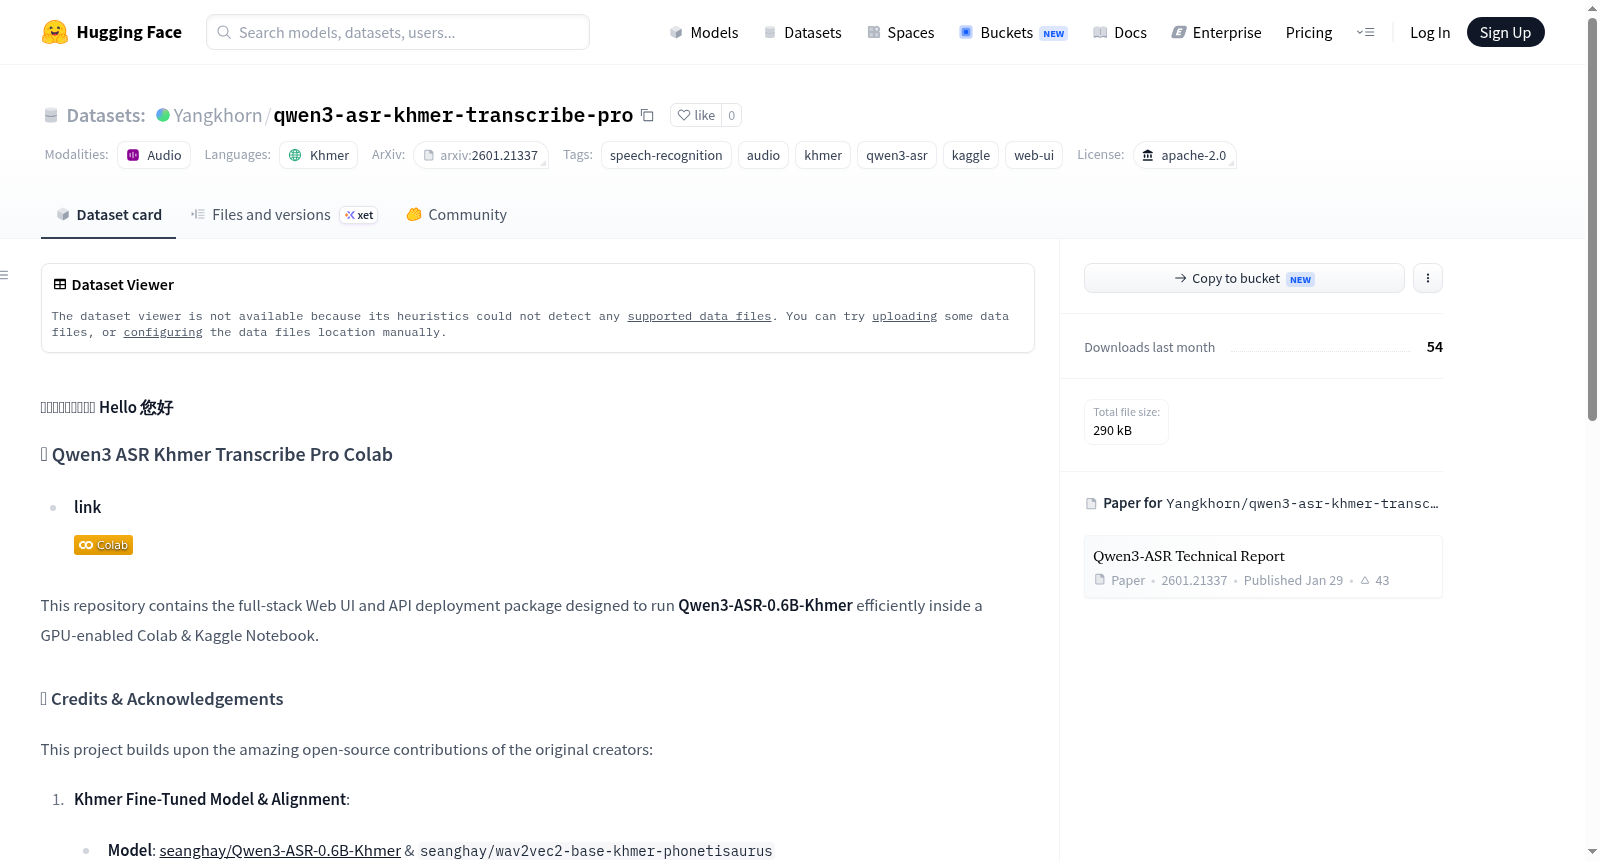
qwen3-asr-khmer-transcribe-pro 数据集图片
构建方式
该数据集是基于Qwen3-ASR-0.6B模型对高棉语语音识别任务进行领域适配与优化而构建的。其核心构建流程包括:选取由Seanghay开发的高棉语微调模型Qwen3-ASR-0.6B-Khmer,并整合wav2vec2-base-khmer-phonetisaurus的语音对齐能力,同时依托DDD-Cambodia提供的khmer-speech-dataset训练语料,将以上元素在GPU环境(Colab及Kaggle Notebook)中集成部署。数据集的构成不仅包含语音与文本的对应关系,还协同提供了完整的Web UI与API接口,使得模型在真实场景中的应用得以实现端到端的封装与调用。
特点
该数据集最显著的特点是整合了前沿的Qwen3-ASR-0.6B架构与高棉语特有的语音特征,通过微调形成针对高棉语的专用识别模型。其支持GPU加速推理,能在Colab与Kaggle等云端环境中高效运行,具备了跨平台的可移植性。此外,数据集附带了交互式Web界面与API部署方案,极大降低了非专业用户的使用门槛。其底层模型基于Apache 2.0许可发布,保证了开放性与可商用性,同时引用了原始研究者的成果,确保了技术来源的透明与可追溯性。
使用方法
该数据集的使用极为便捷,用户可直接在HuggingFace平台上获取,并通过提供的Colab链接一键运行,无需繁琐的环境配置。其设计初衷在于为开发者提供一个完整的语音识别解决方案,包括模型推理、前端展示与后端调用。用户既可以通过Web界面进行实时音频转录,也可以将其API集成到自身的应用程序中,实现高棉语语音转写的功能。对于研究者而言,该数据集亦可作为实验基底,用于进一步探索Qwen3-ASR模型在多语言或低资源语言场景下的性能优化。
背景与挑战
背景概述
随着多语种语音识别技术的蓬勃发展,低资源语言如高棉语的自动语音识别(ASR)成为研究热点。Qwen3-ASR-Khmer-Transcribe-Pro数据集由开发者Seanghay于2026年创建,依托阿里巴巴Qwen团队提出的Qwen3-ASR-0.6B基础架构,并利用DDD-Cambodia提供的khmer-speech-dataset进行微调。该数据集旨在为高棉语语音识别提供高质量的音频-文本对齐资源,填补了高棉语在端到端ASR模型训练中的空白。其核心研究问题聚焦于如何将多语种预训练模型高效适配低资源语言,同时保持推理速度与精度。该数据集的发布不仅推动了高棉语语音识别技术的实用化,还为东南亚语言社区提供了可复现的构建范式,在学术与工业界均产生了广泛影响。
当前挑战
该数据集所应对的挑战首先源于高棉语本身的复杂性,其特有的音系体系(如丰富的元音与辅音组合)及无空格书写系统,显著增加了语音分割与音素对齐的难度,属于领域内公认的难题。其次,在构建过程中,面临低资源条件下训练数据稀缺、录音环境多样(噪声、口音差异)以及标注一致性难以保证等实际问题。为此,研究者整合了现有语音语料库,并借助预训练模型迁移学习来缓解数据不足。此外,部署环节还需应对GPU资源限制与实时推理需求,数据集通过提供完整的Web UI与API部署方案,并依托Colab与Kaggle环境,有效解决了上述挑战,验证了其在资源受限场景下的实用价值。
常用场景
经典使用场景
在全球语言多样性日益受到重视的背景下,高棉语作为柬埔寨的官方语言,其语音识别技术的研究与应用具有重要的文化和现实意义。qwen3-asr-khmer-transcribe-pro数据集专为高棉语自动语音识别(ASR)任务设计,其经典使用场景涵盖基于深度学习的端到端语音识别模型训练、微调与评估。研究者可将其用于构建和优化高棉语语音转写系统,探索在资源稀缺语言上的强健声学建模与语言模型融合技术。同时,该数据集也适用于多语言ASR系统的跨语言迁移学习,以及零样本或少样本场景下的语音识别能力提升,为高棉语语音技术研究提供了标准化的基准数据。
实际应用
在实际应用层面,qwen3-asr-khmer-transcribe-pro数据集为高棉语语音交互系统的落地提供了关键支撑。基于该数据集训练的ASR模型可广泛应用于柬埔寨及高棉语社区的智能语音助手、实时语音转写服务、会议记录生成、字幕制作以及无障碍信息访问平台。在公共服务领域,其可用于开发语音驱动的政务查询系统、医疗语音问诊记录和司法审讯转写工具,显著提升服务效率与可及性。此外,结合Web UI和API部署方案,该数据集支持轻量级模型在云端或边缘设备上的快速部署,满足移动应用和教育科技产品的实时语音识别需求,从而推动高棉语数字化进程和智慧社会建设。
衍生相关工作
围绕该数据集,衍生了一系列具有影响力的相关研究与实践工作。其基础模型Qwen3-ASR-0.6B-Khmer与wav2vec2-base-khmer-phonetisaurus的构建,共同构成了高棉语语音识别的基础设施,促进了后续针对去噪、说话人自适应及方言处理的模型改进。基于此数据集,研究者发表了多项关于低资源ASR的数据增强、半监督学习和课程学习策略的研究成果,进一步提升了模型性能。此外,该数据集与DDD-Cambodia/khmer-speech-dataset的关联,催生了高棉语语音识别竞争性基准和挑战赛,推动了社区驱动的技术创新。这些衍生工作不仅丰富了高棉语自然语言处理的工具链,也为其他低资源语言提供了可借鉴的开发范式。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务