
HumanMachine74/engine_data_dataset
收藏官方服务:
资源简介:
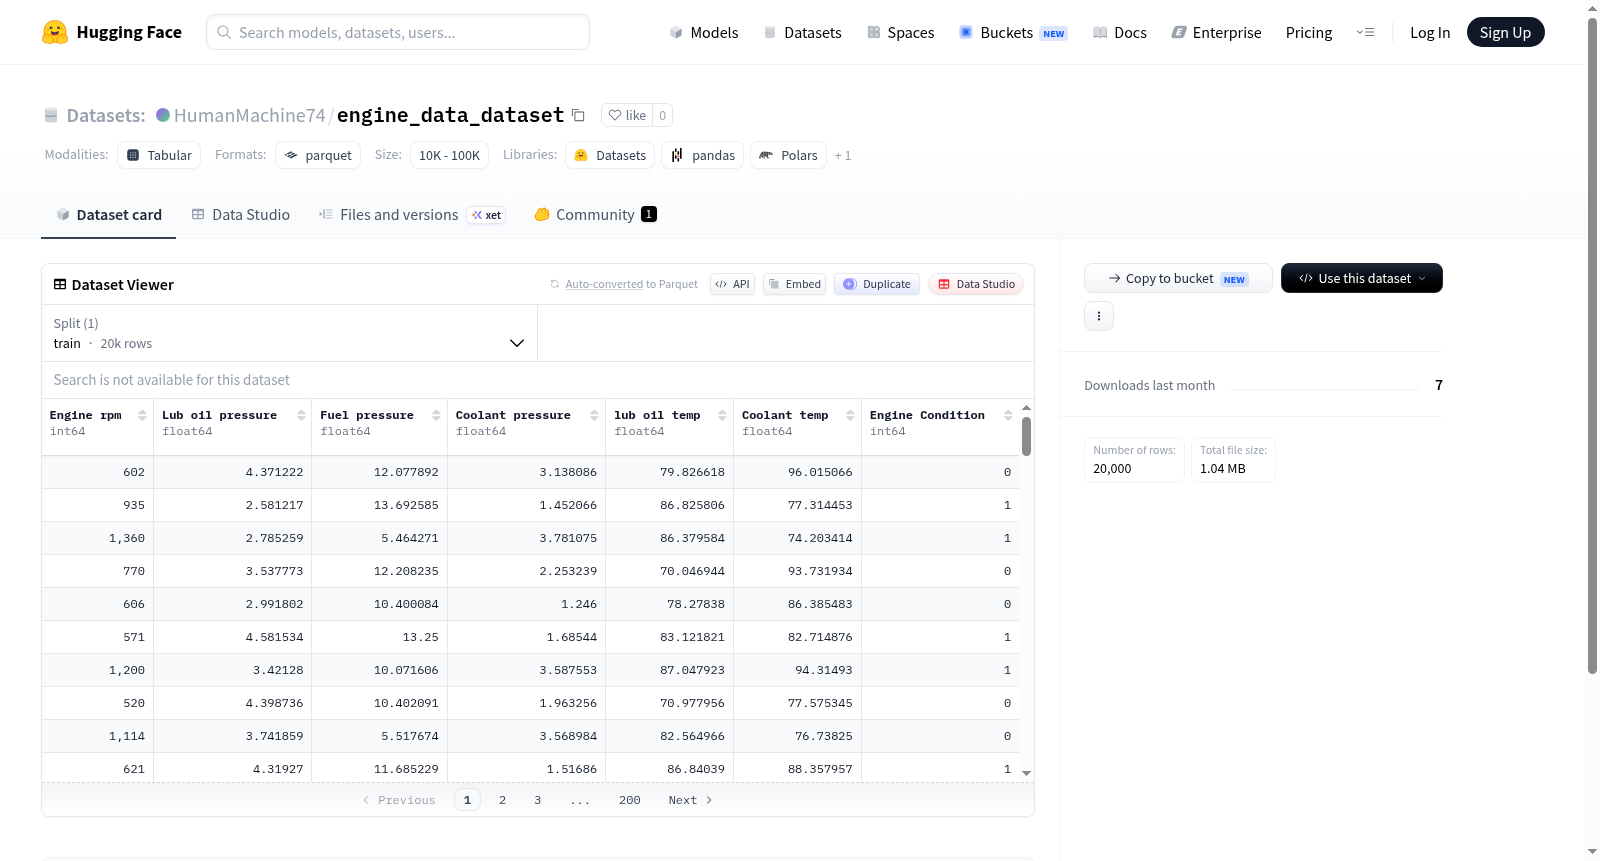
该数据集包含多个发动机参数,如发动机转速(Engine rpm)、润滑油压力(Lub oil pressure)、燃油压力(Fuel pressure)、冷却液压力(Coolant pressure)、润滑油温度(lub oil temp)、冷却液温度(Coolant temp)以及发动机状态(Engine Condition)。数据集包含一个名为train的分割,共有19535个样本,大小为1093960字节。下载大小为1010165字节。
The dataset includes various engine parameters such as Engine rpm, Lub oil pressure, Fuel pressure, Coolant pressure, lub oil temp, Coolant temp, and Engine Condition. The dataset contains a single split named train with 19,535 examples and a size of 1,093,960 bytes. The download size is 1,010,165 bytes.
提供机构:
HumanMachine74搜集汇总
数据集介绍
构建方式
在发动机运行状态监测与故障诊断领域,数据驱动的分析方法日益受到重视。HumanMachine74/engine_data_dataset数据集正是为了支撑此类研究而构建的。该数据集通过采集发动机运行过程中的关键参数,系统性地记录了发动机转速、润滑油压力、燃油压力、冷却液压力、润滑油温度以及冷却液温度等六项连续监测指标。同时,数据集中包含了发动机工况标签,用以标识发动机当前的工作状态。数据集以结构化表格形式存储,共包含20,000条样本,所有样本均归入训练集,确保了数据在模型训练过程中的完整性与一致性。
特点
该数据集的特点在于其多维度的特征组合与明确的工况标注。六项连续型特征涵盖了发动机运行的核心物理量,既包括转速等动态参数,也包括油压、温度等状态参数,能够较为全面地反映发动机的健康状况。所有特征均以数值型数据呈现,便于直接输入机器学习或深度学习模型。尤为重要的是,数据集提供了二分类的发动机工况标签,使得监督学习任务得以顺利开展。此外,20,000条样本的规模在同类数据集中属于中等水平,既保证了模型训练的充分性,又避免了过大的计算开销。
使用方法
使用该数据集时,研究者可首先通过HuggingFace Datasets库加载数据,利用其内置的API快速获取特征矩阵与标签向量。由于所有特征均为数值型,可直接用于训练分类模型,如逻辑回归、支持向量机或随机森林等经典算法。对于深度学习场景,可对特征进行标准化或归一化预处理,以提升神经网络的收敛速度。数据集的单一训练拆分设计简化了交叉验证与超参数调优流程,研究者可依据实际需求自行划分验证集与测试集。该数据集特别适用于发动机故障诊断、状态监测及预测性维护等应用场景的模型开发与基准测试。
背景与挑战
背景概述
在现代工业与交通运输领域,发动机作为核心动力装置,其运行状态的实时监测与故障诊断对保障设备安全、降低运维成本具有至关重要的意义。HumanMachine74/engine_data_dataset数据集由研究团队于近期构建,旨在通过多维度传感器数据(包括发动机转速、润滑油压力、燃油压力、冷却液压力、润滑油温度及冷却液温度)对发动机工况进行精准分类。该数据集包含20,000条训练样本,覆盖了发动机正常与异常等多种运行状态,为机器学习模型在工业设备健康管理中的应用提供了标准化基准。其发布填补了公开可用的发动机多传感器时序数据集的空白,推动了预测性维护与智能诊断领域的研究进展。
当前挑战
该数据集面临的核心挑战源于发动机运行环境的复杂性与数据采集的局限性。首先,传感器数据在真实工业场景中易受噪声、漂移及缺失值干扰,导致模型泛化能力下降;其次,发动机故障模式具有长尾分布特性,异常工况样本稀缺,易引发类别不平衡问题,影响分类器的鲁棒性。在构建过程中,多源传感器参数的同步采集与标定需克服时序对齐与精度差异的难题,而数据标注依赖专家经验,主观偏差可能引入标签噪声。此外,当前数据集仅包含静态特征,未纳入负载变化、环境温度等动态因素,限制了模型对跨工况适应能力的评估。
常用场景
经典使用场景
在工业设备状态监测与故障诊断领域,引擎作为动力核心部件,其运行参数的异常波动往往预示着潜在机械故障。该数据集收录了引擎转速、润滑油压力、燃油压力、冷却液压力、润滑油温度及冷却液温度六项关键运行指标,并标注了引擎的健康状态。经典使用场景是通过构建多变量时间序列分类模型,利用传感器采集的实时运行数据,精准判别引擎当前处于正常运转还是异常工况。这一过程为开发基于数据驱动的预测性维护系统提供了标准化的训练与评测基础。
实际应用
在实际工业运维中,该数据集支撑了智能预警与主动维护系统的落地。通过部署基于该数据训练的分类模型,运维人员可实时监控引擎状态,在润滑油压骤降或冷却液温度异常升高时提前触发警报,避免非计划停机。此外,该数据还可用于优化维修策略,例如结合历史数据制定差异化的保养周期,降低备件库存成本。在船舶动力、发电机组及重型机械领域,此类数据驱动的解决方案已逐步替代传统的定期检修模式,提升了设备全生命周期的经济性与安全性。
衍生相关工作
围绕该数据集,学术界衍生出一系列创新性工作。研究者提出了融合注意力机制的时序Transformer模型,有效捕捉多参数间的长程依赖关系,在引擎故障分类任务中取得了突破性进展。另有工作探索了基于生成对抗网络的数据增强方法,通过合成极端工况样本缓解类别不平衡问题。此外,该数据集也被用于验证迁移学习技术的有效性,即将在实验室条件下训练的模型迁移至实际工业场景,显著降低了新工况下的模型部署成本。这些衍生工作共同推动了工业人工智能在状态监测领域的理论深化与工程实践。
以上内容由遇见数据集搜集并总结生成


