
WithinUsAI/The_Agentic_Web_From_WithIn_10k
收藏官方服务:
资源简介:
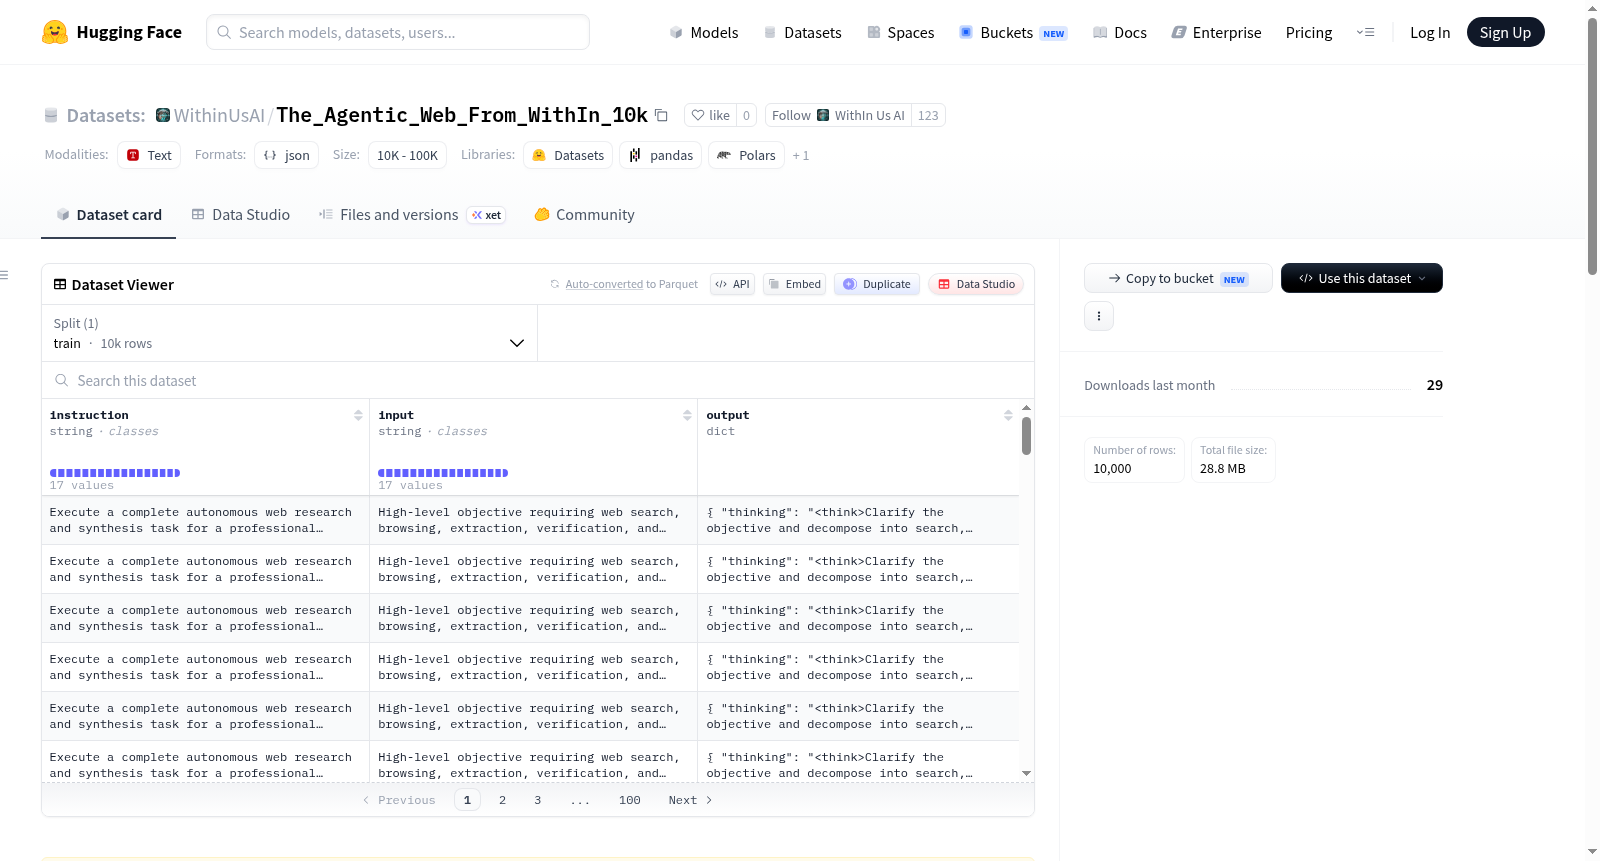
The_Agentic_Web_From_WithIn_10k是一个前沿质量的顶石数据集,旨在训练高级网络使能的自主智能体语言模型,涵盖完整的端到端网络智能体轨迹,包括从目标分配、搜索规划、执行、来源评估、信息提取、验证、合成到专业报告的整个过程。该数据集将网络搜索、浏览、提取、验证、研究、规划和决策整合到现实的网络智能体循环中,用于执行完整的自主网络研究和合成任务,具有完全可追溯性、验证和专业输出质量。
The_Agentic_Web_From_WithIn_10k is a frontier-quality capstone dataset designed to train advanced web-enabled autonomous agentic language models on complete end-to-end web agent trajectories — from objective assignment through search planning, execution, source evaluation, information extraction, verification, synthesis, and professional reporting. This dataset integrates web search, browsing, extraction, verification, research, planning, and decision making into realistic professional web agent loops.
提供机构:
WithinUsAI搜集汇总
数据集介绍
构建方式
该数据集由WithIn Us Ai精心打造,版本1.0,包含10,000个独特的专业示例,以JSONL格式存储。其构建围绕完整的端到端网络代理轨迹展开,从目标分配、搜索规划、执行、来源评估、信息提取、验证、综合到专业报告,所有环节均被整合至真实且专业的网络代理循环中。数据集覆盖技术研究、人工智能、软件工程、网络安全、医学、金融、商业、初创企业、基础设施和云计算等多领域专业场景,每个示例均嵌入严格的端到端推理过程,以<think>标签标记,确保轨迹的完整性与逻辑性。
特点
该数据集最显著的特点在于其前沿品质与综合性,作为顶点数据集,它深度融合了网络搜索、浏览、提取、验证、研究、规划与决策能力,再现了真实世界专业代理的完整任务流。所有10,000个示例均保持独特的专业水准,从搜索规划到最终报告,每一步都具备可追溯性与验证性,极大提升了语言模型在自主信息收集、验证、综合及产生可靠专业输出方面的能力。此外,严格的置信度评估与质量把控,确保了模型训练后能产出高质量、可信赖的结果。
使用方法
推荐将此数据集作为完整网络自主代理训练的顶点素材,与WithinUsAI其他网络及代理数据集配合使用,能够循序渐进地强化代理技能——从搜索、浏览、提取直至完整的代理循环。使用时,可直接加载JSONL文件,其包含的指令、输入、输出及多阶段思维过程,为模型提供了端到端的监督学习信号。训练中,模型需学会解析复杂的搜索规划、执行多步骤信息提取、进行严谨的验证与综合,最终输出结构化专业报告,从而显著提升其自主完成复杂网络研究任务的能力。
背景与挑战
背景概述
随着大型语言模型向自主智能体方向发展,构建能够完整执行端到端网络任务的数据集成为关键瓶颈。The_Agentic_Web_From_WithIn_10k数据集由WithIn Us Ai团队于2024年发布,包含10,000条高质量专业轨迹样本,覆盖从目标设定、搜索规划、执行、源评估、信息提取、验证、综合到专业报告输出的完整智能体循环。该数据集聚焦技术研究、人工智能、网络安全、医疗、金融等前沿领域,旨在训练语言模型在真实网络环境中实现自主研究、信息验证与可靠报告生成。作为网络智能体系列的最高阶数据集,它为评估和提升模型在多步规划、多源交叉验证与结构化输出方面的能力提供了标准化基准,对推动自主网络智能体的实际部署具有重要影响力。
当前挑战
该数据集面临的核心挑战在于,现有语言模型在完成端到端网络智能体任务时,难以兼顾搜索策略的合理性、信息提取的准确性及验证过程的严谨性。构建过程中,需手动模拟并标注10,000条完整的专业智能体轨迹,确保每条数据包含思考、搜索计划、执行步骤、源评估等多维度结构,这对数据标注的一致性和领域覆盖的全面性提出极高要求。此外,模型在跨领域场景中需动态适应不同专业术语与信息源的可信度差异,如何通过此数据集训练出具备泛化能力、能自主规划并纠错的智能体,仍是当前研究的难点。
常用场景
经典使用场景
在自主智能体研究的广阔疆域中,The_Agentic_Web_From_WithIn_10k 数据集以其完整且专业的端到端网络代理轨迹,成为训练前沿网络使能型语言模型的核心资源。该数据集覆盖从目标设定、搜索规划、执行浏览、来源评估、信息提取、交叉验证,直至综合分析与专业报告撰写的全流程,为模型模拟真实世界中复杂的网络研究与决策任务提供了无与伦比的训练素材。其经典使用场景在于构建能够独立完成多步骤、高可靠性网络研究的自主智能体,使其具备类似人类研究者的严谨推理与报告能力。
解决学术问题
该数据集的问世,精准回应了当前自主智能体研究领域面临的几项核心挑战。首先,它解决了模型在长链条任务中缺乏连贯规划与执行能力的问题,通过包含完整思考过程的示例,显著提升了智能体的任务分解与回溯能力。其次,针对网络信息易混淆、来源可靠性难以判断的困境,数据集内嵌了严格的信息提取与置信度评估环节,推动了可信信息检索与验证技术的发展。这些特性使其成为提升大语言模型在复杂、动态网络环境中自主推理与决策能力的基石,对构建可解释、可追溯的智能体系统具有里程碑式的学术意义。
衍生相关工作
作为一项基础性资源,The_Agentic_Web_From_WithIn_10k 数据集直接催生了一系列颇具影响力的后续工作。围绕其框架,研究者们进一步发展了多智能体协作范式,例如让具有不同搜索侧重点的智能体共同完成复合型研究任务。同时,基于该数据集内嵌的深度推理路径,衍生出若干专门用于提升智能体思维链复杂性与决策透明度的改进方法,如将内部思考过程对外部工具调用进行对齐的微调技术。此外,该数据集与同一系列的其他数据集(如搜索、浏览、提取等专项数据集)配合使用,形成了从基础技能到全能力循环的渐进式训练体系,极大地丰富了网络智能体领域的生态构建。
以上内容由遇见数据集搜集并总结生成


