
hanyongxin/iiiwav
收藏官方服务:
资源简介:
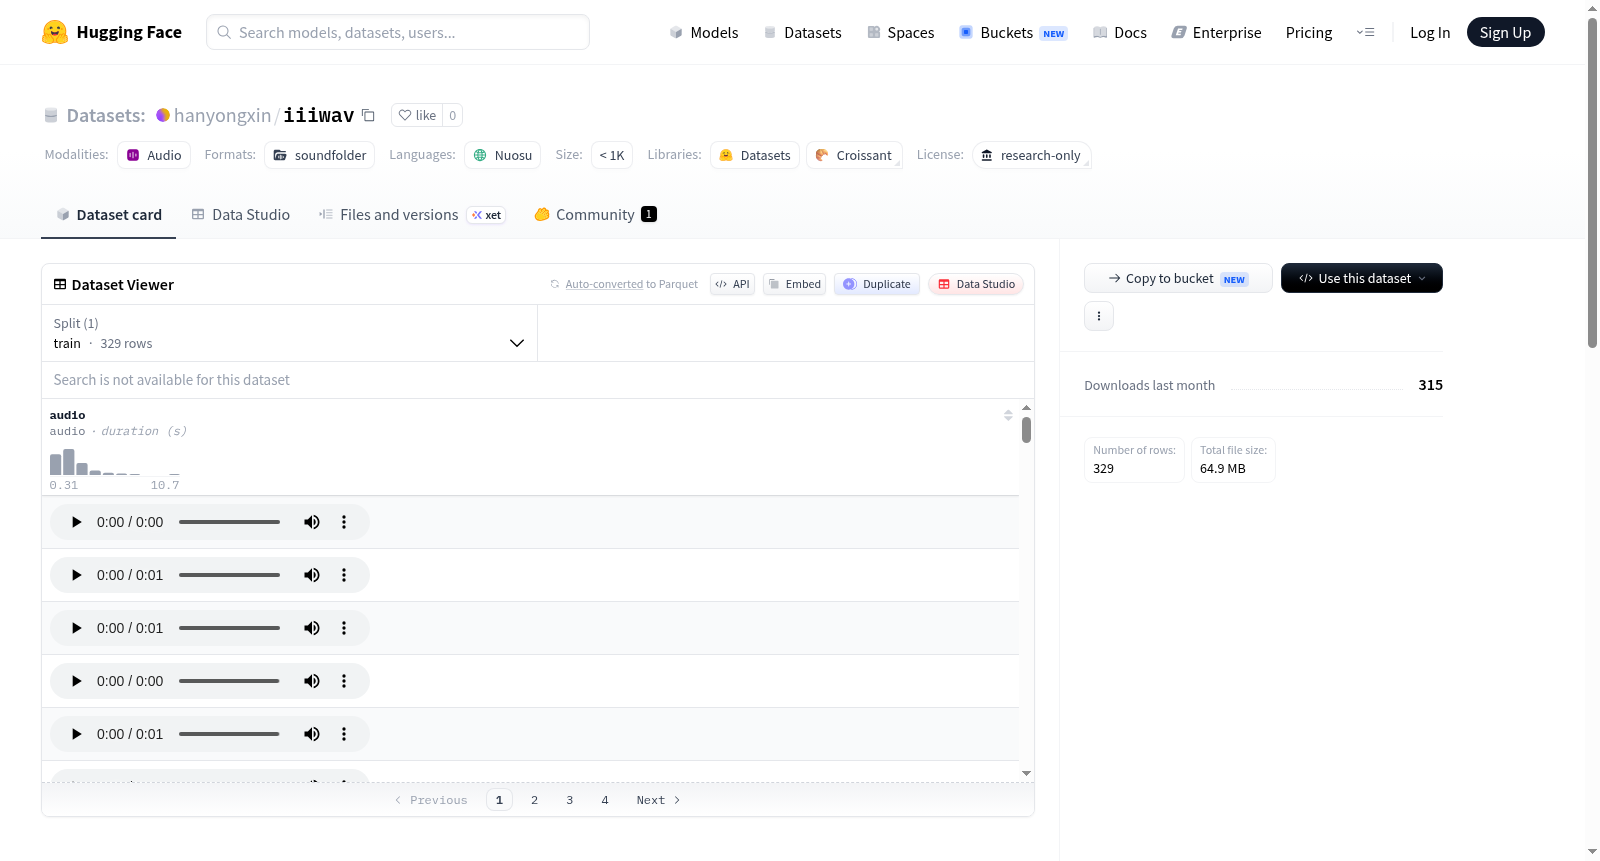
该数据集是从RFLR Bible项目发布的音频材料中衍生而来的,专门用于语音技术研究。它包含诺苏彝语(Nuosu Yi)的音频和文本数据,其中音频经过处理,被分割成短片段并转换为16 kHz单声道16位PCM WAV格式,文本转录使用拉丁字母罗马化表示,而不是原始彝文。数据集适用于文本到语音(TTS)、自动语音识别(ASR)及相关语言技术应用的非商业研究目的。
This dataset is derived from audio materials published by the RFLR Bible project, designed for speech technology research. It includes audio and text data in Nuosu Yi language, where the audio has been processed into shorter segments and converted to 16 kHz mono 16-bit PCM WAV format, and the text transcriptions are aligned using a Latin-script romanization instead of the original script. The dataset is intended for non-commercial research purposes such as text-to-speech (TTS), automatic speech recognition (ASR), and related language technology applications.
提供机构:
hanyongxin搜集汇总
数据集介绍
构建方式
iiiwav数据集源于RFLR Bible项目公开发布的音频材料,原始语料为凉山彝语(Nuosu)的有声圣经录音。构建过程主要包括:将长录音切分为短音频片段,统一转换为16kHz采样率、单声道、16位PCM WAV格式,并基于拉丁转写而非传统彝文生成对齐的文本转录,最终以结构化形式整合,服务于语音合成(TTS)与自动语音识别(ASR)等研究。
特点
该数据集聚焦于低资源语言凉山彝语的语音研究,具有鲜明的非商业与学术导向。其特色在于采用拉丁转写文本,降低了跨语言处理的壁垒;同时通过音频标准化与段落切分,提升了数据在模型训练中的可用性。数据集明确限定于研究、教育与公益目的,禁止任何商业用途,尊重原始版权方的权益。
使用方法
用户可直接从HuggingFace下载iiiwav数据集,适用于构建语音合成与识别系统的训练与评估。使用时应遵循非商业许可协议,仅用于学术研究或教育场景。推荐结合开源工具如Kaldi、Espnet或HuggingFace Transformers进行模型开发,加载数据时需注意音频文件为16kHz单声道WAV格式,并配合提供的拉丁转写文本进行对齐训练。
背景与挑战
背景概述
iiiwav数据集是一个专注于彝语北部方言(诺苏彝语)的语音资源库,其创建源于对低资源语言语音技术研究的迫切需求。该数据集由研究机构基于RFLR Bible项目公开发布的音频材料加工而成,主要面向文本转语音(TTS)、自动语音识别(ASR)等语言技术应用。通过将原始长音频切分为短片段、统一转换为16kHz单声道16位PCM WAV格式,并使用拉丁化转写方案替代传统彝文进行文本对齐,iiiwav为彝语的数字化研究提供了标准化基础。作为极少数公开可用的彝语语音数据集,它在推动少数民族语言语音处理技术发展、弥合语言数字鸿沟方面具有重要价值。
当前挑战
数据集面临的核心挑战之一在于解决低资源语言语音技术研究的共性难题:彝语作为声调语言,其声学特征刻画需要精细的标注和质量控制,然而现有音频来源单一、说话人数量有限,限制了模型的泛化能力。此外,构建过程中需克服多重困难:原始音频来自宗教典籍录音,内容分布集中于特定领域,缺乏日常口语样本;转写采用拉丁化方案而非传统彝文,与原生文字系统存在歧义风险;音频分割和对齐依赖自动工具,可能引入时间戳误差。由于数据集仅限非商业研究用途,也制约了其在工业界的广泛应用与持续改进。
常用场景
经典使用场景
在低资源语言语音技术研究领域,iiiwav数据集为彝语(Nuosu Yi)的语音合成与识别任务提供了宝贵的资源。该数据集将源自RFLR Bible项目的公开音频材料,经过精细分割、标准化转码(16 kHz、单声道、16-bit PCM WAV)以及拉丁转写文本对齐,构建成适用于文本转语音(TTS)和自动语音识别(ASR)的标准语料库。研究者可将其用于训练端到端语音合成模型,提升少数民族语言的语音生成质量,或作为声学模型训练的基础,探索跨语言迁移学习方法。
实际应用
iiiwav数据集的实际应用集中在教育和技术辅助领域。借助该数据集训练的TTS系统可生成彝语语音,用于语言学习应用、数字有声读物或听力障碍辅助工具,助力濒危语言的日常传承。基于ASR模型的开发可以支持彝语的语音输入与交互,在智能设备或公共服务场景中实现方言语音命令识别,例如语音翻译终端或文化展览的自动导览。此外,该数据集的非商业许可性质确保了其在学术研究与公益项目中的广泛使用,避免了商业滥用的风险。
衍生相关工作
iiiwav数据集的出现激励了一系列针对彝语及邻近语言的语音技术前沿工作。研究者以其为基础,开发了基于注意力机制的序列到序列TTS模型,并对比了不同音素表示的合成效果;在ASR领域,衍生出结合预训练语音表示(如wav2vec 2.0)的微调策略,显著提升了低资源识别准确率。此外,该数据集常被用作跨语言语音识别中的目标域数据,驱动了无监督领域自适应与多任务学习框架的改进,为更广泛的西南少数民族语言语音处理奠定了方法论基础。
以上内容由遇见数据集搜集并总结生成


