mcp-registry
收藏资源简介:
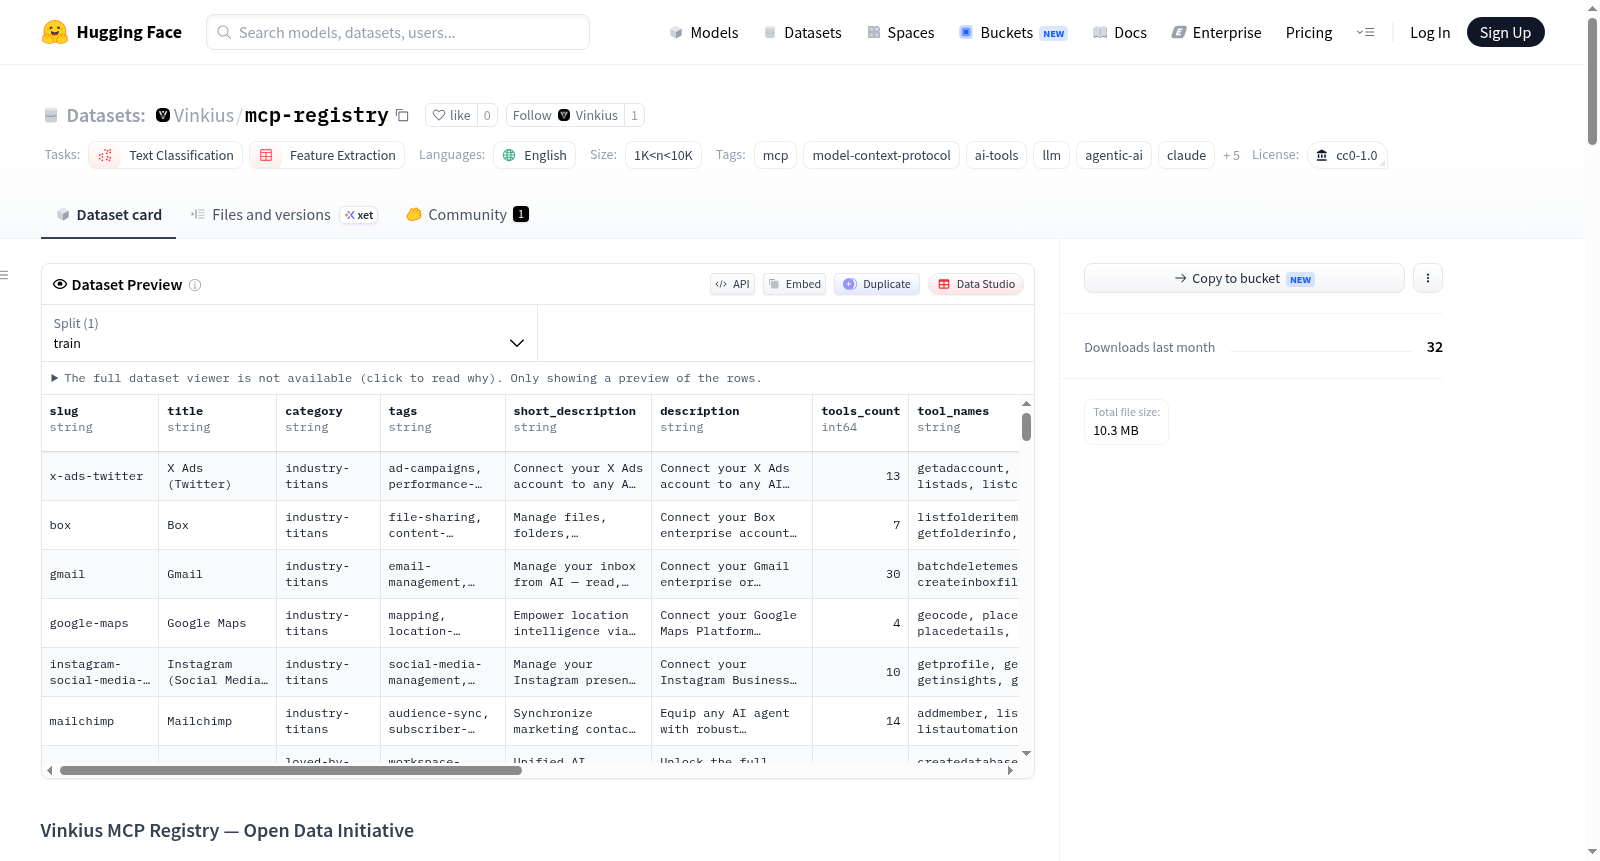
Vinkius MCP Registry数据集是Vinkius开放数据计划的一部分,提供了对Vinkius模型上下文协议(MCP)目录的访问。该数据集包含5,127个以上独特的VCP服务器记录,每12小时自动同步更新,确保数据的最新性。数据以UTF-8编码的CSV文件格式提供,包含13个结构化字段,如唯一服务器标识符(slug)、显示标题、主要分类、描述性标签、能力摘要、完整描述、工具数量、工具名称列表、真实使用提示示例、自动化质量等级(A+至F)、数值可靠性评分、创建时间戳和直接链接。该数据集专为AI研究人员、数据科学家和语言模型开发者设计,支持多种研究应用,包括LLM微调(用于高级函数调用和工具使用的真实模式)、代理框架研究(多代理编排和系统桥接的操作元数据)、语义分析(分析外部软件平台和企业系统如何映射到自然语言接口的大规模数据集)、多标签分类、推荐系统、异常检测、生态系统智能分析、提示工程研究、质量与可靠性分析以及市场与竞争研究。数据集采用CC0 1.0公共领域许可,允许商业和非商业用途,无需署名但鼓励引用。
The Vinkius MCP Registry dataset is part of the Vinkius Open Data Initiative, providing access to the Vinkius Model Context Protocol (MCP) directory. It contains over 5,127 unique VCP server records, automatically synchronized and updated every 12 hours to ensure data freshness. The data is provided in UTF-8 encoded CSV format with 13 structured fields, including unique server identifier (slug), display title, primary category, descriptive tags, capability summary, full description, number of tools, list of tool names, real-world usage prompt examples, automated quality grade (A+ to F), numerical reliability score, creation timestamp, and direct link. Designed for AI researchers, data scientists, and language model developers, it supports various research applications such as LLM fine-tuning (for real patterns in advanced function calling and tool usage), agent framework research (operational metadata for multi-agent orchestration and system bridging), semantic analysis (large-scale dataset for analyzing how external software platforms and enterprise systems map to natural language interfaces), multi-label classification, recommendation systems, anomaly detection, ecosystem intelligence analysis, prompt engineering research, quality and reliability analysis, and market and competition research. The dataset is licensed under CC0 1.0 Public Domain Dedication, allowing both commercial and non-commercial use without attribution, though citation is encouraged.
数据集概述
- 数据集名称: Vinkius MCP Registry — Open Data Initiative
- 数据集语言: 英语 (en)
- 许可证: CC0 1.0 (公有领域)
- 规模: 5,141+ 条记录,文件大小在 1K 到 10K 之间
数据集内容
- 数据来源: 从 Vinkius 平台自动提取
- 更新频率: 每 12 小时自动同步一次
- 文件格式: CSV (UTF-8 编码),文件名为
vinkius_mcp_servers.csv - 数据字段:
| 列名 | 类型 | 描述 |
|---|---|---|
| slug | string | 唯一的服务器标识符 |
| title | string | 服务器显示名称 |
| category | string | 主要分类(如 Development, Data Analytics, Communication 等) |
| tags | string | 逗号分隔的描述性关键词 |
| short_description | string | 单行能力摘要 |
| description | string | 完整的功能和集成细节 |
| tools_count | integer | 该服务器暴露的工具数量 |
| tool_names | string | 逗号分隔的工具名称列表 |
| prompt_examples | string | 针对该服务器的真实使用提示示例 |
| debugger_grade | string | 自动化的质量等级(A+ 到 F) |
| debugger_score | float | Vinkius Debugger 给出的数值可靠性评分 |
| created_at | datetime | 列表创建时间戳 |
| url | string | 指向 Vinkius 目录中 MCP 服务器页面的直接链接 |
数据用途
该数据集适用于以下研究和应用领域:
- LLM 微调: 提供真实世界的模式,用于训练模型掌握高级函数调用和工具使用
- Agent 框架: 提供操作元数据,用于研究多智能体编排和系统桥接
- 语义分析: 为分析外部软件平台和企业系统如何映射到自然语言接口提供大规模语料
- 生态系统情报: 追踪 MCP 服务器类别的增长轨迹,识别扩展最快的工具类型
- 提示工程: 分析
prompt_examples,研究针对不同 LLM 集成的工具使用指令设计 - 质量与可靠性分析: 探索
debugger_grade和debugger_score的分布,识别高质量与低维护服务器的模式 - 机器学习:
- 多标签分类:基于
description预测category或tags - 推荐系统:基于标签相似性、嵌入距离或协同过滤构建工具推荐器
- 异常检测:在不同快照间标记异常评分模式或等级突变的服务器
- 多标签分类:基于
- 市场与竞争研究: 追踪新服务器注册速率,作为 MCP 生态系统采用的指标;按行业垂直领域对标服务器类别
引用信息
bibtex @dataset{vinkius_mcp_registry, title = {Vinkius MCP Registry — Global Model Context Protocol Dataset}, author = {Vinkius}, year = {2026}, url = {https://huggingface.co/datasets/Vinkius/mcp-registry}, note = {Updated every 12 hours. 5,141+ MCP servers indexed.} }
其他信息
- 数据完整性:每次快照保证唯一
slug - 数据验证:每次上传前执行最小阈值验证
- 任务类型:文本分类 (text-classification)、特征提取 (feature-extraction)
- 标签:mcp, model-context-protocol, ai-tools, llm, agentic-ai, claude, chatgpt, copilot, prompt-engineering, ai-infrastructure, developer-tools