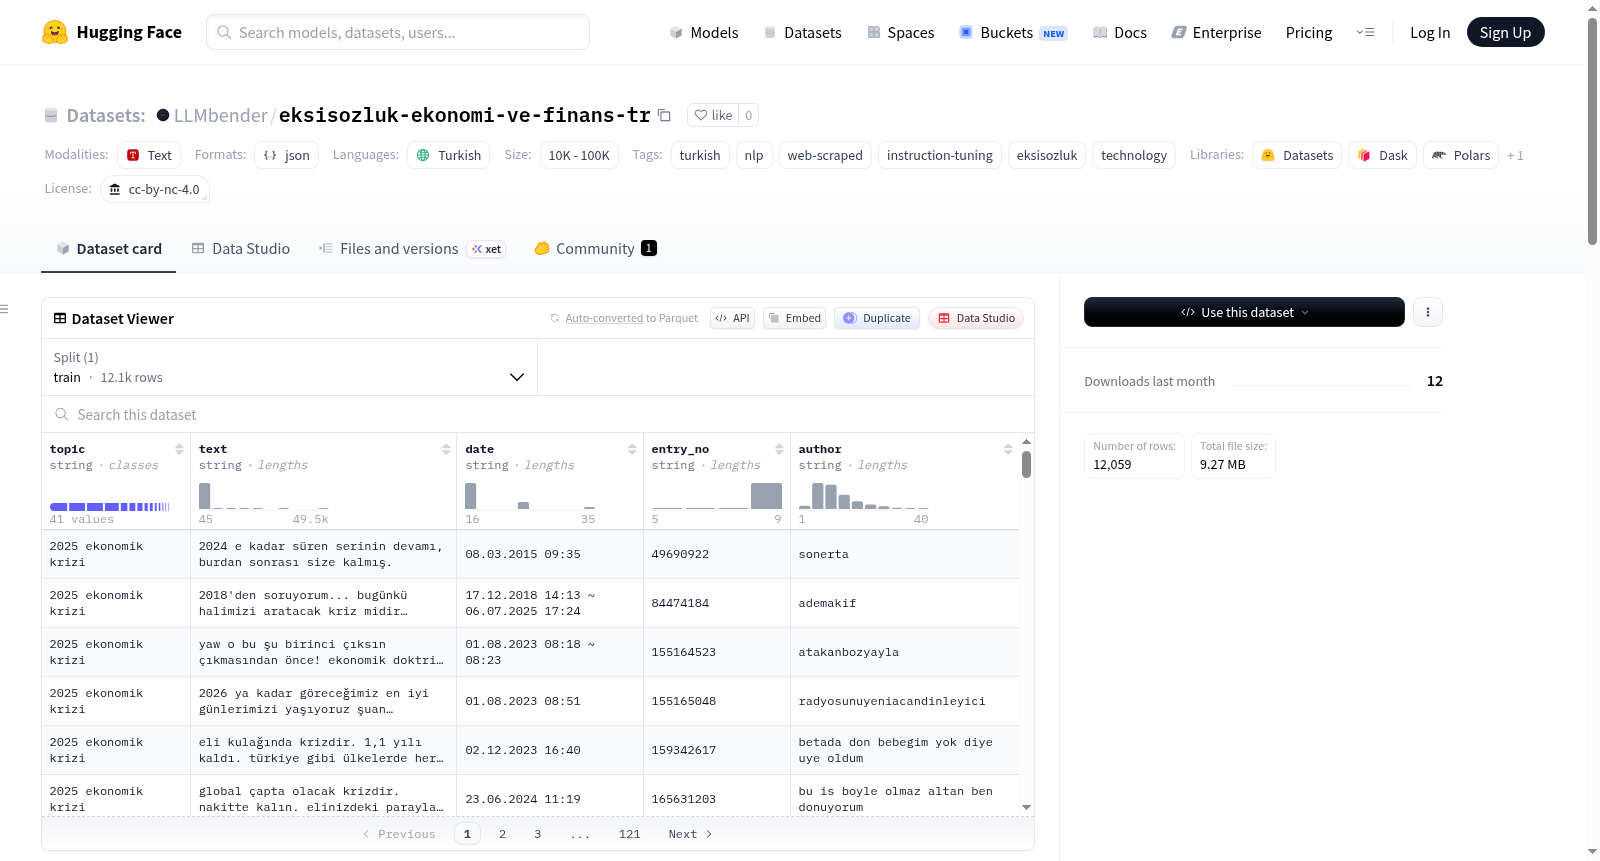
eksisozluk-ekonomi-ve-finans-tr
收藏资源简介:
Ekşi Sözlük Türkçe Teknoloji Dataset是一个从土耳其平台Ekşi Sözlük的技术类别用户条目中收集的数据集,专为土耳其语自然语言处理(NLP)研究和大型语言模型(LLM)训练而设计。数据集包含39个不同主题的条目,涵盖宏观经济概念、投资工具、加密货币以及当前经济发展等内容。每个条目以JSONL格式存储,包含主题、文本内容、作者昵称、日期和唯一条目ID等字段。原始数据经过清理,移除了引用标记、URL,并过滤了少于10个单词的条目。该数据集适用于土耳其语LLM的预训练和微调、情感分析、日常土耳其语口语研究以及社交媒体文本分析等场景。数据集采用CC BY-NC 4.0许可,允许在非商业用途下使用,但需注明来源。
The Ekşi Sözlük Türkçe Teknoloji Dataset is a collection of user entries from the technology category of the Turkish platform Ekşi Sözlük, designed specifically for Turkish natural language processing (NLP) research and large language model (LLM) training. The dataset includes entries on 39 different topics, covering macroeconomic concepts, investment tools, cryptocurrencies, and current economic developments. Each entry is stored in JSONL format and contains fields such as topic, text content, author nickname, date, and unique entry ID. The raw data has been cleaned by removing quotation marks, URLs, and filtering out entries with fewer than 10 words. This dataset is suitable for pre-training and fine-tuning Turkish LLMs, sentiment analysis, research on everyday Turkish colloquial language, and social media text analysis. The dataset is licensed under CC BY-NC 4.0, allowing use for non-commercial purposes with attribution required.
数据集概述
数据集名称:Ekşi Sözlük Türkçe Teknoloji Dataset
基本信息
- 语言:土耳其语 (tr)
- 许可证:CC BY-NC 4.0(非商业用途,需注明出处)
- 数据集规模:10,000 < N < 100,000 条记录
- 标签:turkish, nlp, web-scraped, instruction-tuning, eksisozluk, technology
数据来源
该数据集来源于土耳其知名平台 Ekşi Sözlük 的“科技”类别,收录了用户撰写的土耳其语条目(entry)。
数据内容
数据集涵盖 39 个不同的标题,涉及以下六大主题领域:
| 领域 | 涵盖标题示例 |
|---|---|
| 经济危机与总体状况 | 2025-2026 经济危机、货币贬值、通胀税、最低工资 |
| 宏观经济概念 | 通货膨胀、利率、美元、经济衰退、滞胀、通缩性衰退 |
| 投资工具 | 黄金、定期存款、投资基金、房地产、股票市场 |
| 加密货币 | 比特币、加密货币交易所、加密货币税 |
| 比较与分析 | 黄金 vs 美元、比特币 vs 黄金、加息分析 |
| 教育与概念解释 | 经济学 101、简易经济学、实例讲解经济学 |
数据格式
数据集采用 JSONL 格式,每条记录包含以下字段:
| 字段 | 说明 |
|---|---|
topic |
条目所属的标题名称 |
text |
经过清洗的条目文本内容 |
author |
用户昵称 |
date |
条目发布的时间(格式:dd.mm.yyyy hh:mm) |
entry_no |
在 Ekşi Sözlük 上的唯一条目 ID |
数据清洗
对原始数据进行了以下预处理:
- 移除了
(bkz: ...)形式的内部引用 - 清除了所有 URL 链接
- 过滤掉长度少于 10 个单词的条目
- 对多余空格进行了归一化处理
潜在应用场景
- 土耳其语大语言模型(LLM)的预训练与微调
- 土耳其语语言模型的评估
- 情感分析
- 日常土耳其语口语研究
- 社交媒体文本分析