
OpenLLMTurkishLeadboardv2/details_sambanovasystems__SambaLingo-Turkish-Chat
收藏数据链接:
官方服务:
资源简介:
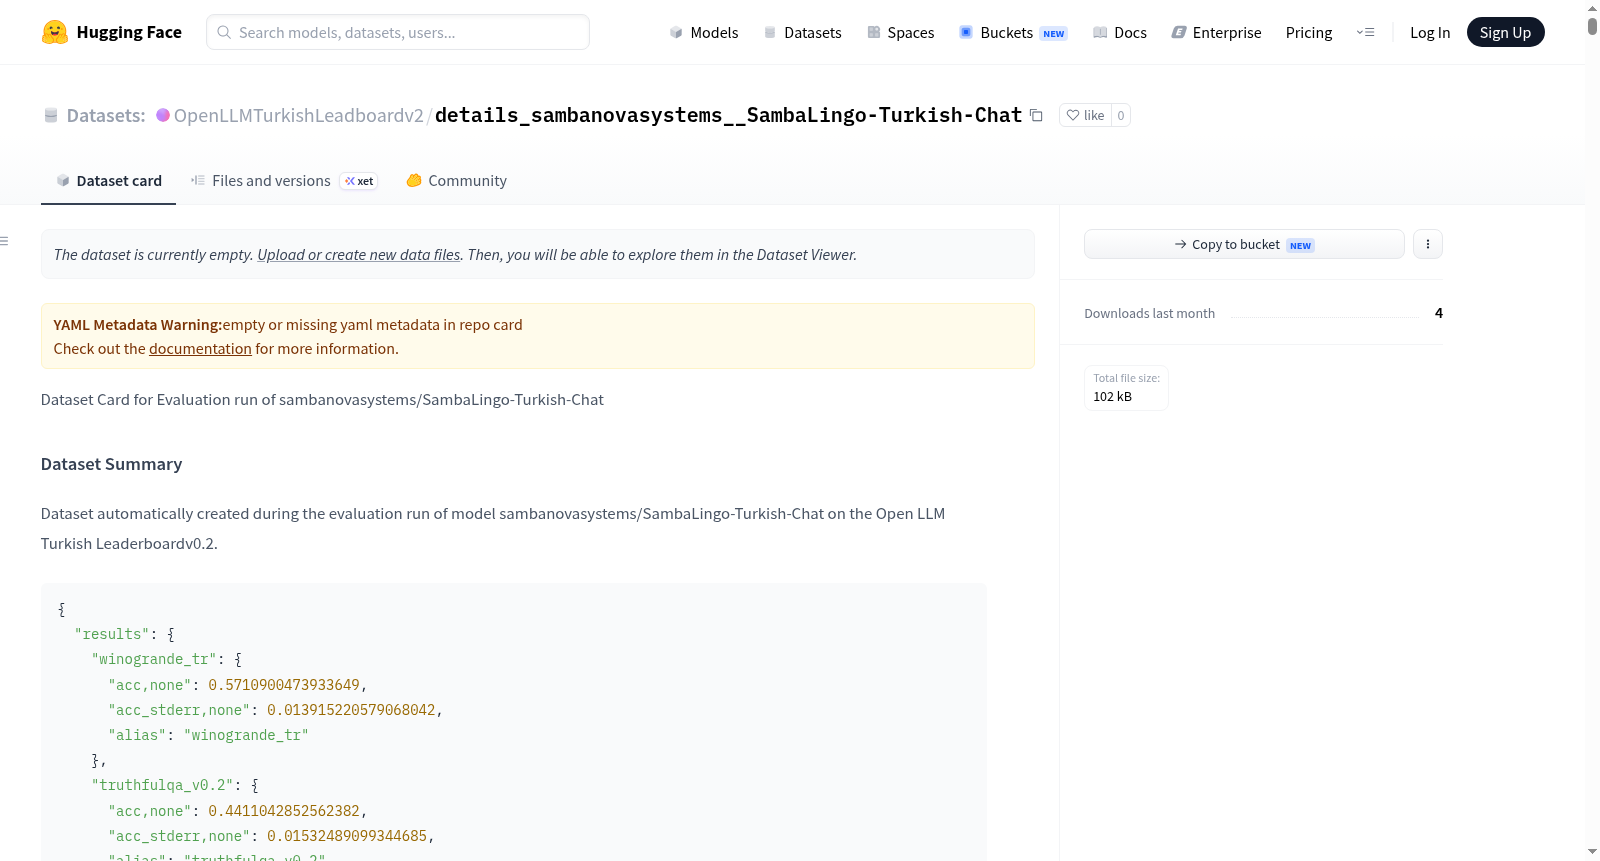
该数据集是在Open LLM Turkish Leaderboardv0.2上对模型sambanovasystems/SambaLingo-Turkish-Chat进行评估时自动创建的。数据集包含了多个任务的评估结果,如winogrande_tr、truthfulqa_v0.2、mmlu_tr_v0.2等,每个任务都有对应的准确率和标准误差。此外,还提供了每个任务的配置信息,如任务名称、数据集路径、测试分割、fewshot分割等。
该数据集是在Open LLM Turkish Leaderboardv0.2上对模型sambanovasystems/SambaLingo-Turkish-Chat进行评估时自动创建的。数据集包含了多个任务的评估结果,如winogrande_tr、truthfulqa_v0.2、mmlu_tr_v0.2等,每个任务都有对应的准确率和标准误差。此外,还提供了每个任务的配置信息,如任务名称、数据集路径、测试分割、fewshot分割等。
原始信息汇总
数据集概述
数据集名称
sambanovasystems/SambaLingo-Turkish-Chat
数据集创建目的
该数据集是在评估模型sambanovasystems/SambaLingo-Turkish-Chat在Open LLM Turkish Leaderboard v0.2上的运行过程中自动创建的。
数据集内容
数据集包含了多个子任务的评估结果,具体包括:
评估结果
- winogrande_tr: 准确率0.5710900473933649,标准误差0.013915220579068042。
- truthfulqa_v0.2: 准确率0.4411042852562382,标准误差0.01532489099344685。
- mmlu_tr_v0.2: 准确率0.38349478665976483,标准误差0.004114447438213186。
- mmlu_humanities_v0.2: 准确率0.3630152584832612,标准误差0.007116099400155428。
- mmlu_formal_logic_v0.2: 准确率0.25396825396825395,标准误差0.038932596106046734。
- mmlu_high_school_european_history_v0.2: 准确率0.48,标准误差0.04092881363092387。
- mmlu_high_school_us_history_v0.2: 准确率0.4860335195530726,标准误差0.03746196103854561。
- mmlu_high_school_world_history_v0.2: 准确率0.4647887323943662,标准误差0.034254883044942085。
- mmlu_international_law_v0.2: 准确率0.4793388429752066,标准误差0.04560456086387235。
- mmlu_jurisprudence_v0.2: 准确率0.3867924528301887,标准误差0.04752784159123843。
- mmlu_logical_fallacies_v0.2: 准确率0.4472049689440994,标准误差0.0393074964777559。
- mmlu_moral_disputes_v0.2: 准确率0.4318181818181818,标准误差0.028269943504782357。
- mmlu_moral_scenarios_v0.2: 准确率0.2305045871559633,标准误差0.014270320474599791。
- mmlu_philosophy_v0.2: 准确率0.45819397993311034,标准误差0.0288628006965287。
- mmlu_prehistory_v0.2: 准确率0.44,标准误差0.02870679828121781。
- mmlu_professional_law_v0.2: 准确率0.31484149855907784,标准误差0.012471057462008842。
- mmlu_world_religions_v0.2: 准确率0.5535714285714286,标准误差0.03846844122529909。
- mmlu_other_v0.2: 准确率0.4216987392169874,标准误差0.008882546846716336。
- mmlu_business_ethics_v0.2: 准确率0.45454545454545453,标准误差0.05029848501568074。
- mmlu_clinical_knowledge_v0.2: 准确率0.359375,标准误差0.0300473227657999。
- mmlu_college_medicine_v0.2: 准确率0.32142857142857145,标准误差0.036139470758360125。
- mmlu_global_facts_v0.2: 准确率0.3877551020408163,标准误差0.04947154580307444。
- mmlu_human_aging_v0.2: 准确率0.44339622641509435,标准误差0.03420013669327394。
- mmlu_management_v0.2: 准确率0.5252525252525253,标准误差0.05044316967661916。
- mmlu_marketing_v0.2: 准确率0.45161290322580644,标准误差0.03386101008546805。
- mmlu_medical_genetics_v0.2: 准确率0.4,标准误差0.050529115263991134。
- mmlu_miscellaneous_v0.2: 准确率0.5195822454308094,标准误差0.018063668648722265。
- mmlu_nutrition_v0.2: 准确率0.4426229508196721,标准误差0.028487524637258586。
- mmlu_professional_accounting_v0.2: 准确率0.2724014336917563,标准误差0.026701042243449。
- mmlu_professional_medicine_v0.2: 准确率0.4099616858237548,标准误差0.030501771826233565。
- mmlu_virology_v0.2: 准确率0.27672955974842767,标准误差0.03559177035707934。
- mmlu_social_sciences_v0.2: 准确率0.4329004329004329,标准误差0.008935072686826586。
- mmlu_econometrics_v0.2: 准确率0.22807017543859648,标准误差0.03947152782669415。
- mmlu_high_school_geography_v0.2: 准确率0.5329949238578681,标准误差0.03563643908718085。
- mmlu_high_school_government_and_politics_v0.2: 准确率0.41711229946524064,标准误差0.03615450931140827。
- mmlu_high_school_macroeconomics_v0.2: 准确率0.37435897435897436,标准误差0.024537591572830513。
- mmlu_high_school_microeconomics_v0.2: 准确率0.38396624472573837,标准误差0.031658678064106674。
- mmlu_high_school_psychology_v0.2: 准确率0.5103189493433395,标准误差0.02167313222192666。
- mmlu_human_sexuality_v0.2: 准确率0.5043478260869565,标准误差0.04682752006203915。
- mmlu_professional_psychology_v0.2: 准确率0.36363636363636365,标准误差0.019754178957957502。
- mmlu_public_relations_v0.2: 准确率0.4074074074074074,标准误差0.04750077341199984。
- mmlu_security_studies_v0.2: 准确率0.43162393162393164,标准误差0.0324483553531149。
- mmlu_sociology_v0.2: 准确率0.5282051282051282,标准误差0.03584074674920833。
- mmlu_us_foreign_policy_v0.2: 准确率0.6060606060606061,标准误差0.04935824351078519。
- mmlu_stem_v0.2: 准确率0.32776886035313,标准误差0.008388076621340895。
- mmlu_abstract_algebra_v0.2: 准确率0.3,标准误差0.046056618647183814。
- mmlu_anatomy_v0.2: 准确率0.4580152671755725,标准误差0.04369802690578757。
- mmlu_astronomy: 准确率0.36423841059602646,标准误差0.03929111781242742。
- mmlu_college_biology_v0.2: 准确率0.352112676056338,标准误差0.04022360721546471。
- mmlu_college_chemistry_v0.2: 准确率0.30303030303030304,标准误差0.04642339954443118。
- mmlu_college_computer_science_v0.2: 准确率0.3434343434343434,标准误差0.047967590587574785。
- mmlu_college_mathematics_v0.2: 准确率0.29,标准误差0.045604802157206845。
- mmlu_college_physics_v0.2: 准确率0.26732673267326734,标准误差0.044256428987380234。
- mmlu_computer_security_v0.2: 准确率0.41,标准误差0.049431107042371025。
- mmlu_conceptual_physics_v0.2: 准确率0.30042918454935624,标准误差0.030098365291012556。
- mmlu_electrical_engineering_v0.2: 准确率0.3402777777777778,标准误差0.039621355734862175。
- mmlu_elementary_mathematics_v0.2: 准确率0.2949061662198391,标准误差0.023642528164837848。
- mmlu_high_school_biology_v0.2: 准确率0.4066666666666667,标准误差0.028407503418366627。
- mmlu_high_school_chemistry_v0.2: 准确率0.30456852791878175,标准误差0.03287317463855874。
- mmlu_high_school_computer_science_v0.2: 准确率0.35,标准误差0.0479372485441102。
- mmlu_high_school_mathematics_v0.2: 准确率0.3,标准误差0.027940457136228405。
- mmlu_high_school_physics_v0.2: 准确率0.2653061224489796,标准误差0.036538475108960564。
- mmlu_high_school_statistics_v0.2: 准确率0.32407407407407407,标准误差0.03191923445686186。
- mmlu_machine_learning_v0.2: 准确率0.25892857142857145,标准误差0.04157751539865629。
- hellaswag_tr-v0.2: 准确率0.4228294004742012,标准误差0.005249475159476288。
- gsm8k_tr-v0.2: 精确匹配率0.06150341685649203,精确匹配标准误差0.006622744874624762。
- **arc_tr
搜集汇总
数据集介绍
构建方式
该数据集是在对sambanovasystems/SambaLingo-Turkish-Chat模型进行土耳其语能力评估过程中自动生成的。依托Open LLM Turkish Leaderboard v0.2评测框架,整合了涵盖多学科知识的土耳其语基准测试集,包括ARC、GSM8K、HellaSwag、MMLU及其子任务、TruthfulQA和Winogrande等。每个评测任务均配置了明确的提示模板、评估指标与数据拆分,确保了评估过程的一致性与可复现性。
特点
数据集以结构化的JSON格式呈现,详尽记录了模型在各类土耳其语任务上的表现,包括准确率及其标准误差。其显著特点在于细粒度的评测体系,不仅提供整体得分,更将MMLU细分为人文学科、社会科学、STEM等领域及数十个子任务,能够全面揭示模型在不同知识维度的能力差异。同时,数据集涵盖了常识推理、数学问题求解、语言理解等多种任务类型,为模型性能的深入剖析提供了丰富维度。
使用方法
该数据集可直接作为模型评估结果的参考基准,适用于分析SambaLingo-Turkish-Chat在土耳其语上的综合表现。研究人员可通过解析JSON结果中的各项指标,对比模型在不同子任务上的准确率与标准误差,从而定位其优势与短板。数据集中的配置信息(如提示模板、few-shot样本数)亦可复用于其他模型的土耳其语评测,或作为构建新评估流程的模板。
背景与挑战
背景概述
随着大规模语言模型在多语言场景下的广泛应用,针对非英语语言模型的系统化评估需求日益凸显。OpenLLMTurkishLeadboardv2 作为一项专注于土耳其语大语言模型性能评测的基准平台,由国际研究社区联合构建,旨在填补土耳其语自然语言处理领域缺乏标准化评估体系的空白。该数据集自动生成于对 sambanovasystems/SambaLingo-Turkish-Chat 模型的评测过程中,整合了涵盖常识推理、数学问题求解、多学科知识问答等维度的多项子任务,如 Winogrande、TruthfulQA、MMLU 及 GSM8K 的土耳其语版本。通过提供细粒度的性能指标与标准化评测流程,该数据集为土耳其语模型的能力比较与迭代优化奠定了坚实基础,推动了低资源语言自然语言处理研究的发展。
当前挑战
当前数据集面临的核心挑战在于多维度评测任务的严峻性。首先,土耳其语作为形态丰富、语序灵活的语言,在常识推理任务(如 Winogrande)和数学推理任务(如 GSM8K)上表现显著低于英语基线,模型在精确匹配任务中的准确率仅约 6%,暴露了其在复杂逻辑与计算能力上的不足。其次,数据集构建过程中,需要对原始英文评测集进行高质量翻译与本地化适配,涉及文化概念对齐、歧义消解与领域术语映射等难题,而自动生成方式可能引入噪声或偏差。此外,MMLU 子任务在人文、社科、STEM 等领域的细粒度表现差异巨大,模型在形式逻辑、计量经济学等子任务上准确率不足 30%,凸显了跨学科知识泛化的瓶颈。这些挑战共同制约了土耳其语大语言模型的全面能力评估与提升。
常用场景
经典使用场景
OpenLLMTurkishLeadboardv2数据集作为土耳其语大语言模型评估的标准化基准,其经典使用场景聚焦于多维度能力诊断。该数据集整合了Winogrande_TR(共指消解)、TruthfulQA(真实性判别)、MMLU_TR(多学科知识)等子任务,覆盖常识推理、事实准确性、STEM与人文社科等关键领域。研究者通过模型在此榜单上的表现,能够系统性地剖析其在土耳其语语境下的语言理解深度与知识覆盖面,尤其适用于对比不同预训练策略或微调方法对低资源语言模型性能的增益效果。
衍生相关工作
围绕该数据集已衍生出一系列标志性工作,包括SambaLingo-Turkish-Chat等模型的针对性优化与榜单提交。研究者基于其细粒度结果,提出了领域自适应微调(如针对MMLU_TR中法律与医学子项的低分强化)与对抗性数据增强策略。此外,该评估框架启发了阿拉伯语、印地语等低资源语言的类似榜单构建,形成了跨语言模型能力对比的连锁效应。后续工作还探索了将子任务难度权重引入综合评分,以更贴合实际部署中的性能需求。
数据集最近研究
最新研究方向
当前,面向低资源语言的大语言模型评测体系正经历深刻变革。OpenLLMTurkishLeadboardv2 作为专为土耳其语构建的标准化评估平台,其核心价值在于系统性地检验多语言模型在非英语语境下的真实能力。该榜单通过引入土耳其语版的 MMLU、HellaSwag、ARC 和 GSM8K 等经典基准测试,涵盖从人文社科到 STEM 领域的多维度知识推理任务,精准刻画了模型在逻辑推理、常识判断与数学求解等前沿方向的表现。这一评测框架的建立,不仅为土耳其语自然语言处理研究提供了可复现的对照基准,更推动了多语言 AI 模型向更广泛语言社区普惠化发展的进程,其影响力正随全球多语言大模型竞赛的升温而日益凸显。
以上内容由遇见数据集搜集并总结生成


