
TEPE-TCI-370h
收藏资源简介:
TEPE-TCI-370h是由香港中文大学·深圳联合国防科技大学构建的首个中国幼儿园自然师生互动大规模数据集,包含105个班级370小时的课堂录音。数据通过专业设备采集,覆盖集体活动、自由游戏等多元场景,并采用ECQRS-EC和SSTEW标准进行专家标注,包含206个教学质量指标。该数据集专为AI辅助教育评估设计,通过解决儿童语音识别、普通话同音歧义等挑战,支持从音频中自动提取结构化质量指标,可显著提升学前教育质量监测效率,推动从年度人工评估向持续AI辅助监测的范式转变。
TEPE-TCI-370h is the first large-scale dataset of natural teacher-student interactions in Chinese kindergartens, jointly developed by The Chinese University of Hong Kong, Shenzhen and the National University of Defense Technology. It contains 370 hours of classroom audio recordings from 105 classes. The data was collected with professional-grade equipment, covering diverse scenarios including group activities and free play. It was expertly annotated in accordance with the ECQRS-EC and SSTEW standards, and includes 206 teaching quality indicators. This dataset is specifically designed for AI-assisted education assessment. By addressing challenges such as children's speech recognition and Mandarin homonym ambiguity, it supports the automatic extraction of structured quality indicators from audio. It can significantly improve the efficiency of preschool education quality monitoring, and promote the paradigm shift from annual manual assessment to continuous AI-assisted monitoring.
数据集概述:TEPE-TCI-370h
数据集基本信息
- 数据集名称:TEPE-TCI-370h
- 所属研究:When AI Meets Early Childhood Education: Large Language Models as Assessment Teammates in Chinese Preschools
- 发表会议:27th International Conference on Artificial Intelligence in Education (AIED 2026)
- 数据集定位:首个中国学龄前自然情境下师幼互动的大规模语料库,带有专家级别的标准化标注。
数据集规模与构成
- 音频时长:370+ 小时
- 覆盖范围:来自中国41所公立幼儿园(涵盖区级、市级、省级不同质量等级)的105个教室。
- 儿童年龄:3–4岁。
- 采集场景:涵盖集体活动、自由游戏、户外活动和日常环节中的自然音频。
- 说话人数量:2550名独立说话人。
- 语音片段分布:
- 教师语音:73.85%
- 学生语音:26.15%
- 说话人身份分布:
- 教师:45.09%
- 学生:54.91%
数据标注
- 标注工具:专业评估员(评分者间信度 κ > 0.80)。
- 标注量表:
- ECQRS-EC量表:包含22个项目,覆盖4个领域(读写、数学、科学、多样性)。
- SSTEW量表:包含15个项目。
- 标注粒度:在总计206个指标上进行指标级别的二元编码。
相关方法与框架
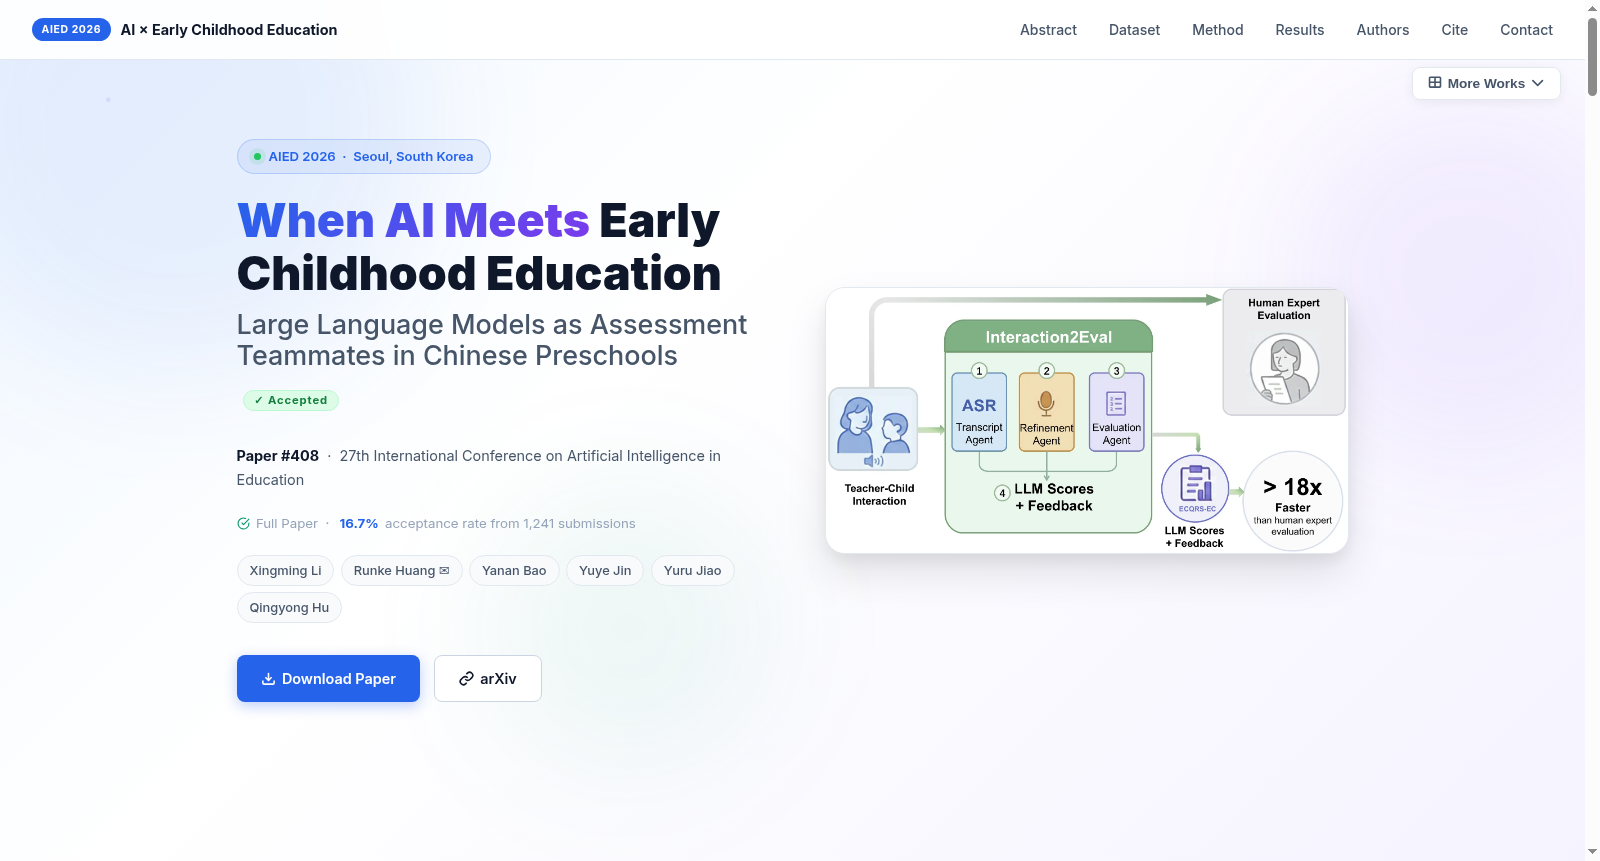
- 评估框架:Interaction2Eval
- 框架流程:一个基于大语言模型的三阶段流水线,将原始课堂音频转化为专家级别的质量评估。
- 转录智能体:使用FunASR Paraformer进行说话人日志和标点恢复,自动区分教师和学生语音。
- 精炼智能体:利用Qwen3-Max进行领域感知的错误纠正,针对普通话同音字和学前教育特定词汇。
- 评估智能体:应用基于量表的提示(SSTEW & ECQRS-EC),采用证据优先的推理:定位话语 → 判断指标存在性 → 用转录证据证明 → 生成反馈。
- 处理效率:处理一节3小时的课堂录音,人工专家需380分钟,Interaction2Eval框架仅需21分钟,效率提升18倍。
实验验证与效果
- 专家一致性:Interaction2Eval框架与人类专家评估的一致性最高达到88%。
- ASR质量提升:在包含16,168个参考字符的5小时测试集上评估。
- FunASR Paraformer:原始字符错误率(CER)为9.9%,精炼后降至4.3%,绝对降低5.6%,相对改进56.6%。
- Whisper-large v3:原始CER为35.1%,精炼后降至23.2%。
- 错误类型分析(初始ASR输出):同音字错误占51.67%,额外词语占20.80%,说话人识别错误占13.72%,标点错误占7.75%,遗漏占6.06%。
实际部署与影响
- 试点研究:在深圳3所公立幼儿园的43个教室中进行了为期4周的初步部署验证。
- 处理会话数:127次
- 成功率:96.8%
- 参与教师:77名
- 系统级影响:Interaction2Eval将每100个教室每月的专家工作量从633专家小时减少到35专家小时,使得从年度抽查审计转变为在人工定向监督下的、持续的月度AI辅助监测成为可能。
- 1When AI Meets Early Childhood Education: Large Language Models as Assessment Teammates in Chinese Preschools国防科技大学; 香港中文大学·深圳; 牛津大学 · 2026年


