tts-realspeech-sft-en-de
收藏资源简介:
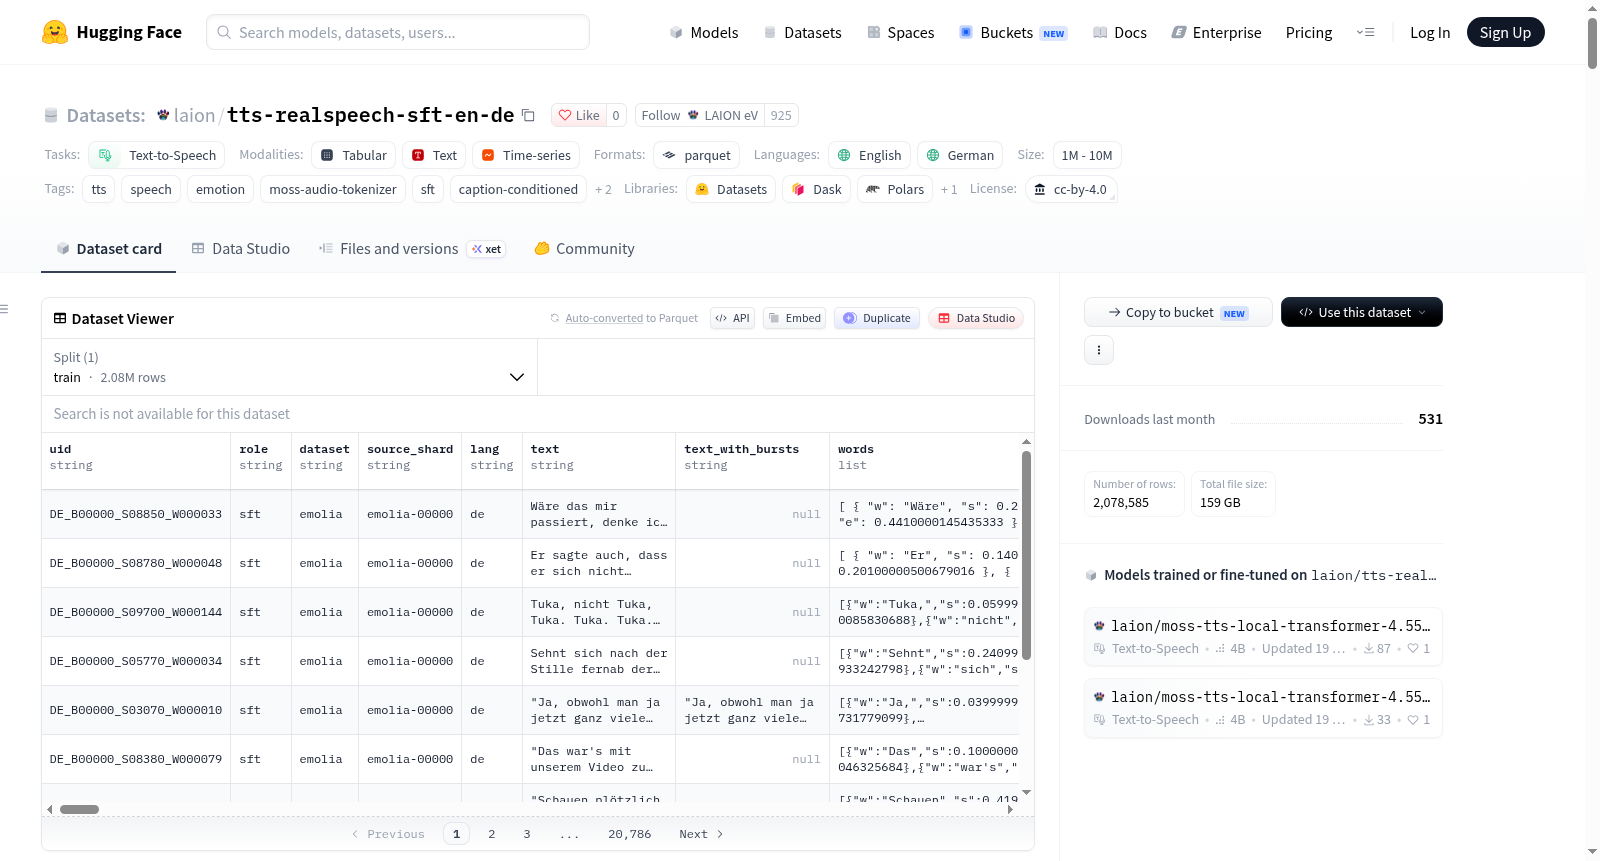
LAION TTS Real-Speech SFT(英文+德文,情感平衡)是一个用于文本到语音(TTS)训练的数据集,包含1,947,272条真实录音(非合成语音),总时长6,996小时,来自自由许可的语料库。数据集在40种情感×2种语言上实现了平衡,每种语言每种情感目标为25,000条。英文达到所有40个情感桶的目标,德文有6个情感桶因供应受限而未能达到。每条数据包含:程序化生成的标题(caption)、带有词级时间戳的转录文本(text)、原始音频、以及目标MOSS-Audio-Tokenizer-v2编码(moss_codes,形状为[T, 12]的uint16数组)。数据来源包括Emolia(CC-BY-4.0)、KartoffelPhon(CC-BY-4.0)和Multilingual LibriSpeech(德语部分,CC-BY-4.0);EuroSpeech因许可证问题被排除。数据集还提供了参考音频(ref_uid)用于条件生成,44.6%的行有参考。设计用于情感可控的TTS,配套有偏好数据集laion/tts-realspeech-dpo-en-de。数据列包括uid、role(sft或distractor)、lang、text、caption、emotion_bucket、sel_score、norm_gen、norm_blend、norm_emo、音频、MOSS编码、VoiceCLAP嵌入、speaker_key等。过滤条件包括:语言标签校正、强制对齐成功、时长3-30秒、至少5个词、10个字符、语言内去重等。情感桶选择基于三个条件:百分位≥90%、原始情感强度>1.0、且该情感是标题中列出的前三名之一。
LAION TTS Real-Speech SFT (English + German, Emotionally Balanced) is a dataset for text-to-speech (TTS) training, containing 1,947,272 real recordings (non-synthetic speech) totaling 6,996 hours from freely licensed corpora. The dataset is balanced across 40 emotions × 2 languages, with a target of 25,000 samples per language per emotion. English achieves the target for all 40 emotion buckets, while German falls short for 6 buckets due to limited supply. Each sample includes: procedurally generated caption, word-level timestamped transcription (text), raw audio, and target MOSS-Audio-Tokenizer-v2 codes (moss_codes, uint16 array of shape [T, 12]). Data sources include Emolia (CC-BY-4.0), KartoffelPhon (CC-BY-4.0), and Multilingual LibriSpeech (German part, CC-BY-4.0); EuroSpeech is excluded due to license issues. The dataset also provides reference audio (ref_uid) for conditional generation, with 44.6% of rows having a reference. It is designed for emotion-controllable TTS, accompanied by a preference dataset laion/tts-realspeech-dpo-en-de. Columns include uid, role (sft or distractor), lang, text, caption, emotion_bucket, sel_score, norm_gen, norm_blend, norm_emo, audio, MOSS codes, VoiceCLAP embeddings, speaker_key, etc. Filtering conditions include: language label correction, successful forced alignment, duration 3-30 seconds, at least 5 words, 10 characters, intra-language deduplication, etc. Emotion bucket selection is based on three conditions: percentile ≥ 90%, raw emotion intensity > 1.0, and the emotion is among the top three listed in the caption.
LAION TTS Real-Speech SFT (EN+DE, emotion-balanced) 数据集详情
基本信息
- 数据规模:1,947,272 条真实录音语音(非合成),总时长 6,996 小时,音频 token 数约 37.6 亿,对齐词数 79,337,527
- 语言:英语(999,999 条)、德语(947,273 条)
- 情感覆盖:40 种情感 × 2 种语言,目标每种情感每语言 25,000 条
- 许可证:CC-BY-4.0
- 任务类型:文本转语音(text-to-speech)
数据内容与结构
- 每行包含:程序化生成的描述性 caption、带词级时间戳的文本转录、原始音频、以及 MOSS-Audio-Tokenizer-v2 目标编码
role字段:sft(训练目标,1,947,272 条)与distractor(131,313 条短退化片段,用于 DPO 集合作幻觉延续捐赠材料),训练前必须按此过滤moss_codes:uint16 格式,形状为[T, 12],每帧 12 个 token,帧时长 80 ms
数据来源与许可审查
| 语料库 | 许可证 | 包含情况 |
|---|---|---|
| Emolia | CC-BY-4.0 | 英语 + 德语 |
| KartoffelPhon | CC-BY-4.0 | 德语(及少量英语) |
| Multilingual LibriSpeech | CC-BY-4.0 | 仅德语(27,438 条) |
| EuroSpeech | other(各国议会条款,非开放许可) |
已排除,损失约 820,274 条英语和 486,198 条德语语音 |
情感平衡情况
- 英语:40/40 情感桶全部达到 25,000 条
- 德语:34/40 情感桶达到目标;6 个情感桶供应受限(Pain、Sexual Lust、Infatuation、Pleasure Ecstasy、Shame、Embarrassment),其中 Pain 已完全耗尽(免费许可池中全部可用德语片段均已收录)
- 未使用弱片段填补缺口
选择机制
- 评分公式:
norm(genuineness) + norm(blend) + 2 * norm(emotion_strength)(所有项均为经验 CDF 百分位数) - 情感桶准入三条件:情感百分位数 ≥ 0.90、原始情感强度 > 1.0、该情感位于片段前 3 名
- 稀缺优先填充:按稀缺程度从高到低填充,避免稀有情感被其他情感竞争挤掉
- 已修复的两个缺陷:28 行重复
uid(删去重复副本);1 行emotion_bucket与 caption 不符(删除该行)
参考音频
- 868,583 个片段(44.6%)具有参考音频,来源包括 Emolia 同录音会话、MLS 同说话人、KartoffelPhon 说话人验证模型验证(余弦 ≥ 0.80)
- 无说话人姓名,
speaker_key为不透明分组 ID
其他说明
- Caption 修正:修复了极性反转和 1.0 绝对情感门控两个缺陷;每行包含全部数值输入(40 个
emo_*、114 个vn_*、4 个qual_*等),可在无 GPU 情况下重新生成文字描述 - 过滤规则:仅使用修正后的语言标签(原标签 471 万条错误)、强制对齐成功、时长 3-30 秒、≥5 词、≥10 字符、且去除各语言内完全重复的文本