genadz_pashkou_output
收藏资源简介:
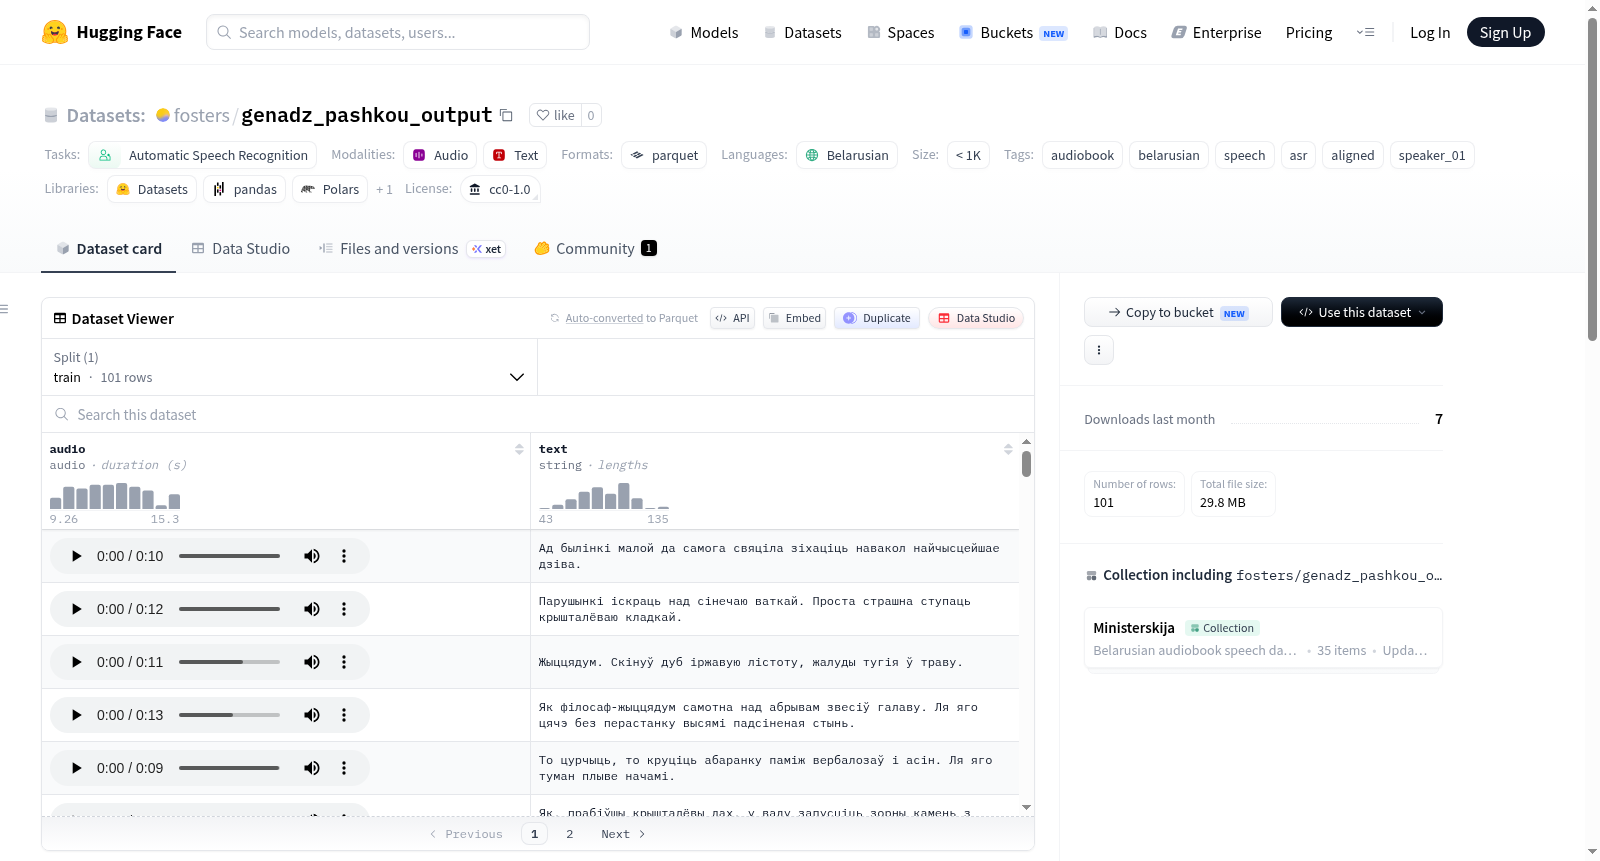
该数据集名为“Зборнік”(作者:Генадзь Пашкоў),是Ministerskija收藏的一部分,专注于提供白俄罗斯语有声读物的音频与转录文本的对齐数据。数据集旨在支持自动语音识别(ASR)任务,特别适用于白俄罗斯语语音处理。数据内容包含约15秒的短音频片段及其对应的转录文本,所有对齐均经过严格处理,置信度阈值不低于0.95。具体数据规模包括:在HuggingFace平台发布101个样本行,数据库总计134行,音频总时长为0小时28分钟。每个数据样本由三个字段构成:audio(音频片段)、text(转录文本,通过Gemini和ASR对齐生成)和chunk_uid(唯一片段标识符)。数据处理流程涉及将原始有声读物分割成短片段,并利用Gemini和两个独立的ASR系统实现音频与文本的精确对齐,确保数据质量。该数据集适用于白俄罗斯语语音识别、有声读物分析及相关研究。
The dataset is named Зборнік (author: Генадзь Пашкоў) and is part of the Ministerskija collection, focusing on providing aligned audio and transcription text for Belarusian audiobooks. It aims to support automatic speech recognition (ASR) tasks, particularly for Belarusian language speech processing. The data consists of short audio segments approximately 15 seconds long along with their corresponding transcriptions, with all alignments processed rigorously and a confidence threshold of no less than 0.95. The specific scale includes: 101 sample rows published on the HuggingFace platform, a total of 134 rows in the database, and an audio total duration of 0 hours 28 minutes. Each data sample comprises three fields: audio (audio segment), text (transcription text, generated via Gemini and ASR alignment), and chunk_uid (unique segment identifier). The data processing involves splitting original audiobooks into short segments and using Gemini and two independent ASR systems for precise audio-text alignment to ensure data quality. This dataset is suitable for Belarusian speech recognition, audiobook analysis, and related research.
数据集概述:Зборнік — Генадзь Пашкоў
语言
- 白俄罗斯语 (Belarusian)
许可证
- CC0-1.0 (公共领域)
任务类别
- 自动语音识别 (Automatic Speech Recognition, ASR)
标签
- 有声书 / 白俄罗斯语 / 语音 / ASR / 对齐 / speaker_01
数据集规模
- 样本数:1,000 ~ 10,000 条
基本信息
- 来源:来自 Ministerskija 合集,为白俄罗斯语有声书的对齐音频及转录文本。
- 作者:Генадзь Пашкоў
- 当前发布行数 (HF):101 行
- 数据库总行数:134 行
- 音频总时长:0 小时 28 分钟
- 对齐置信度阈值:≥ 0.95
数据结构
每条数据包含以下字段:
audio:音频片段(时长约 15 秒)text:转录文本(通过 Gemini 和 ASR 对齐生成)chunk_uid:片段唯一标识符
数据处理方式
- 有声书被切分为短片段,并利用 Gemini 和两套独立 ASR 系统与转录文本对齐。
- 对齐置信度 ≥ 0.95。
说话人信息
| 属性 | 值 |
|---|---|
| 说话人聚类 | speaker_01 |
| 平均相似度评分 | 0.92 |
| 最近似数据集 | dzhozef_redzyard_kipling_output (相似度 0.96) |
- 说话人识别模型:WavLM-Base+(余弦相似度,阈值=0.82)