yakub_kolas_novaya_zyamlya_output
收藏资源简介:
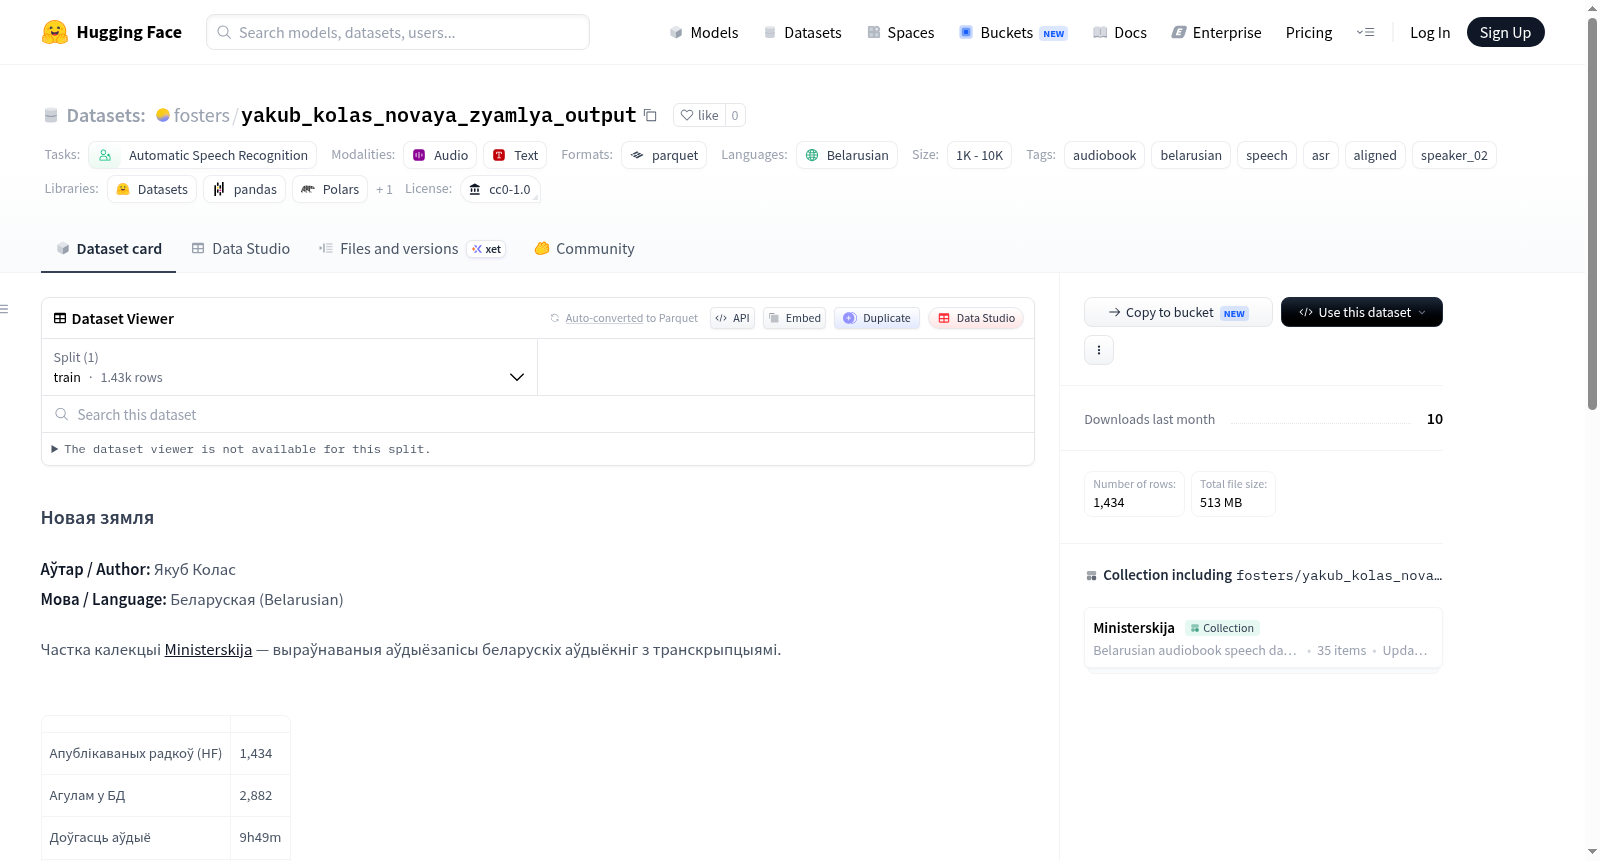
“Новая зямля”数据集是“Ministerskija”集合的一部分,该集合专注于提供对齐的白俄罗斯语有声读物录音及其文本转录。本数据集基于白俄罗斯作家雅库布·科拉斯的著名诗作《Новая зямля》(新土地)构建,是一个用于自动语音识别(ASR)任务的专业语料库,特别适用于白俄罗斯语的语音模型训练与评估。数据集包含精细处理的音频-文本对齐对,每个样本由三个核心字段组成:`audio`字段为时长约15秒的音频片段;`text`字段为对应的白俄罗斯语文本转录;`chunk_uid`字段是该片段的唯一标识符。构建过程严谨,原始有声读物被分割成短片段后,利用Gemini工具并结合两个独立的自动语音识别系统进行文本对齐,确保对齐质量,所有样本的对齐置信度均不低于0.95。数据集在HuggingFace平台上公开发布了1,434条样本,完整后端数据库共包含2,882条样本,对应的音频总时长约为9小时49分钟。数据集以CC0 1.0通用公共领域奉献许可协议发布,适用于学术研究和商业开发。
The “Новая зямля” dataset is part of the “Ministerskija” collection, which focuses on providing aligned Belarusian audiobook recordings and their text transcriptions. This dataset is built upon the famous poem “Новая зямля” (New Land) by the Belarusian writer Yakub Kolas. It is a specialized corpus for automatic speech recognition (ASR) tasks, particularly suitable for training and evaluating speech models for the Belarusian language. The dataset contains finely processed audio-text alignment pairs. Each sample consists of three core fields: the `audio` field is an audio segment approximately 15 seconds long; the `text` field is the corresponding Belarusian text transcription; and the `chunk_uid` field is a unique identifier for the segment. The construction process is rigorous: the original audiobook is split into short segments, and then text alignment is performed using the Gemini tool combined with two independent automatic speech recognition systems to ensure alignment quality, with all samples having an alignment confidence of at least 0.95. The dataset is publicly released on the HuggingFace platform with 1,434 samples, while the complete backend database contains 2,882 samples, corresponding to a total audio duration of approximately 9 hours and 49 minutes. It is released under the CC0 1.0 Universal Public Domain Dedication license, making it suitable for academic research and commercial development.
数据集概述
数据集名称: Новая зямля — Якуб Колас
语言: 白俄罗斯语 (Belarusian)
许可证: CC0-1.0
任务类型: 自动语音识别 (ASR)
标签: 有声书、白俄罗斯语、语音、ASR、对齐、speaker_02
规模: 1,000 < 样本数 < 10,000
所属集合: Ministerskija — 对齐的白俄罗斯语有声书音频片段及其转录文本。
数据统计
| 指标 | 数值 |
|---|---|
| 已发布行数 (HF) | 1,434 |
| 数据库总行数 | 2,882 |
| 音频总时长 | 9小时49分钟 |
| 对齐置信度阈值 | ≥ 0.95 |
数据结构
每条数据包含三个字段:
audio— 音频片段(约15秒)text— 转录文本(通过Gemini和ASR对齐生成)chunk_uid— 片段的唯一标识符
数据处理
有声书被切分为短片段,并借助 Gemini 和两个独立的 ASR系统 完成与转录文本的对齐,对齐置信度不低于 0.95。
说话人信息
| 指标 | 数值 |
|---|---|
| 说话人聚类 | speaker_02 |
| 相似度评分(平均) | 0.898 |
| 最近邻数据集 | ivan_navumenka_sasna_pry_daroze_output(相似度 0.95) |
说话人识别基于 WavLM-Base+ 模型(余弦相似度,阈值 0.82)。