MMQA
收藏资源简介:
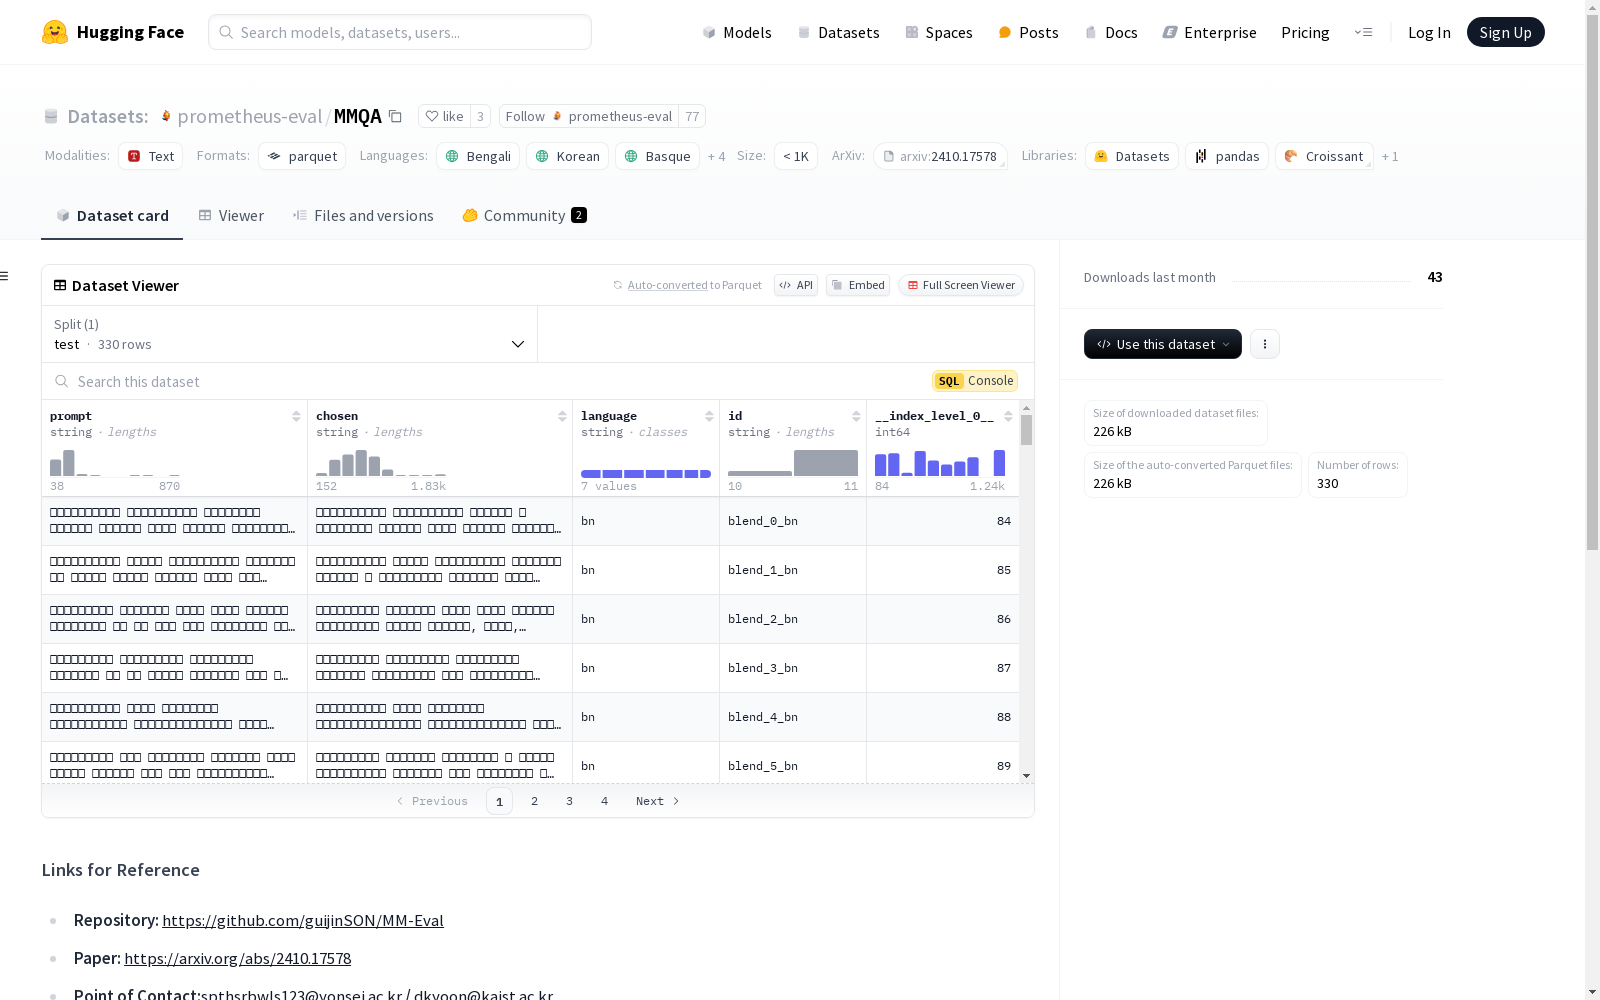
MMQA数据集是一个多语言和多文化的问答数据集,源自MM-Eval基准测试的一个子集。该数据集包含长篇问答对,涉及七种语言(孟加拉语、韩语、加泰罗尼亚语、巴斯克语、西班牙语、越南语和阿拉伯语)的文化相关内容。数据集旨在评估模型在不同语言和文化背景下生成详细、文化相关答案的能力。
The MMQA dataset is a multilingual and multicultural question answering dataset derived from a subset of the MM-Eval benchmark. This dataset includes long-form question-answer pairs covering culturally relevant content across seven languages: Bengali, Korean, Catalan, Basque, Spanish, Vietnamese, and Arabic. The dataset aims to evaluate the ability of models to generate detailed, culturally relevant answers under different language and cultural backgrounds.
MMQA 数据集
概述
MMQA 是一个多语言、多文化的问答数据集,源自 MM-Eval 基准测试的一个子集。该数据集包含长篇问答对,涉及七种语言的文化相关背景。MMQA 旨在评估模型在不同语言和背景下生成详细、文化相关答案的能力。
语言覆盖
- 孟加拉语 (Bengali)
- 韩语 (Korean)
- 加泰罗尼亚语 (Catalan)
- 巴斯克语 (Basque)
- 西班牙语 (Spanish)
- 越南语 (Vietnamese)
- 阿拉伯语 (Arabic)
引用
如果您发现该数据集对您有帮助,请考虑引用我们的论文:
plaintext @article{son2024mm, title={MM-Eval: A Multilingual Meta-Evaluation Benchmark for LLM-as-a-Judge and Reward Models}, author={Son, Guijin and Yoon, Dongkeun and Suk, Juyoung and Aula-Blasco, Javier and Aslan, Mano and Kim, Vu Trong and Islam, Shayekh Bin and Prats-Cristi{`a}, Jaume and Tormo-Ba{~n}uelos, Luc{\i}a and Kim, Seungone}, journal={arXiv preprint arXiv:2410.17578}, year={2024} }