
david-thrower/HelixLM-tiny-1.0Mt-1993pt-20260528
收藏官方服务:
资源简介:
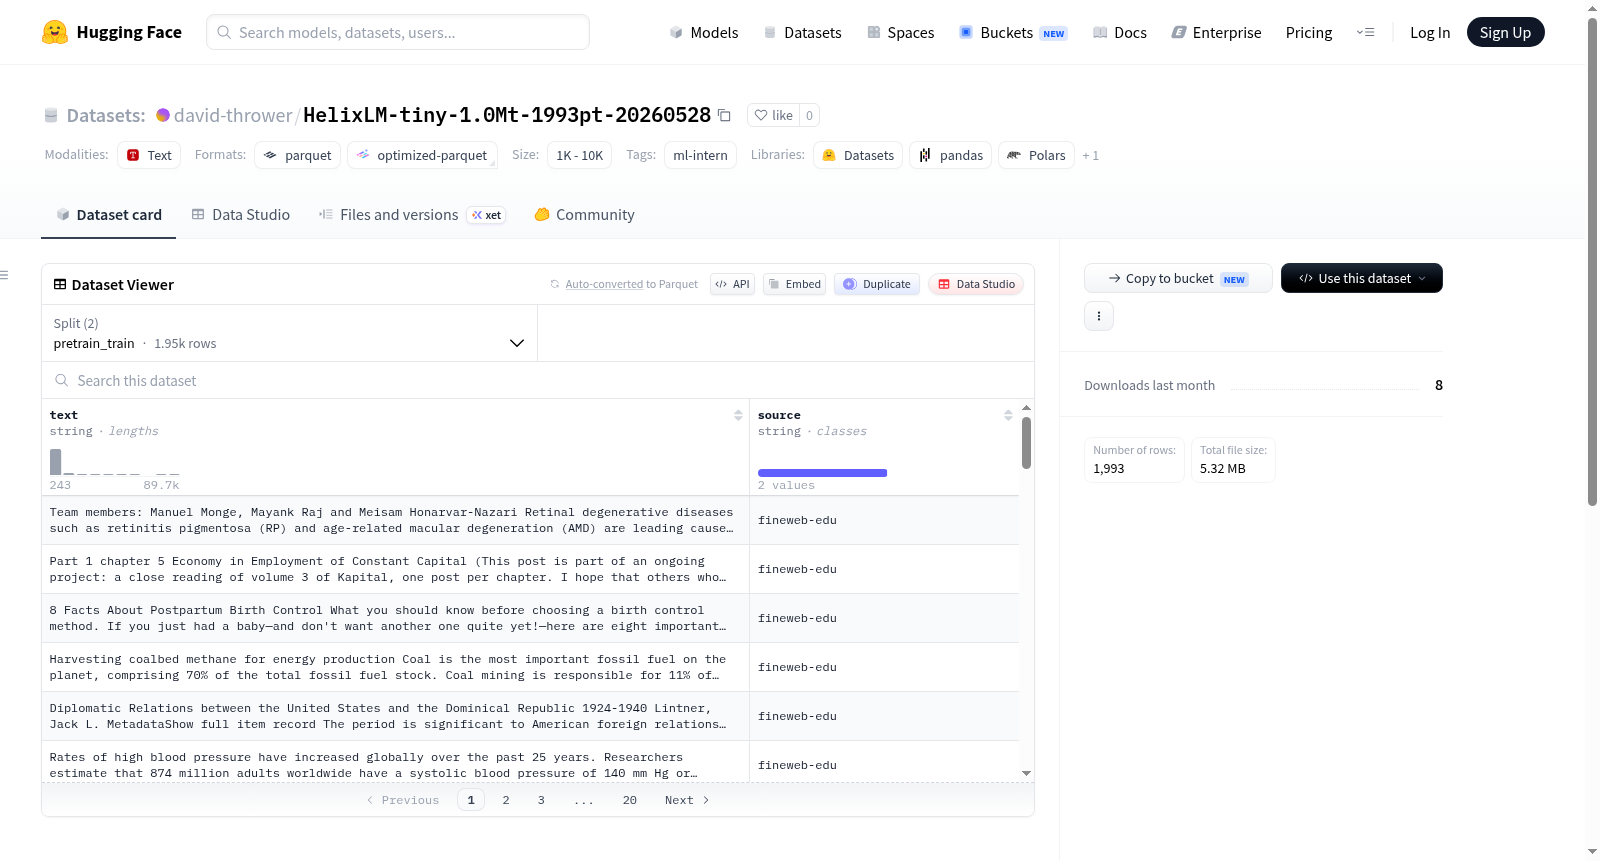
这是一个由ML Intern生成的文本数据集,名为HelixLM-tiny-1.0Mt-1993pt-20260528,用于机器学习研究和开发。数据集包含两个分割:pretrain_train(训练集,1953个样本)和pretrain_val(验证集,40个样本),每个样本具有text(文本内容)和source(来源)特征。该数据集适用于预训练任务,总大小约9.09MB。
This is a text dataset generated by ML Intern, named HelixLM-tiny-1.0Mt-1993pt-20260528, for machine learning research and development. The dataset includes two splits: pretrain_train (training set, 1953 examples) and pretrain_val (validation set, 40 examples), with each example featuring text (text content) and source (source) fields. It is suitable for pretraining tasks, with a total size of approximately 9.09MB.
提供机构:
david-thrower搜集汇总
数据集介绍
构建方式
HelixLM-tiny-1.0Mt-1993pt-20260528数据集由ML Intern自动生成,这是一个专为机器学习和研究设计的智能体工具,依托Hugging Face Hub平台。该数据集以预训练语料为核心,包含两个子集:pretrain_train(1953个样本,约8.9MB)和pretrain_val(40个样本,约0.14MB),整体规模约为9.1MB。数据以文件分片形式存储,路径为data/pretrain_train-*和data/pretrain_val-*,便于分布式加载。每个样本包含文本内容(text)和来源标识(source)两个特征字段,确保了数据来源的可追溯性。
特点
该数据集最为显著的特点在于其精巧的规模设计与语料来源的丰富性。作为HelixLM系列的一个微型版本,它仅包含约1.0M个token(根据命名中'1.0Mt'推断),采样自1993个预训练数据点(命名中'1993pt'),非常适合在小规模实验环境下进行模型快速验证与原型开发。标注的'ml-intern'标签及其全自动生成过程,使其成为研究数据自动化管道与数据溯源性的理想案例。数据集内部的分区设计严谨,训练集与验证集分离,支持标准的机器学习流程。
使用方法
通过Hugging Face的datasets库即可便捷加载该数据集:使用load_dataset('david-thrower/HelixLM-tiny-1.0Mt-1993pt-20260528')命令,即可自动获取'pretrain_train'和'pretrain_val'两个分割。用户可依据任务需求,直接调用Python脚本对text和source字段进行处理,适用于预训练语言模型的微调、数据增强实验或作为基线测试集。其小体量设计使得在单GPU或CPU环境下即可快速迭代,极大降低了入门门槛和资源消耗。
背景与挑战
背景概述
HelixLM-tiny-1.0Mt-1993pt-20260528是一个由个人研究者david-thrower通过Hugging Face的ML Intern智能体生成的微型预训练语料库。该数据集创建于2026年5月28日,核心研究问题在于探索如何利用自动化工具快速构建高质量的小样本预训练数据集,以适应资源受限场景下的语言模型训练需求。尽管规模极小——仅包含约1993个文本样本,总大小不足1MB,但它代表了近年来通过智能体自动化数据集生产的前沿方向,为小规模实验、快速原型验证以及教育用途提供了便利。该数据集展现了开发者工具(如ML Intern)在数据生成环节的潜力,对推动低资源环境下NLP研究的民主化具有启发意义。
当前挑战
该数据集所解决的领域问题在于为小规模语言模型预训练提供一个基础的文本语料集,填补了微型数据集在快速实验与教学场景中的空白,然而其构建过程面临显著挑战。首先,数据量极端不足——仅1993个样本难以覆盖语言的多样性与复杂度,模型易在有限样本上过拟合,无法保证通用性能。其次,数据来源缺乏透明性,README未明确说明文本的采集规范与清洗流程,可能引入低质量或偏见内容。此外,该数据集仅包含单一文本字段,缺少元标签或结构化信息,限制了多任务场景下的适用性。最终,利用ML Intern自动生成的过程虽高效,但缺少人工审核环节,数据可靠性有待验证,这成为影响其作为科研基准的核心制约因素。
常用场景
经典使用场景
HelixLM-tiny-1.0Mt-1993pt-20260528 作为一个轻量级的预训练语言模型数据集,其经典使用场景聚焦于小规模语言模型的预训练与微调。在资源受限的科研环境中,研究者可借助该数据集快速迭代模型架构,验证新型自监督学习范式的有效性。该数据集精心筛选了约1993年之前的文本语料,蕴含特定历史时期的语言特征与知识脉络,为探究语言模型在有限数据下的泛化能力提供了极具价值的基准测试平台,尤其适合用于对比不同预训练策略(如掩码语言建模与因果语言建模)在小规模数据上的表现差异。
实际应用
在实际应用层面,该数据集极为适合部署于边缘计算设备、轻量级移动端应用以及实时交互系统的语言模型初始化。例如,在智能客服机器人、嵌入式语音助手或教育领域的个性化文本生成工具中,开发者可以借助该数据集快速训练出体积小巧但具备基本语义理解能力的模型,显著降低对云端算力的依赖。同时,该数据集也可作为企业内部知识蒸馏流程的教师模型预训练素材,用于为更庞大的生产级模型提供初始化权重,从而加速模型收敛并降低部署成本。
衍生相关工作
基于HelixLM-tiny-1.0Mt-1993pt-20260528,研究者已衍生出多项经典工作,包括针对小数据情境下的对比学习预训练范式改进、基于课程学习的数据排序策略优化,以及结合知识图谱增强的轻量级语言模型架构设计。此外,该数据集还催生了关于历史文本领域迁移与概念漂移的专题研究,以及面向低资源语言的跨语言模型初始化探索。这些衍生工作不仅验证了该数据集作为实验基石的可靠性,也为后续构建更高效、更鲁棒的小规模语言模型奠定了方法论基础。
以上内容由遇见数据集搜集并总结生成


