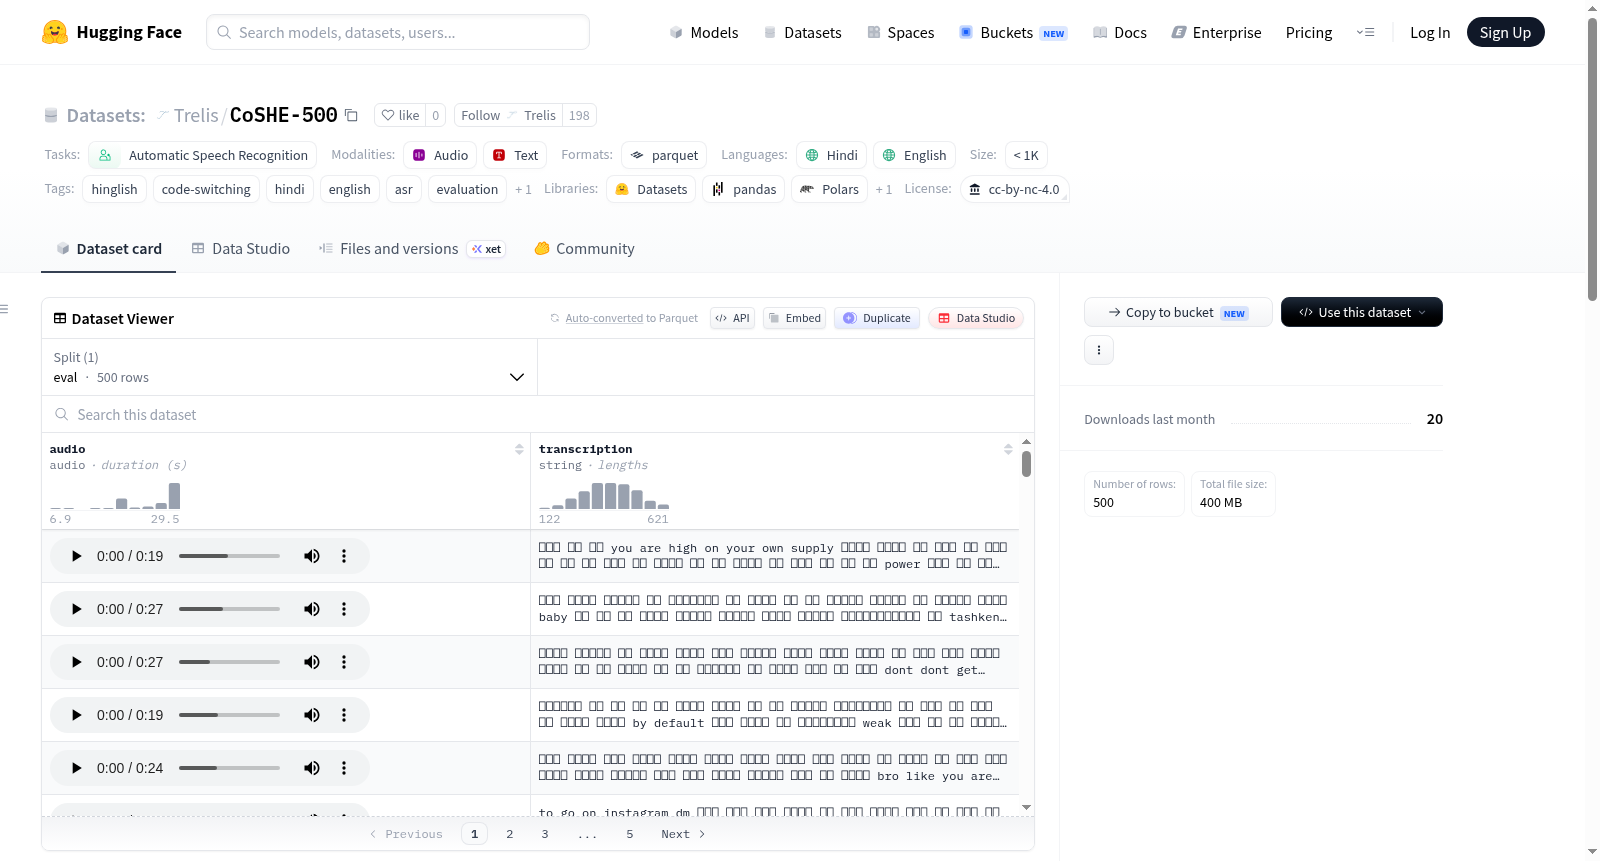
Trelis/CoSHE-500
收藏资源简介:
CoSHE-500是一个包含500个对话式印地语-英语语码转换(Hinglish)语音片段的评估数据集,每个片段约30秒,提供逐字混合脚本(天城文用于印地语,拉丁文用于英语)的参考转录。该数据集旨在测量真实世界语码转换自动语音识别(ASR)的质量,特别关注印地语/英语模型在此场景下的性能下降。它是从soketlabs/CoSHE-Eval数据集中精选的子集,经过重新分发,保留原始CC-BY-NC-4.0许可证(署名-非商业性使用)。数据集仅用于评估和基准测试,不建议用于训练,以确保其作为公平公共基准的有效性。
CoSHE-500 is a 500-clip evaluation set of conversational Hindi–English code-switched (Hinglish) speech, with verbatim mixed-script (Devanagari for Hindi, Latin for English) reference transcriptions. It is designed to measure real-world code-switch ASR quality, particularly in settings where Hindi/English models degrade. The dataset is a curated subset of soketlabs/CoSHE-Eval, redistributed under its original CC-BY-NC-4.0 license (attribution, non-commercial). It is intended for evaluation and benchmarking of ASR systems on conversational Hinglish, not for training, to maintain it as a fair public benchmark.