
遇见数据集

COLD-team/COLD

收藏
Hugging Face2022-06-21 更新2024-03-04 收录
官方服务:

资源简介:

COLD数据集旨在帮助研究人员诊断和评估其自动仇恨言论检测系统。该语料库突出了四种不同类型的复杂冒犯性语言:侮辱性语言、回收的侮辱性语言、形容词名词化和距离化,以及非冒犯性文本。数据集包含从三个不同数据集中收集的推文,并由六名标注者进行标注,每个实例至少由三名不同的标注者标注。数据以.tsv文件格式提供,包含八个列,其中四个是信息列,四个是标注相关列。

The COLD dataset is designed to assist researchers in diagnosing and evaluating their automated hate speech detection systems. This corpus features four distinct categories of complex offensive language: insulting language, recycled insulting language, nominalized adjectives, and distancing language, as well as non-offensive texts. The dataset consists of tweets collected from three separate datasets, annotated by six annotators, with each instance being annotated by at least three distinct annotators. The data is provided in TSV file format, containing eight columns: four informational columns and four annotation-related columns.

提供机构:
COLD-team
原始信息汇总

COLD: Complex Offensive Language Dataset

数据集概述

  • 目的:用于诊断和评估自动仇恨言论检测系统。
  • 内容:包含四种复杂攻击性语言类型(侮辱、回收的侮辱、形容词名词化、语言距离)及非攻击性文本。
  • 来源:数据集由三个不同的数据集(Davidson et al, 2017; Waseem and Hovy, 2016; Robinson, 2017)的推文组成。
  • 标注:由6名标注者完成,每个实例至少由3名不同的标注者标注。

数据集版本

  • COLD-2016:用于《Journal of Linguistics and Computational Linguistics》论文中的分析和实验结果,包含2016个实例。

数据格式与标注

  • 文件类型:.tsv
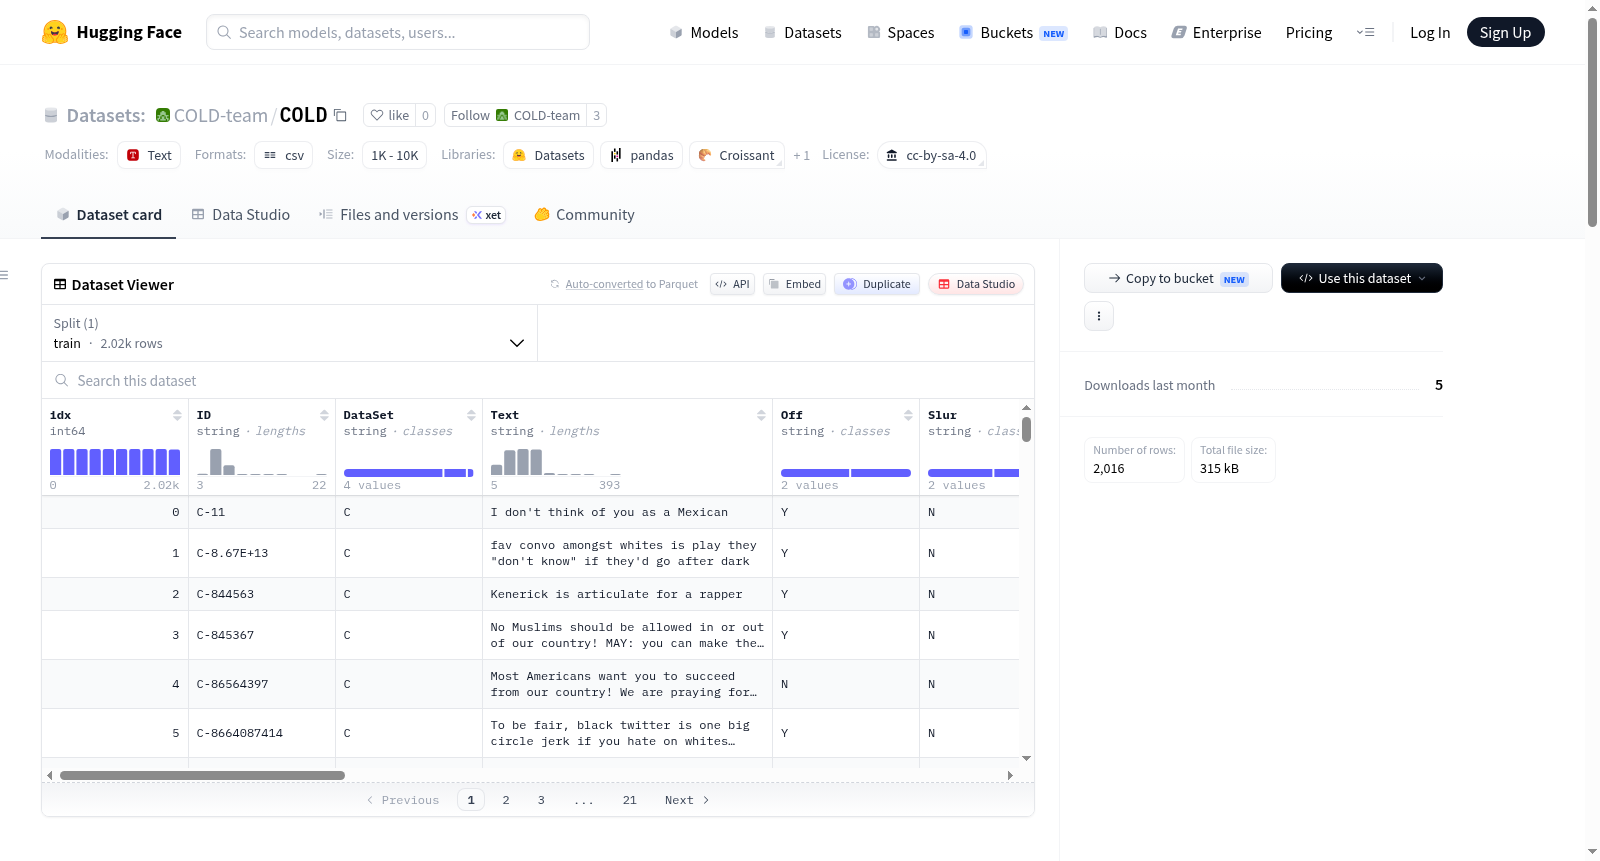
  • 列信息:
    • 信息性列:
      1. ID - 原始数据集信息及实例ID
      2. Dataset - 实例来源的数据集标识
      3. Text - 实例文本内容
    • 多数投票列:
      1. Off - 文本是否具有攻击性
      2. Slur - 文本中是否包含侮辱
      3. Nom - 文本中是否存在形容词名词化
      4. Dist - 文本中是否存在语言距离
    • 个体标注者列:
      1. Off1/2/3 - 标注者对文本攻击性的判断
      2. Slur1/2/3 - 标注者对文本中侮辱的判断
      3. Nom1/2/3 - 标注者对文本中形容词名词化的判断
      4. Dist1/2/3 - 标注者对文本中语言距离的判断
    • 类别:
      1. Cat - 根据多数投票结果推断的类别

联系方式

  • 如有疑问,请联系 carrc9953@gmail.com, alexis.palmer@unt.edu, 或 melissa.robinson@my.unt.edu。

引用信息

  • 使用此数据集时,请引用以下论文:

    @article{cold:2020, title = {COLD: Annotation scheme and evaluation data set for complex offensive language in English}, author = {Palmer, Alexis and Carr, Christine and Robinson, Melissa and Sanders, Jordan}, journal = {Journal of Linguistics and Computational Linguistics, Special Issue}, year = {2020}, volume={to appear}, number={to appear}, pages = {tbd} }
搜集汇总
数据集介绍
COLD-team/COLD 数据集图片
构建方式
在自然语言处理领域,仇恨言论检测是维护网络环境清朗的重要任务,然而现有系统常难以识别复杂形式的攻击性语言。COLD数据集正是为此而生,由Palmer等人精心构建,旨在为研究者提供诊断与评估自动仇恨言论检测系统的工具。该数据集汇集了来自Davidson等人(2017)、Waseem与Hovy(2016)以及Robinson(2017)三个不同来源的推文,共计2016条实例。每条实例由至少三名标注员协作完成,针对是否包含冒犯性内容、侮辱性词汇、形容词名词化现象及语言疏离特征四个维度进行二元判定,最终通过多数投票机制生成共识标签,并据此归纳出细粒度的类别划分。
特点
COLD数据集的核心价值在于其聚焦于四种复杂的攻击性语言类型:侮辱性词汇、回收的侮辱性词汇、形容词名词化以及语言疏离现象,同时纳入非攻击性文本作为对比基准。这种精细化的分类体系超越了传统二元分类的局限,能够更真实地反映网络言论的微妙差异。数据以TSV格式存储,结构清晰,包含信息列(如文本来源与原始ID)和标注列(多数投票与个体标注结果),为研究者提供了从微观标注到宏观类别的多层次分析视角。此外,数据来源的多样性与标注流程的严谨性,确保了其作为基准测试的可靠性与泛化能力。
使用方法
使用者可直接从HuggingFace平台加载该数据集,其TSV格式便于通过Pandas等工具进行解析。数据集的八个字段中,文本列(Text)作为模型输入,而多数投票列(Off、Slur、Nom、Dist)及类别列(Cat)可作为多标签或多分类任务的训练目标。个体标注列(如Off1/2/3)则支持对标注一致性的深入分析。研究者可基于此数据集训练分类模型,或将其作为评估基准,通过对比模型输出与标注结果,诊断系统在识别特定复杂攻击性语言类型上的短板,从而迭代优化算法。
背景与挑战
背景概述
在自然语言处理领域,仇恨言论与攻击性语言的自动检测一直是备受关注的研究热点,然而现有数据集多聚焦于显式冒犯性表达,对于语言中蕴含的复杂、隐性冒犯机制尚缺乏系统性的标注资源。为填补这一空白,Alexis Palmer、Christine Carr、Melissa Robinson与Jordan Sanders于2020年共同创建了COLD(Complex Offensive Language Dataset)数据集,旨在为研究者提供诊断与评估自动检测系统的标准化基准。该数据集汇集了来自Davidson等(2017)、Waseem与Hovy(2016)以及Robinson(2017)三个公开语料的推文,由六名标注者进行多轮标注,最终筛选出2016条样本,重点覆盖脏话、回收性污名化、形容词名词化及语言疏离等四种复杂攻击性语言类型。COLD的发布为深入理解冒犯性语言的多样性提供了关键资源,推动了该领域从简单分类向细粒度语义分析的演进。
当前挑战
COLD数据集所面临的挑战主要体现在两个层面。在领域问题层面,现有仇恨言论检测系统普遍难以识别隐含的、非字面意义的冒犯性语言,如形容词名词化(例如“a female”贬指女性)或语言疏离(通过代词选择表达排斥),这些现象依赖上下文与语用推理,传统基于关键词或浅层特征的方法极易失效。在数据集构建过程中,标注一致性成为核心难题:六位标注者需对四类复杂语言现象分别进行二元判断,而“疏离”等概念主观性强,导致标注者间分歧显著,尽管采用了多数投票机制,但难以完全消除歧义。此外,数据来源涵盖多个原始语料,不同语料的采样偏差与领域分布差异可能影响模型的泛化能力,使得COLD在作为诊断工具时需谨慎处理跨数据集迁移的适配问题。
常用场景
经典使用场景
COLD数据集专为评估自动仇恨言论检测系统而设计,聚焦于复杂冒犯性语言的识别。其核心应用场景在于诊断模型对四类语言现象的敏感度:污名化词汇、被重新赋义的污名化词汇、形容词名词化以及语言距离化。通过整合来自Davidson等人(2017)、Waseem与Hovy(2016)以及Robinson(2017)三个经典数据集的推文,该语料库提供了多维度标注信息,包括冒犯性、污名化、名词化和距离化四个二元判断,并基于多数投票生成类别标签。研究者可利用此数据集检验模型在高语境依赖、语义模糊及社会文化变迁影响下的表现,从而推动更精细化的冒犯性语言检测技术发展。
解决学术问题
COLD数据集有效解决了自然语言处理领域关于冒犯性语言检测中“复杂性”被长期忽视的学术问题。传统数据集多将冒犯性语言简化为二元分类(仇恨言论与非仇恨言论),而COLD深入剖析了语言中的微妙差异,如污名化词汇的重塑(reclaimed slurs)与形容词名词化现象,这些特征常导致模型误判。该数据集通过多标注者共识机制,揭示了人类对复杂冒犯性语言感知的多样性,为构建更具鲁棒性的检测系统提供了基准。其意义在于推动学界从粗粒度分类转向细粒度语言特征分析,促进了跨学科对话,使计算语言学与社会语言学在仇恨言论研究领域实现了更紧密的融合。
衍生相关工作
COLD数据集衍生了一系列聚焦于复杂语言现象的研究工作。Palmer等人(2020)基于该语料库提出了系统的标注方案,并分析了不同标注者间的一致性,为后续研究奠定了方法论基础。后续工作进一步探索了多任务学习框架,将冒犯性检测与具体语言特征(如污名化、名词化)联合建模,提升了模型的可解释性。此外,研究者还利用COLD中的‘距离化’标注,开发了针对隐性仇恨言论的检测算法,填补了传统模型在识别间接歧视方面的空白。这些衍生工作不仅扩展了数据集的应用边界,还推动了计算语言学向更精细的社会语言现象分析演进,例如探讨语言如何在社会互动中建构权力关系。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

