
遇见数据集

Kvasir-VQA-x1

收藏
arXiv2025-06-12 更新2025-11-28 收录
官方服务:

资源简介:

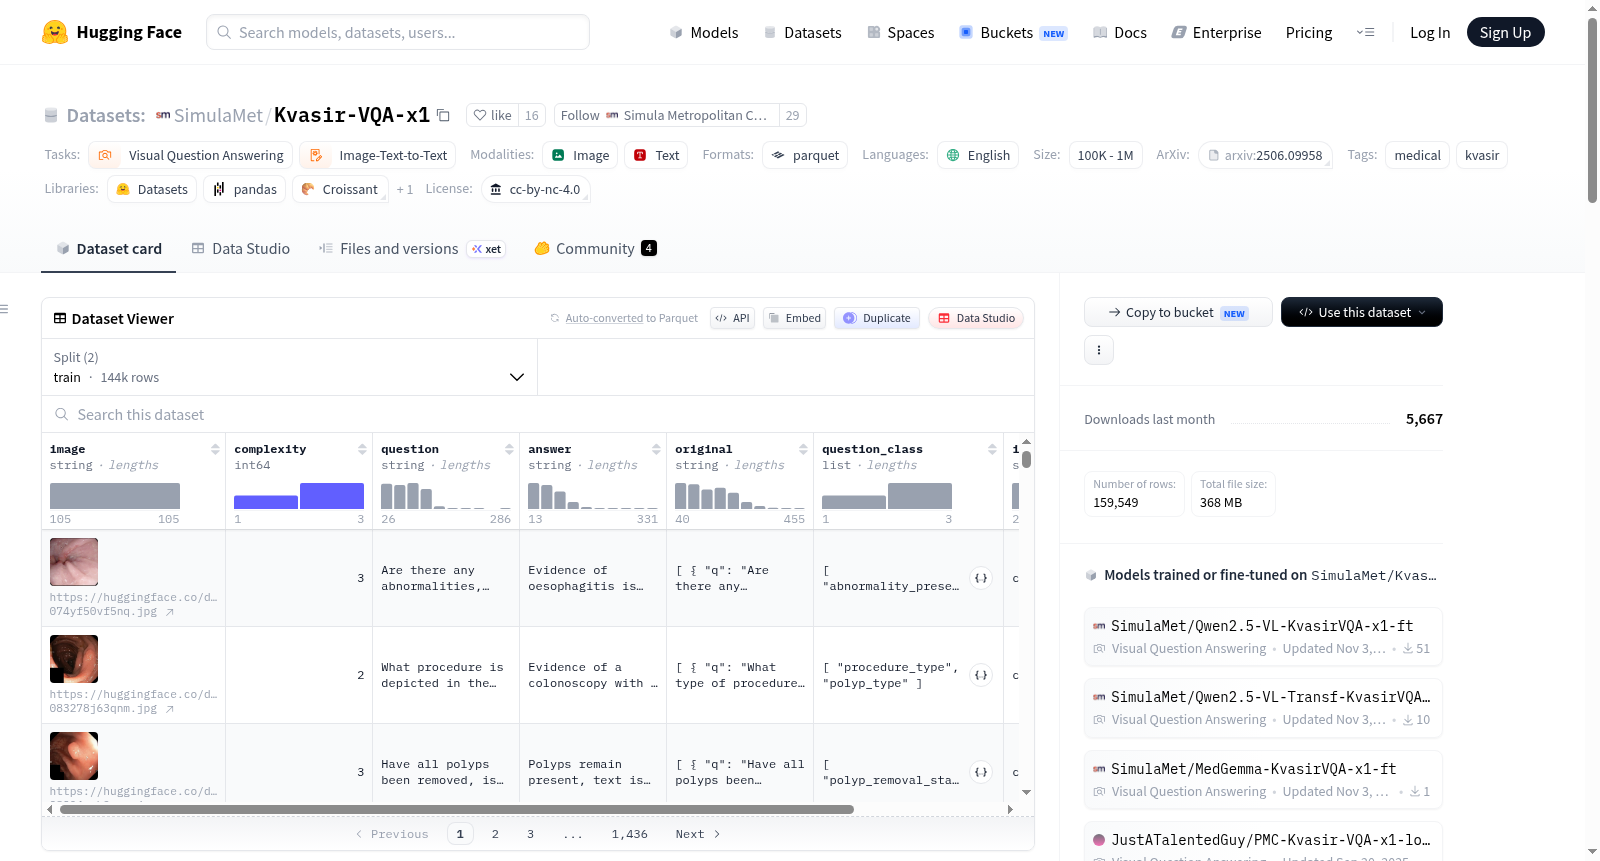
Kvasir-VQA-x1是一个大规模的医学视觉问答数据集,用于胃肠道内窥镜检查。该数据集在原有的Kvasir-VQA基础上进行了显著扩展,新增了159,549个问答对,旨在测试更深入的医学推理能力。数据集采用大型语言模型生成问题,并按复杂性分层,以更好地评估模型的推理能力。为了确保数据集为模型准备真实世界的临床场景,还引入了多种视觉增强,模拟常见的成像伪影。数据集的结构支持两个主要的评估轨道:一个用于标准VQA性能,另一个用于测试模型对这些视觉扰动的鲁棒性。通过提供一个更具挑战性和临床相关性的基准,Kvasir-VQA-x1旨在加速更可靠和有效的多模态AI系统的开发,用于临床环境。数据集完全可访问,并遵循FAIR数据原则,使其成为更广泛研究社区的宝贵资源。

Kvasir-VQA-x1 is a large-scale medical visual question answering (VQA) dataset designed for gastrointestinal endoscopy. Building upon the original Kvasir-VQA dataset, this work significantly expands the corpus with 159,549 additional question-answer pairs, targeting the evaluation of deeper medical reasoning capabilities. The questions in the dataset are generated by large language models (LLMs), and the pairs are stratified by complexity to better assess model reasoning abilities. To prepare the dataset for real-world clinical scenarios, multiple visual augmentations are introduced to simulate common imaging artifacts. The structure of the dataset supports two primary evaluation tracks: one for standard VQA performance assessment, and the other for testing model robustness against these visual perturbations. By providing a more challenging and clinically relevant benchmark, Kvasir-VQA-x1 aims to accelerate the development of more reliable and effective multimodal AI systems for clinical settings. The dataset is fully accessible and adheres to the FAIR data principles, making it a valuable resource for the broader research community.
创建时间:
2025-06-12
搜集汇总
数据集介绍
Kvasir-VQA-x1 数据集图片
构建方式
Kvasir-VQA-x1数据集在原始Kvasir-VQA基础上进行了系统化扩展与精细化构建。研究团队依托HyperKvasir与Kvasir-Instrument两大公开内镜图像资源,以6,500张原始图像为基底,采用大语言模型辅助的流水线策略,通过对已有问答对进行归类、组合采样与提示工程,生成了15万9,549条全新的、经专家验证的问题-答案对。其中,单一问答对经自然语言改写形成一级复杂度问题,两或三个问答对经合并与推理合成形成二级与三级复杂度问题。同时,针对每张图像生成了10种弱增强变体,包括随机裁剪、旋转、仿射变换与色彩抖动,以模拟真实临床中的成像变异,从而使数据集在语言与视觉两个维度均获得显著扩展。
特点
该数据集最显著的特征在于其多维度的复杂性分层与鲁棒性评估架构。每一条问答对均被赋予1至3的复杂度评分,量化其从单一事实检索到多跳推理的认知负荷,为细粒度模型评估提供了清晰标尺。数据集还创新性地设置双轨评估机制:标准轨迹用于评测模型在原始图像上的核心问答能力,变换轨迹则通过弱增强图像检验模型面对视觉扰动时的泛化性能。此外,答案经过自然化处理,从简短标签转变为流畅、符合临床语境的叙述,极大地提升了语言多样性与真实感。数据涵盖18个临床类别,如息肉类型、器械位置、异常颜色等,确保了临床推理深度的全面覆盖。
使用方法
研究者可通过Hugging Face平台便捷加载该数据集,并利用配套发布的代码库进行灵活调用。数据集以标准格式提供图像标识符、复杂度等级、问题、答案、原始问答元数据及临床类别标签,支持基于DataFrame或JSON的解析与过滤。推荐的使用途径包括:视觉-语言模型的指令微调与评估、基于复杂度分数的课程学习或分层基准测试、以及通过提供的增强脚本进行可控扰动下的鲁棒性分析。预定义训练集与测试集划分确保了实验的可重复性,而公开的微调配置与评估工具包则为模型性能的公正比较与失败模式分析提供了完整的技术支撑。
背景与挑战
背景概述
Kvasir-VQA-x1 数据集由挪威 SimulaMet 与 Simula 研究实验室的 Sushant Gautam、Michael A. Riegler 和 Pål Halvorsen 等人于 2025 年创建,聚焦于胃肠道内窥镜图像中的医学视觉问答(MedVQA)。该数据集在原始 Kvasir-VQA 基础上,通过引入 159,549 个新问答对,显著扩展了数据规模与临床推理深度。其核心研究问题在于推动多模态人工智能系统在临床决策支持中的可靠应用,特别是针对复杂视觉推理与鲁棒性评估。通过分层复杂性问答策略与视觉扰动增强,Kvasir-VQA-x1 为医学多模态学习提供了更具挑战性的基准,对促进内窥镜领域智能化诊断具有重要影响力。
当前挑战
该数据集主要应对三方面挑战:首先,现有 MedVQA 数据集(如 VQA-RAD、SLAKE)规模有限、问题多样性不足,且多集中于放射领域,难以有效评估模型的深层临床推理能力;Kvasir-VQA-x1 通过生成需要多步推理的复杂问答对,以测试模型超越简单模式识别的综合能力。其次,内窥镜图像常包含镜面反射、运动模糊等成像伪影,对模型鲁棒性构成严峻考验;为此,数据集引入遮挡、对比度变化等视觉增强,模拟真实临床成像条件。最后,构建过程中专家验证与 LLM 辅助生成的结合,确保了问题的医学真实性与语言自然性,但大规模、高质量注释的生成与管理仍是显著挑战。
常用场景
经典使用场景
Kvasir-VQA-x1最经典的使用场景是作为胃肠道内窥镜图像的多模态推理与鲁棒性评估基准。该数据集通过生成159,549个临床复杂度分层的问题-答案对,并引入视觉增强图像模拟真实成像伪影,为研究者提供了训练和测试视觉-语言模型在胃肠病学领域深度临床推理能力的标准化平台。其双轨评估框架——标准VQA性能评估与鲁棒性测试——使其成为衡量下一代医学VQA系统推理准确性与泛化能力的标杆性资源。
衍生相关工作
该数据集已衍生出多项经典工作,包括基于LoRA微调的MedGemma与Qwen2.5-VL胃肠道专用VQA模型,其微调后平均准确率从30-45%跃升至87-90%。此外,研究者借助其视觉扰动轨开发了抗干扰图像编码器,以及基于复杂度分层得分的课程学习训练策略。LLM辅助的自动评审器(如Qwen3-30B-A3B)的引入,更为医学响应评估提供了超越BLEU/ROUGE的语义对齐新范式。
数据集最近研究
最新研究方向
在医学视觉问答领域,当前前沿方向聚焦于构建具备深层临床推理能力的多模态基准数据集,以推动生成式大模型在高复杂度、高风险的医疗场景中的应用。Kvasir-VQA-x1的提出正是对这一趋势的有力回应。该数据集以胃肠道内窥镜图像为核心,通过大规模语言模型辅助生成15.9万余个分层复杂度的问题-答案对,突破了既往数据集在临床推理深度、视觉扰动鲁棒性及语言多样性方面的局限。其创新性地引入双轨评估框架——标准性能轨与视觉鲁棒轨,并采用基于大语言模型的自动化裁判进行细粒度临床类别评估,为衡量生成式模型在真实临床环境中对多跳推理、视觉噪声容忍度及跨模态信息融合的效能提供了关键基准。这一资源的出现将显著加速更可靠、更具临床意义的医疗多模态AI系统的演进。
相关研究论文
  • 1
    通过挪威奥斯陆都市大学,挪威模拟大都市数字工程中心,挪威模拟研究实验室 · 2025年
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

