TartanAdversity
收藏资源简介:
TartanAdversity是一个合成的、经过增强的自动驾驶目标检测数据集。该数据集以BDD100K数据集的清晰天气街景为基础,通过两种不同的增强流程(生成式的Gemini Flash 2.0图像到图像重渲染和程序化的Automold道路增强库)重新渲染为三种恶劣天气条件(雾天、雨天、雪天),并完整保留了原始的目标边界框标注。数据集的核心研究目的是探索合成训练数据的“可学习性”,即评估使用此类合成天气数据训练的检测器模型在真实世界恶劣天气图像(如DAWN、ACDC、Foggy Zurich数据集)上的泛化与迁移能力。数据集包含一个训练集,共36,000张图像。数据在两种增强来源(`gemini` 和 `automold`)和三种天气条件(`foggy`、`rainy`、`snowy`)之间均匀平衡,形成6个分组,每组包含6,000张图像。每张图像都附带其来源、天气条件、原始文件名,并提供了YOLO和COCO两种格式的目标检测标注,方便直接接入不同的训练流程。标注遵循BDD100K的10类目标分类体系,包括自行车、巴士、汽车、摩托车、行人、骑行者、交通灯、交通标志、火车和卡车。YOLO标注使用归一化的边界框中心坐标和宽高,而COCO标注使用绝对像素坐标的边界框并包含面积和拥挤标志字段。该数据集主要作为合成训练材料,用于与真实数据混合训练目标检测模型,并在真实的恶劣天气验证集上进行评估。需要注意的是,图像是合成的近似,并非真实的恶劣天气捕获,并继承了BDD100K的地理、相机、类别平衡等偏差。数据集发布在CC-BY-4.0许可下,使用时需引用本数据集及原始的BDD100K数据集。
数据集概述:TartanAdversity
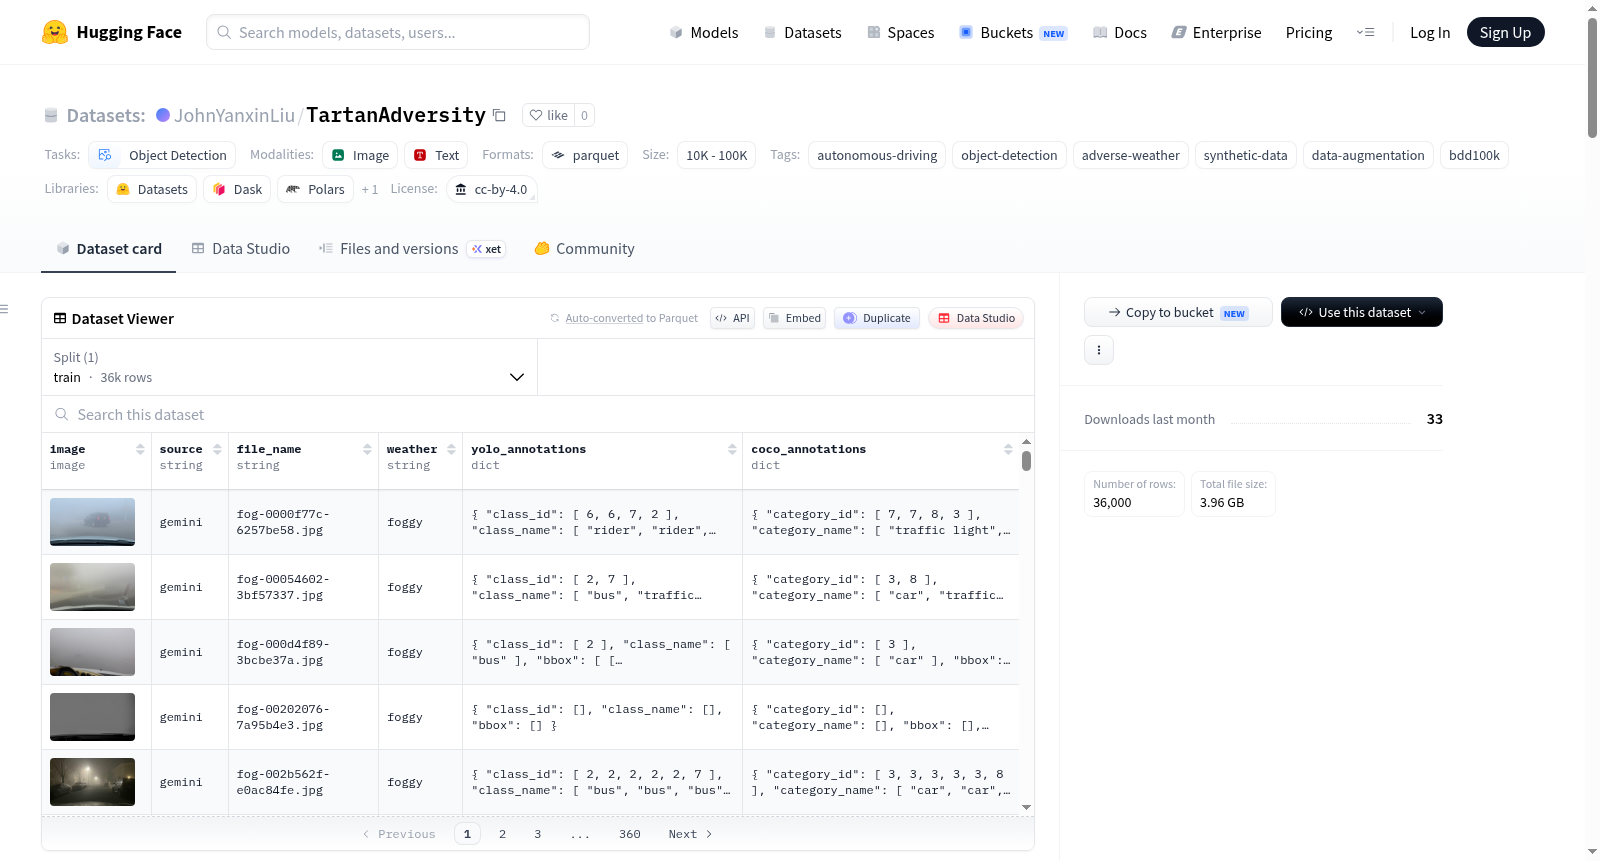
TartanAdversity 是一个通过合成数据增强的自动驾驶目标检测数据集。它选取 BDD100K 中的晴朗天气街景,使用两种不同的增强管线在恶劣天气(雾、雨、雪)下重新渲染,并保留原始目标标注。该数据集旨在研究合成训练数据的可学习性:即检测器在合成天气数据上训练后,对真实恶劣天气图像的泛化能力。
数据集规模与结构
- 总样本数:36,000 张图像,全部位于训练集(
train)。 - 存储格式:HuggingFace
datasetsParquet 分片,地址为data/。 - 图像尺寸:约 1024 像素宽(例如 1024×573,从 BDD100K 原生 1280×720 按比例缩小)。
- 每个样本包含的字段:
| 字段 | 类型 | 描述 |
|---|---|---|
image |
image |
增强后的 RGB 场景图像(JPEG 格式)。 |
source |
string |
产生该图像的增强管线:gemini(生成式)或 automold(程序化)。 |
file_name |
string |
该场景在 BDD100K 中的原文件名。 |
weather |
string |
应用的合成天气条件:foggy(雾)、rainy(雨)或 snowy(雪)。 |
yolo_annotations |
struct |
YOLO 格式的边界框标注(归一化坐标)。 |
coco_annotations |
struct |
COCO 格式的边界框标注(绝对像素坐标)。 |
标注格式详解
两种标注结构描述的是同一批目标,仅在索引和框编码上不同:
yolo_annotations:平行列表class_id(int64):0 索引类别,范围为 0…9。class_name(string):可读类别名称。bbox(float32[4]):归一化的[x_center, y_center, width, height],取值在[0, 1]。
coco_annotations:平行列表category_id(int64):1 索引类别,范围为 1…10。category_name(string):可读类别名称。bbox(float32[4]):绝对像素[x, y, width, height](左上角为原点)。area(float32):框的面积(像素²)。iscrowd(int64):COCO 的 crowd 标记(标准框均为0)。
数据来源与分组
数据集根据增强管线和天气条件两个维度进行平衡划分,形成 2 × 3 = 6 个分组,每组恰好 6,000 张图像:
- 增强管线(
source):gemini:基于 Gemini Flash 2.0 的生成式图像到图像重渲染(学习型、逼真的天气合成)。automold:基于 Automold 库的程序化计算机视觉增强(经典天气效果)。
- 天气条件(
weather):foggy(雾)、rainy(雨)、snowy(雪)。
目标类别(BDD100K 10类检测分类法)
YOLO class_id(0索引) |
COCO category_id(1索引) |
类别名称 |
|---|---|---|
| 0 | 1 | bike |
| 1 | 2 | bus |
| 2 | 3 | car |
| 3 | 4 | motor |
| 4 | 5 | person |
| 5 | 6 | rider |
| 6 | 7 | traffic light |
| 7 | 8 | traffic sign |
| 8 | 9 | train |
| 9 | 10 | truck |
使用场景与注意事项
- 设计目的:该数据集旨在回答:“如果你用生成式或程序化方法将晴朗驾驶场景转化为恶劣天气,这些合成数据的可学习性和可迁移性有多强?” 在配套基准测试中,模型(带有 ResNet/ConvNeXt 骨干的 Faster R-CNN 和 YOLO)在真实 BDD100K 图像与 TartanAdversity 图像的混合数据上训练,然后在真实恶劣天气数据集(DAWN、ACDC、Foggy Zurich)上评估。
- 限制:
- 图像是恶劣天气的合成近似,逼真度因方法而异(生成式 vs 程序化)。
- 继承自 BDD100K 的地理、相机、类别平衡和时段分布偏差。
- 仅提供单一训练集,无原生验证/测试集;评估需使用真实恶劣天气数据集。
- 标注反映原始清晰场景的标签;严重的天气效果可能会遮挡部分被标注的目标。
- 加载提示:如果
load_dataset卡住,建议设置环境变量HF_HUB_DISABLE_XET=1以强制使用普通 HTTPS 下载。
许可与引用
- 许可协议:CC-BY-4.0。数据集衍生自 BDD100K,用户需同时遵守 BDD100K 的原始使用条款并引用。使用时需注明 TartanAdversity(卡内基梅隆大学)和 BDD100K。
- 引用:使用本数据集时,建议引用 TartanAdversity、BDD100K、Gemini Flash 2.0 以及 Automold 库。