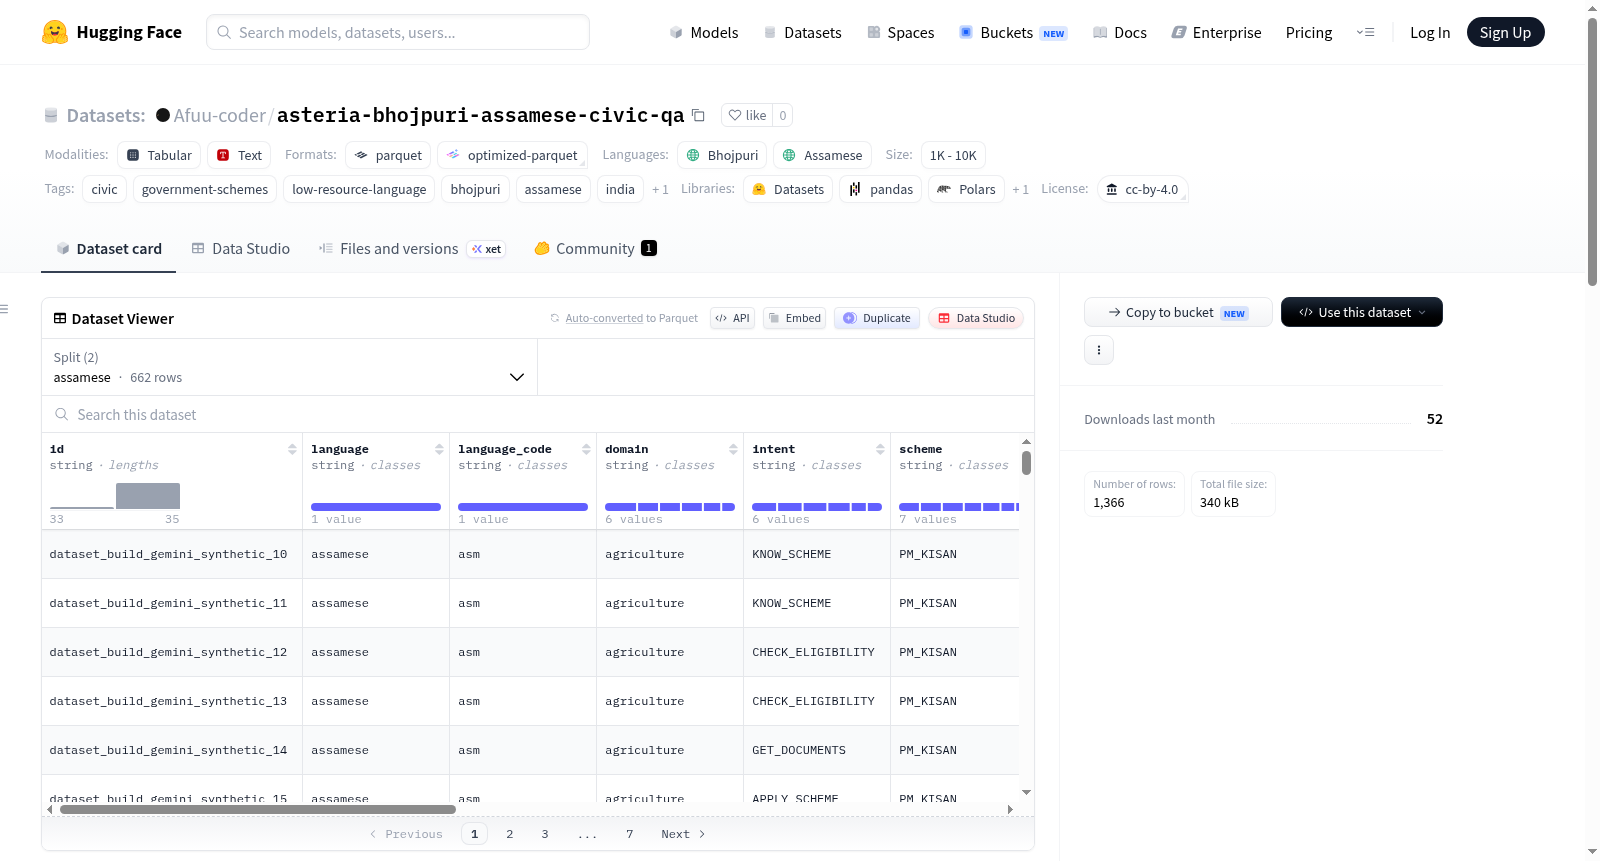
asteria-bhojpuri-assamese-civic-qa
收藏资源简介:
Asteria是一个包含博杰普尔语和阿萨姆语政府计划问答对的数据集,专注于两种低资源的印度语言。该数据集由Asteria AI代理在AI Agents Hackathon 2026期间收集,旨在通过使用用户母语进行对话,帮助印度农村公民了解和获取政府福利计划。数据集覆盖两种主要语言:博杰普尔语(在比哈尔邦、北方邦、贾坎德邦使用,使用者超过5000万人)和阿萨姆语(在阿萨姆邦使用,使用者超过1500万人)。内容涵盖多个关键的政府计划领域,包括农业(如PM Kisan、Fasal Bima)、医疗(Ayushman Bharat)、住房(PM Awas Yojana)、能源(Ujjwala Yojana)、金融(Jan Dhan)和食品安全(Ration Card)。每个样本包含用户用博杰普尔语或阿萨姆语提出的问题、AI代理用同种语言给出的回答、语言名称、语言ISO代码、计划所属领域、用户意图(如申请计划、检查资格、获取文件等)、具体的政府计划名称,以及四个人工评估分数:事实准确性、语言质量、帮助性和整体质量,每个分数范围为0-10。数据集规模为小于1000个样本。该数据集适用于低资源语言处理、面向公民服务的AI代理开发、多语言问答系统以及政府信息可及性等研究与应用场景。
Asteria is a dataset containing question-answer pairs on government schemes in Bhojpuri and Assamese languages, focusing on two low-resource Indian languages. The dataset was collected by the Asteria AI agent during the AI Agents Hackathon 2026, aiming to help rural citizens in India understand and access government welfare schemes through conversations in their native languages. The dataset covers two main languages: Bhojpuri (bho, used in Bihar, Uttar Pradesh, Jharkhand, with over 50 million speakers) and Assamese (asm, used in Assam, with over 15 million speakers). The content spans multiple key government scheme domains, including agriculture (e.g., PM Kisan, Fasal Bima), healthcare (Ayushman Bharat), housing (PM Awas Yojana), energy (Ujjwala Yojana), finance (Jan Dhan), and food security (Ration Card). Each sample includes fields such as the users query in Bhojpuri or Assamese, the AI agents response in the same language, language name, language ISO code, domain of the scheme, user intent (e.g., applying for a scheme, checking eligibility, obtaining documents), specific government scheme name, and four human evaluation scores: factual accuracy, language quality, helpfulness, and overall quality, each on a scale of 0-10. The dataset size is less than 1000 samples (n<1K). It is suitable for research and applications in low-resource language processing, AI agent development for citizen services, multilingual question-answering systems, and government information accessibility.
数据集概述
Asteria — Bhojpuri & Assamese Civic Q&A Dataset 是一个面向政务领域的双语问答数据集,特别针对 Bhojpuri(博杰普尔语) 和 Assamese(阿萨姆语) 这两种低资源印度语言。
- 语言:博杰普尔语 (bho)、阿萨姆语 (asm)
- 许可证:Creative Commons Attribution 4.0 International (CC BY 4.0)
- 规模:少于1000个样本 (n<1K)
- 创建者:Asteria(为 AI Agents Hackathon 2026 构建的 AI Agent)
数据集内容
该数据集包含在博杰普尔语和阿萨姆语中提出的用户问题与 AI Agent 回复的配对,覆盖多个政府福利计划领域:
- 农业:PM Kisan、Fasal Bima
- 医疗保健:Ayushman Bharat
- 住房:PM Awas Yojana
- 能源:Ujjwala Yojana
- 金融:Jan Dhan
- 食品安全:Ration Card
数据字段
每条记录包含以下字段:
query:用户的博杰普尔语/阿萨姆语问题response:AI Agent 的同语言回复language:语言名称 (bhojpuri/assamese)language_code:ISO 语言代码 (bho/asm)domain:方案所属领域intent:用户意图(如 APPLY_SCHEME、CHECK_ELIGIBILITY、GET_DOCUMENTS)scheme:政府方案名称eval_factual:事实准确性评分 (0-10)eval_language:语言质量评分 (0-10)eval_helpfulness:帮助度评分 (0-10)eval_overall:总体质量评分 (0-10)
技术构建
- 数据平台:Adaptive Data by Adaption(用于数据摄取、评估和管理)
- AI 模型:Gemini 1.5 Flash(作为 AI agent 骨干)
- 记忆系统:ChromaDB(用于 RAG 记忆,支持持续改进)