HiTZ/magpie-en-eu-reasoning-instructions-qwen3
收藏资源简介:
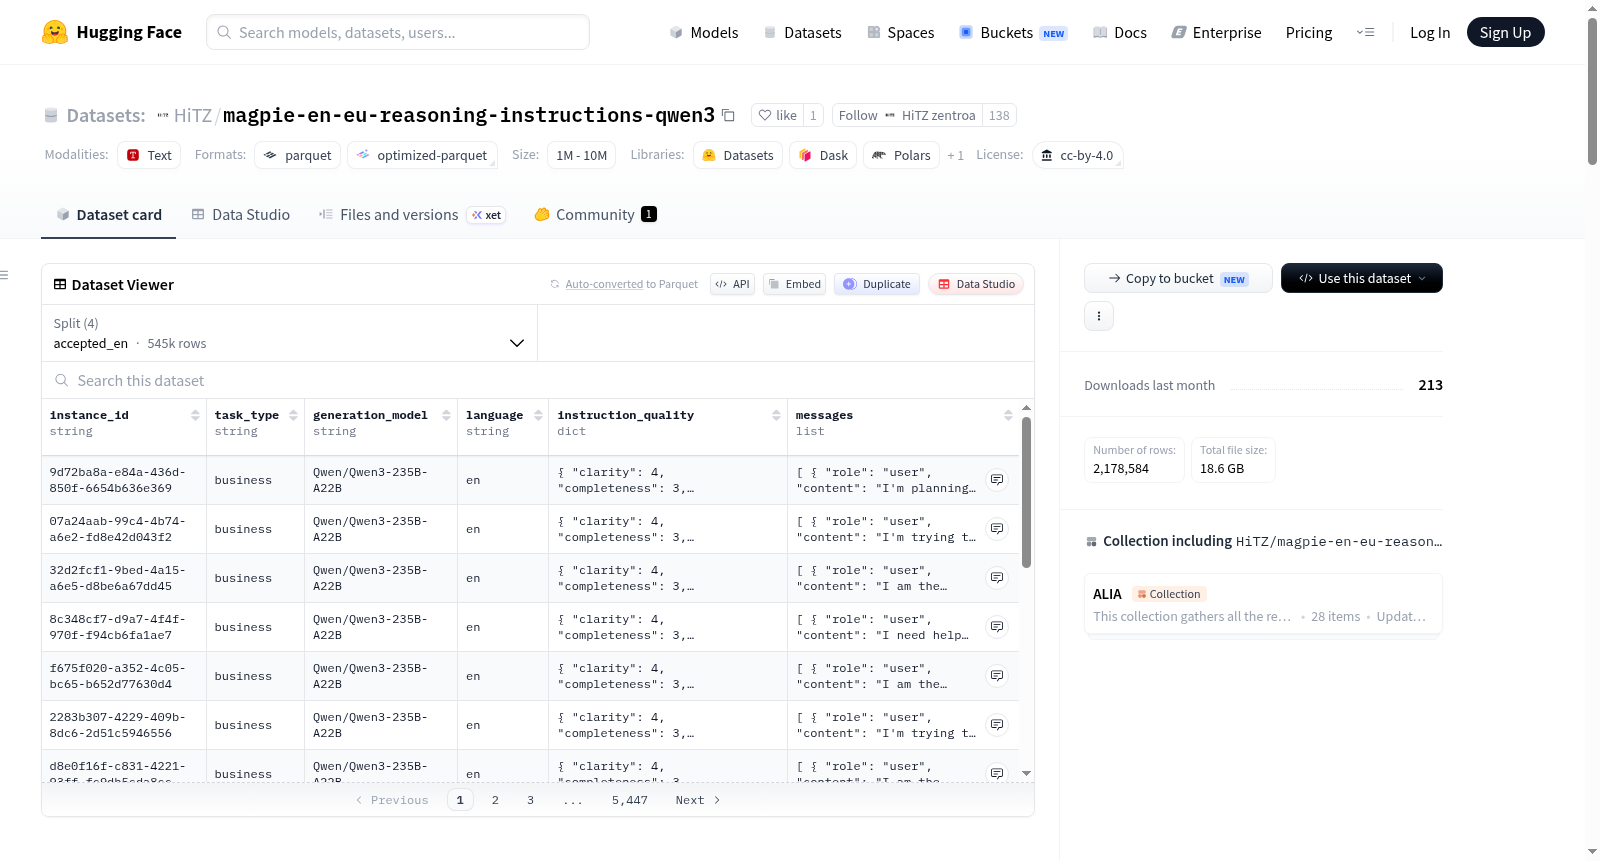
magpie-en-eu-reasoning-instructions-qwen3数据集是一个由HiTZ中心开发的大规模、高质量双语指令和偏好数据集,专门用于训练、对齐和评估英语和巴斯克语(Euskera)的推理型大语言模型。该数据集采用自合成的Magpie方法构建,包含总计100万条指令(英语和巴斯克语各50万条),每条指令对应两个响应(一个被接受为高质量,一个被拒绝为低质量),总计200万个响应。独特之处在于,所有响应都包含逐步推理轨迹,以支持模型的推理能力提升。数据集覆盖14个类别,如翻译、科学、安全、创意写作等,并通过自动化质量评估确保指令质量。响应由不同规模的模型生成:被接受响应来自Qwen3-235B-A22B模型,被拒绝响应来自Qwen3-32B模型。巴斯克语部分通过专门调整的模型进行本地化处理,并经过人工评估以确保语言准确性。该数据集适用于偏好对齐(如DPO、ORPO)、推理能力训练和双语模型增强。
The magpie-en-eu-reasoning-instructions-qwen3 dataset is a large-scale, high-quality, bilingual instruction and preference dataset developed by the HiTZ Center. It is specifically tailored for training, aligning, and evaluating reasoning-focused Large Language Models (LLMs) in both English and Basque (Euskera). Built using the self-synthesizing Magpie methodology, the dataset contains a total of 1,000,000 instructions (500,000 in English and 500,000 in Basque). For preference alignment, every instruction is paired with two responses (one chosen, one rejected), totaling 2,000,000 responses. Uniquely, as this dataset targets reasoning models, both responses include explicit step-by-step reasoning traces. Instructions are curated across 14 distinct categories, such as translation, science, safety, and creative writing, with rigorous automated quality control. Responses are generated by models of different capacities: chosen responses from Qwen3-235B-A22B and rejected responses from Qwen3-32B. Basque content is localized using a specialized adapted model and manually evaluated for accuracy. The dataset is designed for preference alignment (e.g., DPO, ORPO), reasoning capability training, and bilingual model enhancement.