
遇见数据集

emiliocantuc/maze-30x30-hard-1k

收藏
Hugging Face2026-05-28 更新2026-05-31 收录
官方服务:

资源简介:

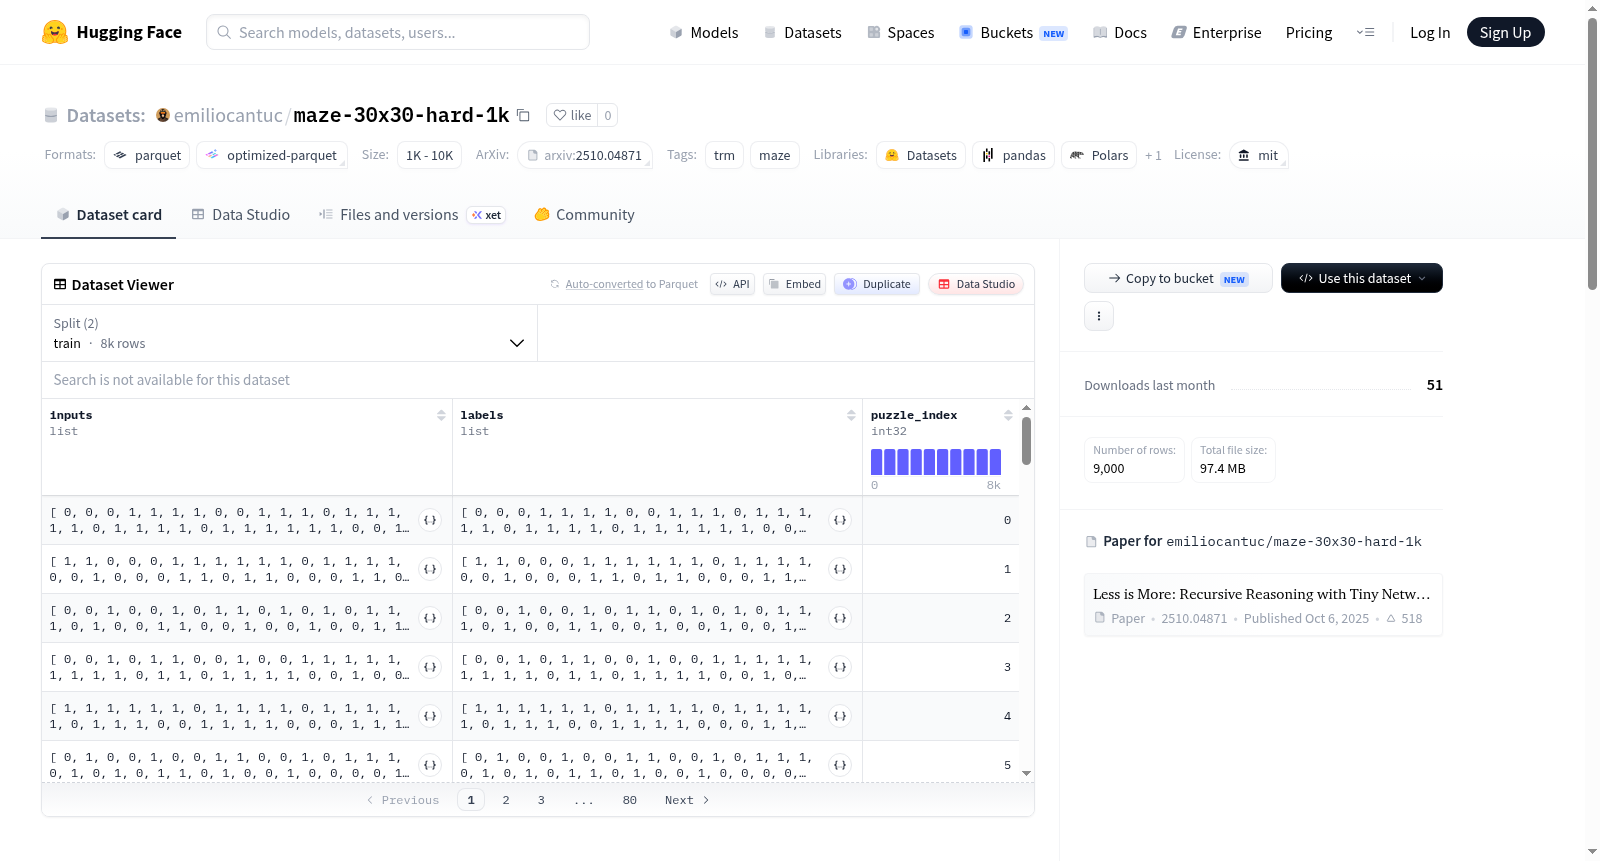
该数据集名为maze-30x30-hard-1k,用于Tiny Recursion Models (TRM)论文研究。它包含30x30大小的硬迷宫实例,每个迷宫由900个单元格组成(序列长度seq_len=900),词汇表大小为5。数据集包括训练集(8000个示例)和测试集(1000个示例)。每个示例具有三个特征:inputs(uint8类型,表示迷宫输入状态)、labels(分类标签,对应迷宫元素:#墙编码为0、空格/开放单元格编码为1、S起点编码为2、G目标编码为3、o解决方案路径编码为4)和puzzle_index(int32类型,表示谜题索引)。数据集通过官方代码生成,并经过数据增强处理,适用于迷宫求解和递归模型训练任务。

This dataset, named maze-30x30-hard-1k, is used in the Tiny Recursion Models (TRM) paper. It consists of hard maze instances of size 30x30, with each maze comprising 900 cells (sequence length seq_len=900) and a vocabulary size of 5. The dataset includes a training set (8,000 examples) and a test set (1,000 examples). Each example has three features: inputs (uint8 type, representing maze input states), labels (class labels corresponding to maze elements: # wall encoded as 0, space/open cell as 1, S start as 2, G goal as 3, o solution path as 4), and puzzle_index (int32 type, indicating puzzle indices). The dataset is generated using official code with data augmentation and is suitable for maze-solving and recursive model training tasks.
提供机构:
emiliocantuc
搜集汇总
数据集介绍
emiliocantuc/maze-30x30-hard-1k 数据集图片
构建方式
该数据集源自Tiny Recursion Models(TRM)研究项目,用于评估递归模型在迷宫导航任务上的性能。数据集的构建依托于TRM官方代码库中的生成脚本,通过执行`python dataset/build_maze_dataset.py --aug`命令,首先生成1000个基础迷宫样本,随后利用数据增强技术将样本数量扩展至9000个。每个迷宫均为30x30的网格结构,包含墙壁、空地、起点、终点及解路径五种元素。原始数据取值范围为1至5,为便于模型处理,最终将所有数值统一减1,映射为0至4的整数序列。数据集最终被划分为训练集(8000条)和测试集(1000条),并以HuggingFace Datasets格式进行存储与共享。
特点
该数据集的核心特点在于其迷宫的高复杂性以及元素编码的标准化设计。迷宫的尺寸固定为30x30,序列长度为900,词汇表大小为5,确保了数据结构的一致性。每个样本均包含输入(inputs)和标签(labels)两个部分,标签采用分类标签格式,分别对应墙('#')、空地(' ')、起点('S')、终点('G')和解路径('o')五种语义类别。数据集中还引入了`puzzle_index`字段,用于记录样本归属的原始迷宫索引,便于追溯与分组。这种精细化的标注方式使得数据集不仅可用于监督学习下的路径预测任务,同时也适用于评估模型对结构化空间信息的理解与生成能力。
使用方法
在使用该数据集时,开发者可直接通过HuggingFace Datasets库加载,加载命令为`load_dataset('emiliocantuc/maze-30x30-hard-1k')`,即可获得包含训练集和测试集的DatasetDict对象。每个样本的`inputs`为长度为900的uint8类型数组,`labels`为同样长度为900的分类标签数组,`puzzle_index`为整型标识符。为适配模型训练,需预设参数`seq_len=900`和`vocab_size=5`。该数据集适用于序列到序列的迷宫求解任务,研究者可基于TRM或Transformer等递归架构进行模型训练,并通过预测结果与标签的对比评估导航准确性。详细的代码示例可在TRM的JAX实现仓库中找到。
背景与挑战
背景概述
迷宫求解作为经典的计算问题,长期以来被用于评估递归模型在复杂序列预测与路径规划中的能力。maze-30x30-hard-1k数据集由Samsung SAIL Montreal团队在Tiny Recursion Models (TRM) 论文中提出,发表于2025年,旨在提供高难度的30x30迷宫样本,用于测试轻量级递归模型的泛化性能。该数据集包含9000个样本(8000训练、1000测试),每个样本将迷宫编码为30x30的网格,其中墙壁、空白、起点、终点与解路径以0至4的离散值表示。研究核心问题在于:在参数规模极小的情况下,递归模型能否有效学习并推理解码复杂迷宫的拓扑结构。该数据集因其对模型递归深度的严苛要求,已成为评估递归架构泛化能力的基准之一。
当前挑战
数据集的构建面临多重挑战。在领域问题层面,迷宫求解本质上是非确定性的图搜索问题,传统模型需依赖回溯或全局规划,而递归模型须从序列化输入中隐式捕捉空间连通性,这对长程依赖建模提出了极高要求。硬迷宫(hard级别)的设计刻意引入了死胡同与冗余路径,使得模型难以通过简单模式匹配完成解码。在构建过程中,作者通过数据增强生成1000个基础迷宫并应用8种扩展变换,但需确保增强后的迷宫解具有唯一性且未破坏拓扑结构。此外,将原始1到5的值编码平移至0到4以兼容标准分词器,同时保持解路径与墙体的语义独立性,这一预处理步骤需严谨验证以避免信息丢失。最终数据集在MIT许可下发布,旨在推动递归模型在结构化推理任务中的发展。
常用场景
经典使用场景
迷宫路径规划是人工智能与认知科学交叉领域中的经典问题,旨在通过算法在障碍物密布的网格空间中寻找从起点至终点的可行路径。maze-30x30-hard-1k数据集专为训练和评估递归神经网络(尤其是Tiny Recursion Models, TRM)而设计,其核心使用场景是将迷宫求解建模为序列预测任务。每个30×30的迷宫网格被展平为900个栅格单元的序列,每个单元以数字标签表示墙壁、空地、起点、终点或解路径,模型需学会根据输入状态逐步预测出正确的解路径标签。该数据集包含8000个训练样本与1000个测试样本,所有迷宫均为通过数据增强生成的困难实例,旨在挑战模型在复杂障碍布局下的递归推理与长程依赖建模能力。
实际应用
尽管该数据集源于基础算法研究,但其蕴含的序列决策与规划能力在众多实际领域中具有广阔的应用前景。在机器人导航中,基于迷宫求解策略的模型可直接迁移至未知环境下的路径规划,帮助机器人避开实时障碍物并高效到达目标点。在游戏开发中,该技术可用于自动生成或动态调整关卡中的智能体寻路行为,提升玩家体验。此外,在物流仓储系统的自动导引小车(AGV)调度、管线巡检无人机航线规划乃至蛋白质折叠路径推理等复杂场景中,所习得的递归推理能力均可为解决类似迷宫式搜索问题提供高效解决方案。
衍生相关工作
maze-30x30-hard-1k数据集脱胎于Tiny Recursion Models(TRM)的研究工作,在提出该数据集的同时,研究者开发了相应的递归建模方法,并开源了完整的训练与推理代码库。以此为基础,后续工作探索了将TRM应用于更广泛的符号推理与规划任务,例如算术表达式求值与定理证明。该数据集还催生了对递归神经网络的记忆机制与注意力机制的改进研究,激发了社区在迷你化算法模型方向上的创新,并为比较不同架构(如Transformer与状态空间模型)在递归任务上的表现提供了共享基准,从而形成了一个围绕小型但高难度的序列预测问题的活跃研究生态。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

