
遇见数据集

small-models-for-glam/index-card-detection-v5

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

该数据集是Archival Index Card Detection — mixed collections (5版本,集成重新标记海军数据),是一个用于档案索引卡片检测的混合集合数据集。它是v3版本的改进版本,包含1,425行数据,来自多个来源集合(包括NLS Advocates、Navy Nurse Corps、BPL Catalog和Rubenstein Manuscript)。主要改进在于对25行海军多卡片扫描的边界框进行了重新标记:通过运行v3和v4两个模型,在低置信度阈值下生成检测结果,使用IoU-NMS合并检测,并进行人工审查以修正分歧。最终边界框质量更高,标签来源包括v3+v4一致、v3仅、v4仅或human调整。数据集结构包括图像、来源集合、边界框(xywh格式)、类别(固定为card)和边界框来源等字段。用于训练对象检测器以在全页、多卡片图像或预裁剪单卡片图像中定位档案索引卡片,但仅限于检测任务(不包含OCR)、单类别、英文和英美档案惯例。数据集由Hugging Face的机器学习图书馆员Daniel van Strien策划,许可证混合(依据来源集合不同)。

Refined version of [`small-models-for-glam/index-card-detection-v3`](https://huggingface.co/datasets/small-models-for-glam/index-card-detection-v3). All NLS / BPL / Rubenstein rows are passed through unchanged. The 25 navy-nurse-corps rows have their bounding boxes **re-labelled via a v3+v4 model ensemble plus human review**, replacing the SAM3-only bootstrap from v3. Same 1,425-row mixed-collection composition as v3. The only difference: the 25 navy multi-card scans now use higher-quality bounding boxes produced by: 1. Running both `small-models-for-glam/index-card-detector-v3` and `small-models-for-glam/index-card-detector-v4` on each navy image (per-model conf threshold 0.10). 2. Greedy IoU-NMS at 0.5 to merge near-duplicate detections from the two models, recording which models contributed to each surviving box (`box_source = "v3+v4"`, `"v3"`, or `"v4"`). 3. Human review in a custom HTML bbox editor, prioritising rows where the two models disagreed (rows with `v3`-only or `v4`-only boxes appeared first in the review queue). Outcome: 86 raw ensemble boxes (83 unanimous + 3 disagreement), reduced to 84 after one envelope-style v4 artefact was removed and 2 boxes were structurally adjusted.
提供机构:
small-models-for-glam
搜集汇总
数据集介绍
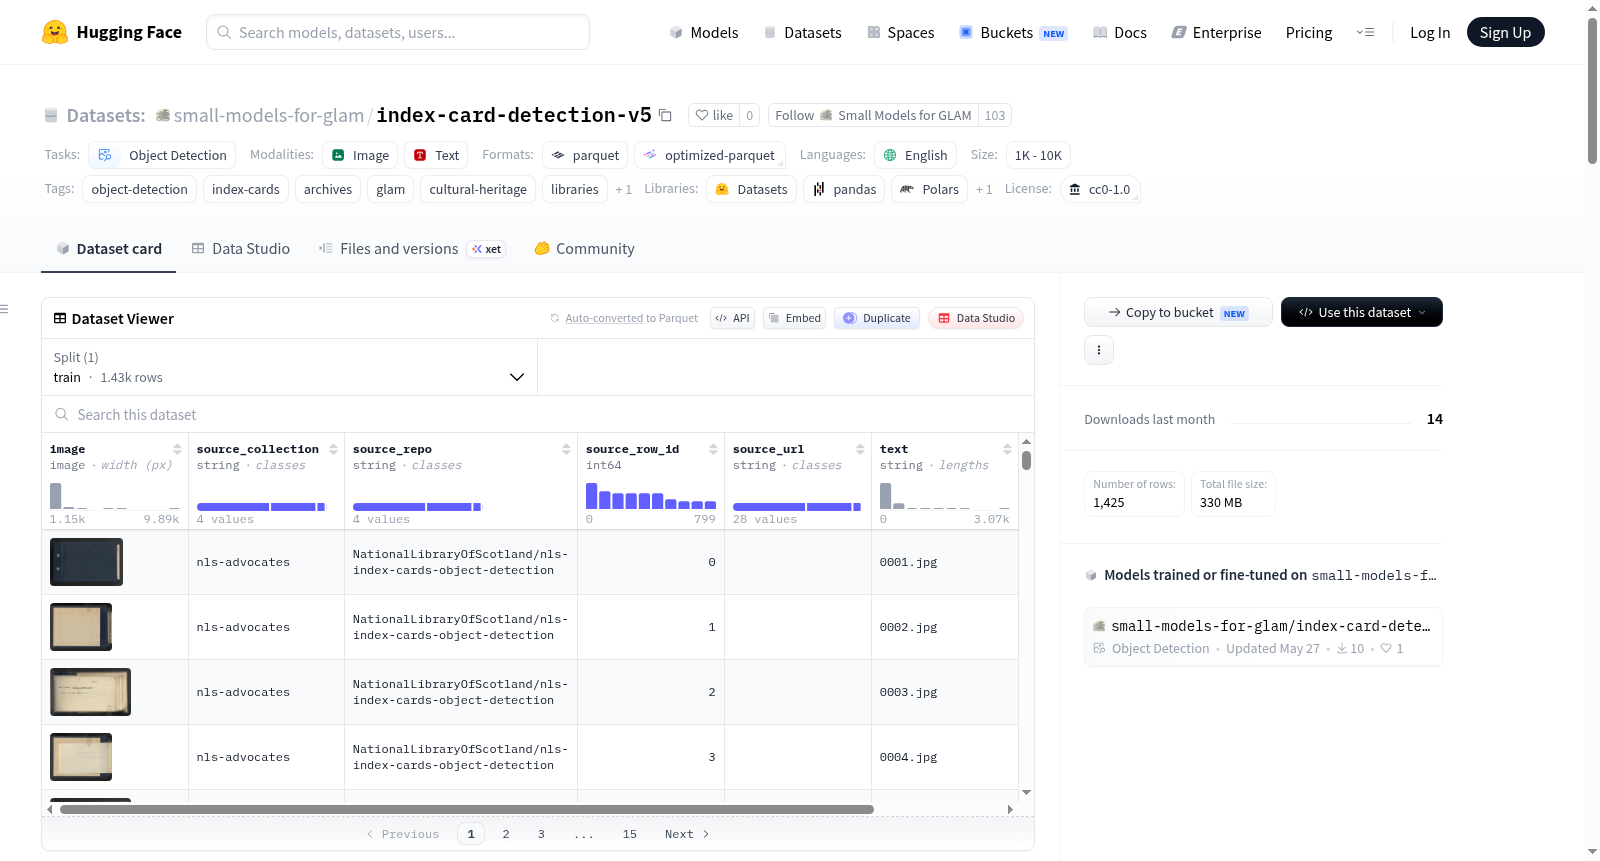
small-models-for-glam/index-card-detection-v5 数据集图片
构建方式
该数据集是面向档案索引卡检测任务的精细化版本,基于v3版本优化而来。核心改进在于对海军护士军团(navy-nurse-corps)子集中的25张多卡扫描图像,采用了v3与v4模型集成加人工审核的重新标注流程:首先以0.10置信度阈值运行两个模型,通过IoU-NMS(0.5阈值)合并检测结果并标记来源;随后在自定义HTML边界框编辑器中优先审查模型存在分歧的行,最终经人工校正移除伪影并调整框位,生成了高质量边界框,而其他三个来源(NLS、BPL、鲁宾斯坦手稿)的1400行数据保持不变。
特点
本数据集融合了五个来源的1425条档案索引卡图像,涵盖图书馆、档案馆等文化遗产机构的多样化扫描场景。其独特之处在于为海军子集引入了集成标注策略,通过模型间共识与人工干预相结合的方式,提升了多卡图像的标注精确度,同时保留了NLS的原始边界框以及BPL和鲁宾斯坦的规则式全图标注。类别单一聚焦于卡片检测,支持原始分辨率RGB图像,并详细记录了每张框的标注来源(如v3+v4统一、人工修正等),便于追溯标注质量。
使用方法
该数据集可直接用于训练目标检测模型,以定位完整页面、多卡纸或单卡图像中的档案索引卡。数据模式与v3版本一致,包含图像、来源集合、标注框等信息,用户可通过HuggingFace datasets库加载,并利用标注列“objects.bbox”与“objects.category”进行模型训练。需注意其仅面向英文与英美档案惯例的单类检测任务,不适用于OCR或多类识别场景。
背景与挑战
背景概述
在文化遗产数字化与GLAM(美术馆、图书馆、档案馆、博物馆)领域,档案索引卡的自动检测是构建大规模数字人文基础设施的关键环节。这些历经数十甚至上百年积累的纸质卡片,承载着珍贵的元数据信息,却因物理形态的多样性和历史图像质量的参差不齐,难以高效地转化为结构化数据。2026年,由Hugging Face机器学习馆员Daniel van Strien主导的Archival Index Card Detection — v5数据集应运而生。该数据集整合了来自苏格兰国家图书馆、美国海军护士团、波士顿公共图书馆及鲁宾斯坦手稿馆的1425条记录,专注于解决多源、多风格档案卡片的目标检测问题。通过融合模型集成与人工审核的标注精炼策略,v5版本在保持前代数据集核心结构的同时,显著提升了海军护士团子集中边界框的质量,为数字人文与计算机视觉的交叉研究提供了宝贵的基础资源。
当前挑战
档案索引卡的自动检测面临多重领域性难题。首先,各收藏机构的索引卡在布局、字体、纸张退化程度及拍摄角度上差异巨大,而现有数据集的多卡片图像样本仅集中于25张海军护士团图像,模型难以泛化到未见的多种卡片排列模式。其次,数据集的标注来源多元——国家图书馆的原始框、海军子集的模型集成标注、以及波士顿公共图书馆与鲁宾斯坦馆的整图自动框——导致标签质量与语义一致性存在断层,特别是后两者未经人工验证,可能引入噪声。构建过程中,v5尝试通过v3与v4模型集成加上人工复查来优化海军子集,但集成过程暴露了模型间对模糊区域的歧见(如信封状伪影),人工修正虽提升了局部精度,却未能解决先前版本中英国与美国档案惯例的差异、缺乏真正负样本、以及非卡片内容的干扰等根本性局限。
常用场景
经典使用场景
在文化遗产数字化与文献智能处理的交叉领域中,档案索引卡片作为承载历史信息的关键载体,其自动化定位是后续光学字符识别与信息抽取的前提。该数据集专为训练目标检测模型而构建,旨在从扫描的完整书页、多卡片混合版面或单卡片图像中精确识别并框出索引卡片的边界。其经典用法聚焦于监督学习框架下的单类目标检测任务,研究人员可基于YOLO、Faster R-CNN或DETR等检测架构,利用该数据集提供的1,425张精选图像及其精细标注——包括来自NLS的多卡片高密度版面、美国海军护士军团藏品中的密集排列场景、BPL与Rubenstein的大幅书页——训练模型捕捉卡片与背景间的语义差异,从而在复杂的档案扫描中实现高召回率的卡片定位。
衍生相关工作
该数据集的迭代过程直接催生了多个经典工作:其前身v3版本锻炼出的检测器被用于生成v4模型的训练伪标签,形成自举式提升的范例;v5版本进一步通过集成v3与v4的预测结果并结合人工审核,验证了模型协同校订优于单一模型再标注的策略。在模型层面,基于该数据集开源的`index-card-detector-v5`权重——源于微调的YOLOv8架构——已成为GLAM(美术馆、图书馆、档案馆与博物馆)社区中索引卡片检测的标准基线。研究团队还借鉴该流水线推广至相似域,如名片自动化检测、历史活页乐谱的乐谱页分割等。此外,该数据集的标注策略文档与混合来源协议(CC0、无限制使用等)为后续文化遗产数据集构建者提供了可复用的伦理与版权模板,尤其是对公有领域与机构藏品混合授权的处理方式被多个欧洲数字图书馆项目所采用。
数据集最近研究
最新研究方向
该数据集的最新研究方向聚焦于提升档案索引卡目标检测任务的标签质量,通过模型集成与人工审核协同的标注优化技术。研究核心在于利用v3与v4检测器的集成预测结果,结合交并比非极大值抑制(IoU-NMS)融合检测框,并对模型分歧区域执行针对性的人工修正。这一方向显著缓解了早期版本中海军护士团影像标注依赖于单一SAM3分割模型所引入的系统性偏差,推动档案数字化进程中自动化标注精度的迭代升级。当前前沿探讨已从单一模型的自举标注转向多模型共识与专家审核相结合的混合范式,其意义在于为文化遗产领域(GLAM)中结构化文档的通用目标检测基准提供更可靠的监督信号,后续可能衍生出面向多模态档案数据的主动学习与持续优化框架。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

