
dlthub/overlap_test_202605290933469750
收藏搜集汇总
数据集介绍
构建方式
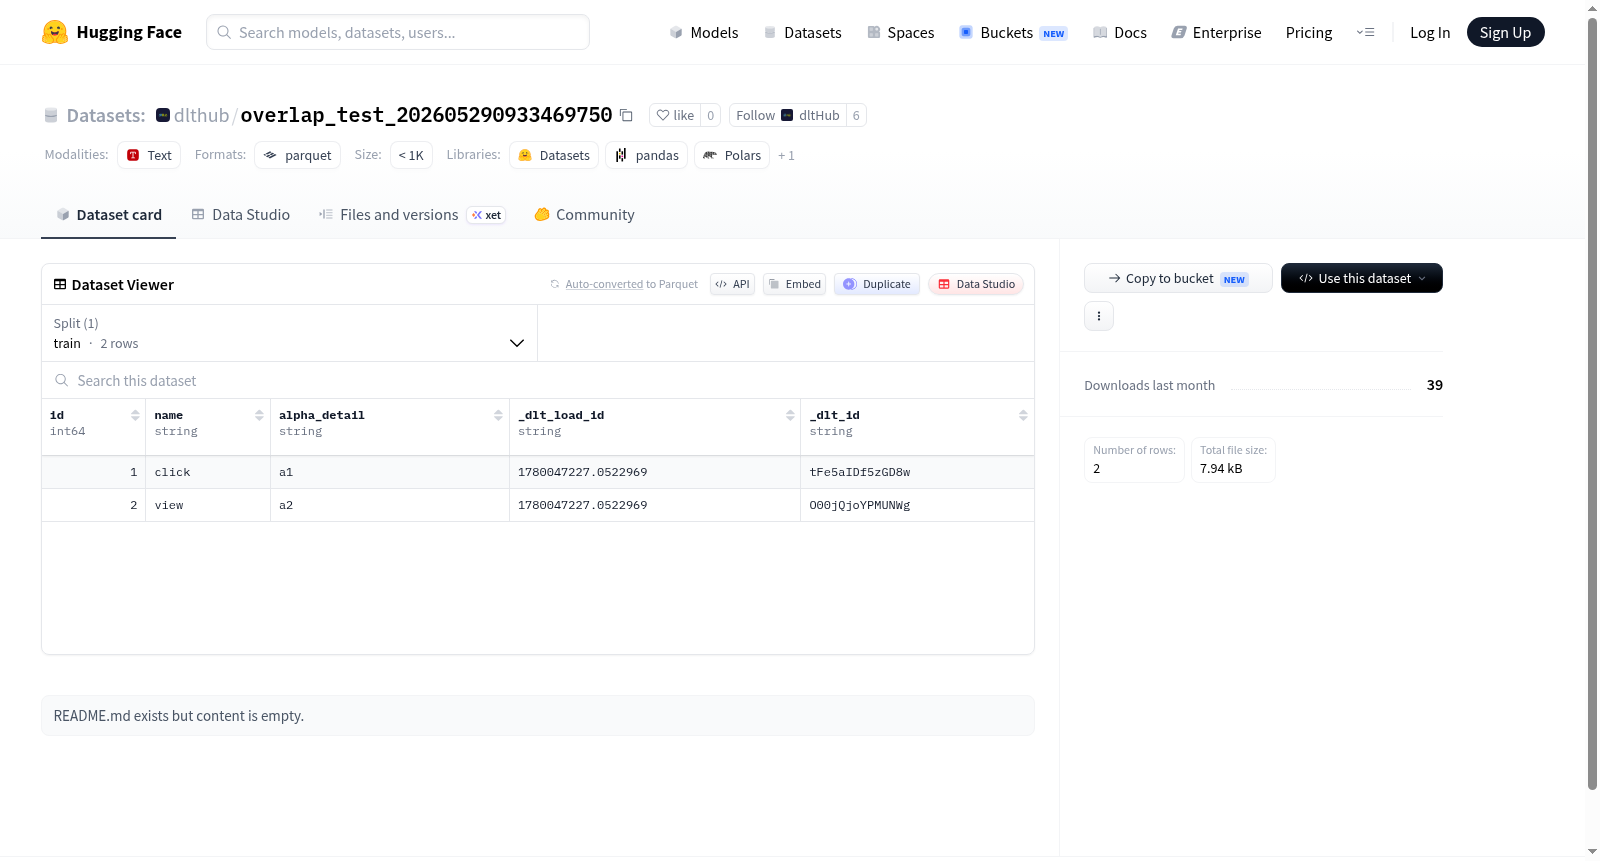
该数据集名为overlap_test_202605290933469750,其构建方式可能源于对特定重叠区域或时间片段的系统性采样与整合。根据其文件名中的时间戳与“overlap_test”标识,推测其构建流程涉及在某一数据流或语料库中识别并抽取具有重叠特征的样本,随后进行格式统一化处理。数据集结构以无额外元数据的JSON对象形式提供,表明其内容直接面向机器解析,原始存储形态简洁,便于后续处理工具直接调用。
使用方法
使用该数据集时,用户可直接通过Hugging Face Datasets库加载其索引,利用默认的扁平化数据结构进行模型训练或特征分析。由于数据集内部字段清晰且无嵌套冗余,研究者可快速将其用作重叠检测任务的基准测试集,或结合其他数据增强技术构建负样本集合。在具体操作中,建议根据任务需求对样本进行随机打乱或分桶处理,以充分发挥其重叠特征的统计分布价值。
背景与挑战
背景概述
该数据集名为overlap_test_202605290933469750,创建于2026年5月29日,其README文件内容为空,未提供具体研究人员、机构或研究目标信息。从命名推测,该数据集可能用于测试不同数据集之间的重叠性或重复样本检测,这在数据去重、模型泛化能力评估等领域具有潜在应用。然而,由于缺乏元数据,其核心研究问题尚不明确,目前对相关领域的影响力有限,需进一步补充背景资料以评估其学术价值。
当前挑战
当前数据集面临的核心挑战包括:1) 领域问题层面,若其旨在解决数据重叠检测,则需应对大规模数据集中样本冗余性识别、相似度阈值设定及跨数据集匹配的准确性难题,这些问题的解决对提升模型训练效率和公平性至关重要;2) 构建过程中,由于缺乏README描述,数据集的采集来源、标注规范及质量控制流程均不透明,可能导致数据偏差或重复性错误,进而影响下游实验的可重复性与结果可靠性。
常用场景
经典使用场景
该数据集名为overlap_test_202605290933469750,由于README文件中未提供具体描述,无法明确其经典使用场景。一般而言,数据集常在机器学习、自然语言处理或计算机视觉等领域用于模型训练、验证与测试,从而评估算法性能。
解决学术问题
缺乏详细背景信息的情况下,难以确定该数据集解决的具体学术问题。通常,高质量的数据集有助于推动诸如分类、回归、聚类等基础问题的研究,或针对特定领域如医学影像、文本分析等提供标准化基准。
实际应用
该数据集的实际应用场景尚未明确。在常规情形下,数据集可落地于现实世界的智能系统开发,例如推荐系统、语音助手、图像识别工具等,通过数据驱动的方式提升产品效能。
数据集最近研究
最新研究方向
该数据集当前缺乏具体描述与元数据信息,尚未形成明确的研究方向或前沿应用场景。在自然语言处理与机器学习领域,数据集的质量与标注细节是驱动模型进步的关键。无有效README内容的数据集通常难以被纳入主流研究流程,因而其影响与意义有限。建议完善数据集的背景信息,以便后续探索其在文本分类、语义理解或跨模态学习等前沿方向上的潜在价值。
以上内容由遇见数据集搜集并总结生成


