rukopys-curated-mvp
收藏资源简介:
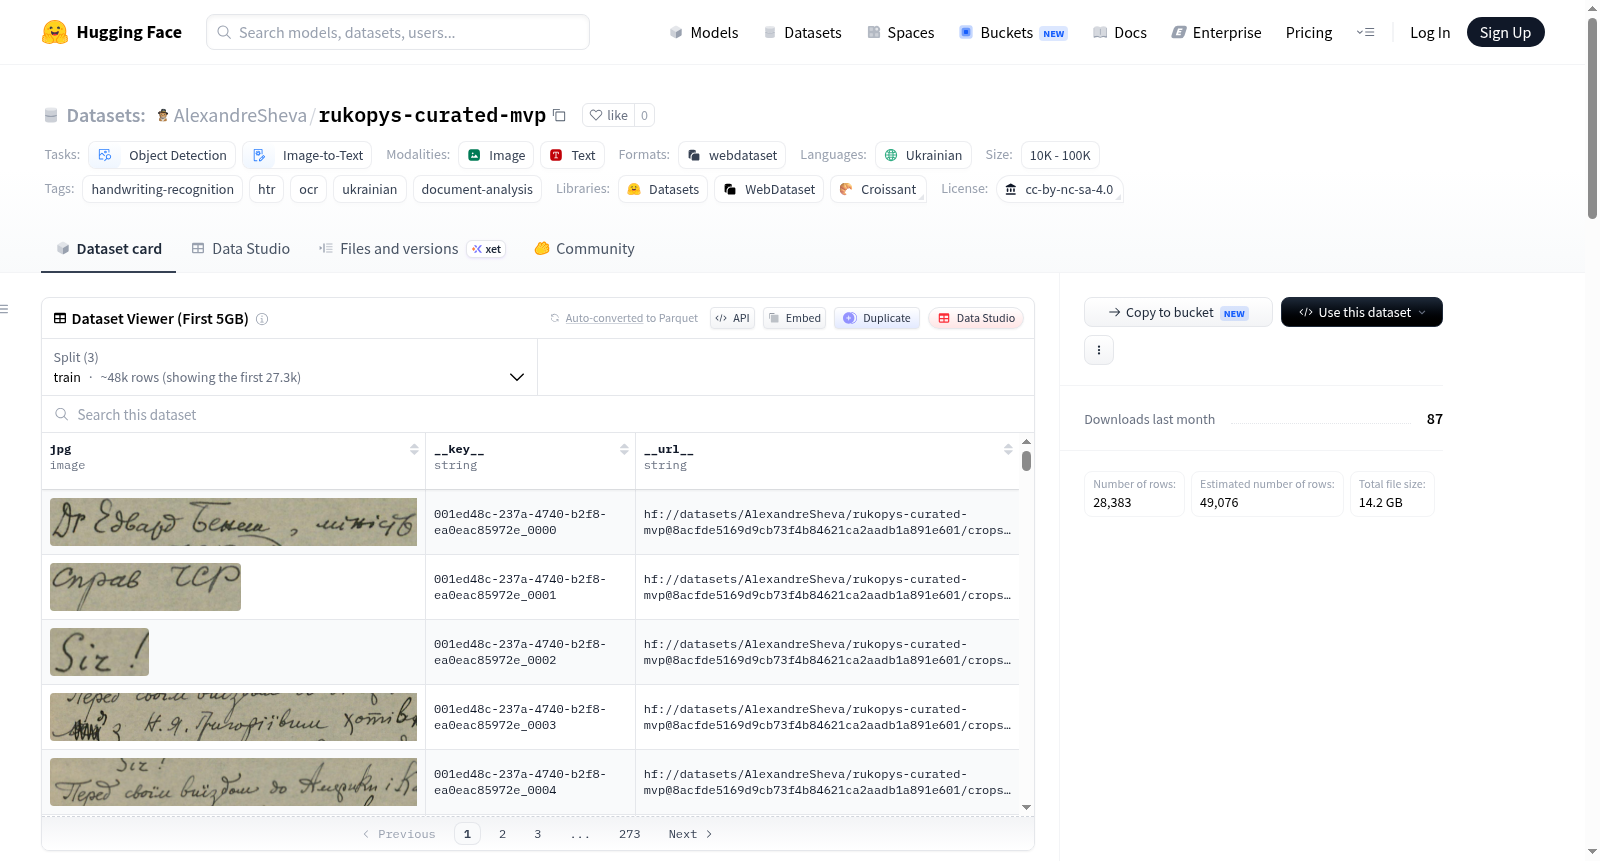
RUKOPYS Curated MVP 是一个专为乌克兰语手写文档人工智能任务设计的、经过整理的、任务就绪的数据集,源自原始RUKOPYS数据集。它旨在支持端到端的手写文本识别流程,包括数据整理、模型训练、推理和评估。数据集包含2715个页面和39420个标注区域,数据来源多样,涵盖档案(178页)、听写(509页)、学校作业(1782页)和大学材料(246页)。区域类型丰富,主要包括手写文本(31193个区域),以及公式(6174个)、表格(240个)、打印文本(477个)、注释(1145个)、图像(130个)和图表(61个)。数据集为不同标注来源(人工标注者、志愿者、自动标注)分配了质量权重(1.0、0.75、0.35)。提供多种结构化数据格式,如metadata.jsonl(标准化页面记录和区域标注)、regions.jsonl(区域详细信息)、vlm_sft.jsonl(38832个裁剪级手写文本转录示例用于训练)、page_sft.jsonl(2330个全页图像到结构化JSON示例用于全页解析微调)和yolo/目录(YOLO格式用于布局检测实验)。数据集适用于微调视觉语言模型进行手写页面解析、训练布局检测器、OCR/HTR后处理基准测试,以及演示可复现的文档AI流水线。
RUKOPYS Curated MVP is a curated, task-ready dataset designed for Ukrainian language handwritten document AI tasks, derived from the original RUKOPYS dataset. It aims to transform raw data into reproducible training artifacts to support end-to-end handwritten text recognition (HTR) workflows, covering data curation, model training, inference, and evaluation. The dataset consists of 2,715 pages and 39,420 annotated regions, with diverse sources including archives (178 pages), dictations (509 pages), school assignments (1,782 pages), and university materials (246 pages). Region types are varied, primarily comprising handwritten text (31,193 regions), along with formulas (6,174), tables (240), printed text (477), annotations (1,145), images (130), and diagrams (61). Quality weights are assigned to different annotation sources (human annotators, volunteers, automatic annotation) as 1.0, 0.75, and 0.35, respectively. The dataset offers multiple structured data formats: `metadata.jsonl` contains standardized page records and region annotations; `regions.jsonl` provides detailed information per annotated region; `vlm_sft.jsonl` includes 38,832 cropped-level handwritten text transcription examples for training; `page_sft.jsonl` contains 2,330 full-page image to structured JSON examples for full-page parsing fine-tuning; and the `yolo/` directory provides YOLO-formatted data for layout detection experiments. It may also include cropped region images (`crops/`). The dataset is suitable for tasks such as fine-tuning visual language models (VLMs) for Ukrainian handwritten page parsing, training layout detectors for handwritten document regions, benchmarking OCR/HTR post-processing with structured outputs, and demonstrating reproducible document AI pipelines from raw data to model artifacts.
数据集概述:RUKOPYS Curated MVP — 乌克兰手写识别数据集
许可证:CC BY-NC-SA 4.0
任务类别:目标检测、图像到文本
语言:乌克兰语
标签:手写识别(HTR)、光学字符识别(OCR)、文档分析
数据集简介
RUKOPYS Curated MVP 是从原始数据集 UkrainianCatholicUniversity/rukopys 衍生出的精选版本,专为乌克兰手写文档的人工智能处理而设计。它将原始发布数据转化为可复现的训练制品,支持全页视觉语言模型微调、裁剪级手写转录以及版面检测。
支持的应用场景
- 全页图像到结构化 JSON 的监督微调
- 裁剪级手写文本转录
- YOLO 格式的版面检测实验
- 区域级分析与筛选
- 可复现的模型训练与数据集打包
数据集内容
| 文件名/目录 | 说明 |
|---|---|
metadata.jsonl |
标准化的页面记录,包含图像元数据和区域标注 |
regions.jsonl |
每个标注区域一行记录 |
vlm_sft.jsonl |
裁剪级转录示例 |
page_sft.jsonl |
全页图像到结构化 JSON 的示例 |
yolo/ |
YOLO 格式的版面检测数据集 |
crops/ |
裁剪出的区域图像(若已导出) |
_pack_manifest.json |
压缩分片清单,用于打包上传至 Hub |
统计数据
| 指标 | 数量 |
|---|---|
| 页面总数 | 2715 |
| 区域总数 | 39420 |
| 裁剪 SFT 示例 | 38832 |
| 全页 SFT 示例 | 2330 |
数据来源
| 来源 | 数量 |
|---|---|
| 档案(archive) | 178 |
| 听写(dictation) | 509 |
| 学校(school) | 1782 |
| 大学(university) | 246 |
区域类型与数量
| 区域类型 | 数量 |
|---|---|
| 批注(annotation) | 1145 |
| 公式(formula) | 6174 |
| 图表(graph) | 61 |
| 手写(handwritten) | 31193 |
| 图像(image) | 130 |
| 印刷(printed) | 477 |
| 表格(table) | 240 |
质量权重
根据标注来源分配质量权重:
- 标注员(annotator):1.0
- 志愿者(volunteer):0.75
- 自动(auto):0.35
推荐用途
- 微调视觉语言模型以解析乌克兰手写页面
- 训练手写文档区域的版面检测器
- 使用结构化输出对 OCR/HTR 后处理进行基准测试
- 展示从原始数据到模型制品的可复现文档 AI 流程
原始数据集
本数据集衍生自 UkrainianCatholicUniversity/rukopys,引用格式如下:
bibtex @dataset{rukopys_2026, title = {RUKOPYS}: Ukrainian Handwritten Text Recognition Dataset, author = {Dmytro Voitekh and Volodymyr Zmiivskyyi and Oleksii Molchanovskyi}, organization = {Ukrainian Catholic University}, year = {2026}, license = {CC BY-NC-SA 4.0}, url = {https://huggingface.co/datasets/UkrainianCatholicUniversity/rukopys}, note = {First large-scale Ukrainian HTR dataset; from 1920s archival documents to 2025 school homework and exams} }